香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


带宽曲线没有跑满,并不能证明香港游戏测试服的网络没有问题;整机CPU只有30%,也不能证明计算资源充足。游戏卡顿往往发生在很短的时间窗口里:主线程来不及完成一轮逻辑更新,或者数据包到达间隔突然拉长,都会让玩家感到操作延迟、角色瞬移或状态回退,而分钟平均值可能把这些异常掩盖掉。
对游戏研发小团队,更有效的排查方式是把主线程耗时、逐核CPU、调度等待、网络时延分布、丢包、队列和业务响应时间放到同一时间轴上。服务端逻辑耗时先上升、随后消息积压,优先检查单线程计算和应用阻塞;服务端处理稳定、客户端往返时延却明显波动,优先检查链路。内存回收、磁盘等待和数据库慢查询则要作为替代解释逐项排除,而不是看到“卡顿”就增加带宽。
玩家点击技能后等待反馈,经过的不只是香港服务器的网络链路,还包括客户端发送、服务端收包、排队、逻辑处理、结果发送和客户端渲染。只记录一个“响应时间”,很难知道时间消耗在哪里。
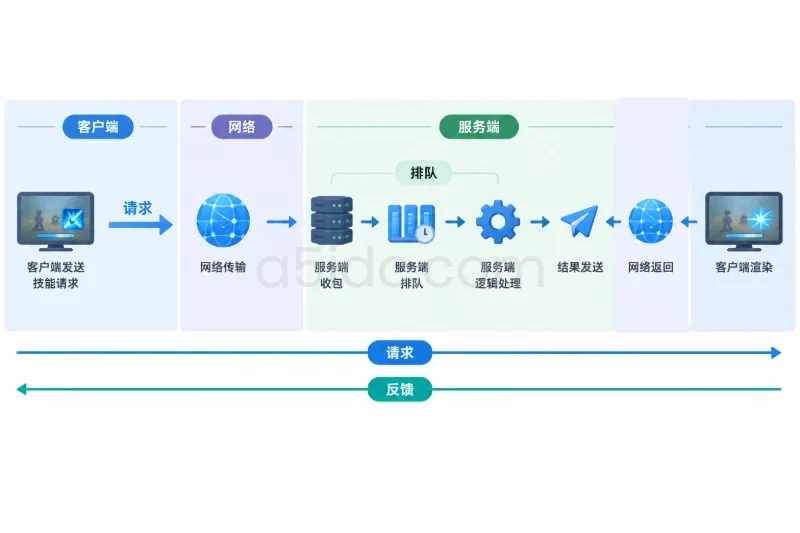
测试服至少应建立以下观察面:
| 观察面 | 建议记录的指标 | 主要回答的问题 |
|---|---|---|
| 玩家侧 | 应用层RTT、超时率、接收间隔、帧时间 | 是等待服务器,还是客户端自身掉帧 |
| 服务端应用 | Tick耗时、事件循环延迟、消息队列长度、处理耗时P95/P99 | 逻辑是否按时完成,消息是否排队 |
| CPU与调度 | 逐核利用率、主线程CPU、运行队列、steal、容器节流 | 算力不足,还是拿不到执行时间 |
| 内存与磁盘 | 可用内存、换页、内存压力、I/O延迟、I/O队列 | 是否被回收、换页或持久化拖慢 |
| 网络与依赖 | 吞吐、包速率、丢包、重传、数据库耗时与连接池等待 | 链路或下游是否引入等待 |
这里的P99表示:在对应统计窗口内,约99%的样本不超过这个值。它比平均值更容易暴露少量严重卡顿,但必须同时保留样本数量。一个窗口只有十几次请求时,P99并不足以代表稳定的尾延迟水平。
对于持续数秒的故障,1秒粒度的系统指标通常有助于定位;对于几十毫秒的Tick超时,仅靠1秒CPU曲线仍不够,需要应用逐Tick计时,或者生成短窗口耗时直方图。
小团队可以从一个轻量观察窗口开始:
香港测试服尤其需要区分不同玩家接入路径。同一时间,某地区某运营商的玩家卡顿、其他测试人员正常,与所有玩家同时卡顿,指向的候选原因不同。
跨机器事件关联依赖时钟对齐,单次处理耗时依赖本机单调计时。没有可靠时钟同步,不宜直接用两台机器的时间戳相减推算单向网络时延。
许多游戏服务存在主逻辑线程:房间状态更新、碰撞处理、战斗结算等任务,不能简单地平均分散到所有核心。即便网络和日志有独立线程,关键逻辑仍可能受单线程执行速度限制。
在4个vCPU的实例上,若一个线程持续占满一个vCPU,其他线程负载较低,整机CPU可能只有约25%至35%。这时增加同等性能的核心数量,未必能缩短该线程完成一次逻辑更新的时间。
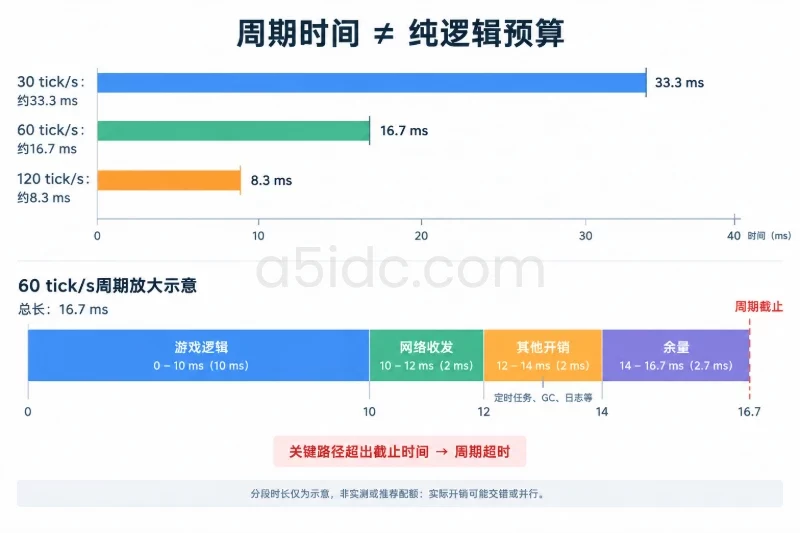
以20Hz逻辑更新为例,每轮间隔是:
1000毫秒 ÷ 20 = 50毫秒。
50毫秒是这一更新频率下的周期预算,不是建议长期贴近运行的目标。还要为突发事件、调度变化和其他任务留出余量。少数Tick越过预算,可能表现为偶发卡顿;持续超出预算,则可能引起消息队列增长、实际更新频率下降,或触发引擎自身的降级机制。
下面是一组用于解释机制的模拟数据。每行代表一个60秒观察窗口,CPU为窗口均值,Tick和RTT为窗口内的分位数;吞吐为服务器出口均值,端口限速设为100Mbps。
| 窗口 | 整机CPU | 主逻辑线程CPU | Tick耗时P99 | 消息队列变化 | 应用RTT P99 | 出口吞吐 |
|---|---|---|---|---|---|---|
| 普通房间负载 | 14% | 37% | 23ms | 基本稳定 | 68ms | 6Mbps |
| 集中战斗阶段 | 31% | 98% | 61ms | 持续增长 | 152ms | 9Mbps |
| 降低战斗事件密度后 | 17% | 46% | 29ms | 逐步回落 | 77ms | 7Mbps |
这组数据支持“主线程计算受限”这一候选判断,但不能只凭表格就确认因果。还需要查看故障窗口:是否先出现主线程忙和Tick变长,随后队列积压、客户端RTT上升。
判断单核性能不足,至少需要联动查看三类证据:
在安装了sysstat的Linux环境中,可用以下只读命令做初步观察。先用pgrep -a核对真实进程,再将示例PID替换为目标进程PID:
mpstat -P ALL 1 60
pidstat -t -u -w -p 12345 1 60
mpstat用于观察逐CPU状态;pidstat用于查看线程CPU与上下文切换。不同工具的CPU百分比归一化方式可能不同,比较前应确认口径。线程还可能在核心之间迁移,所以不能要求某一个固定核心始终显示满载。
如果Tick墙钟耗时明显变长,线程CPU时间却没有相应增加,应转查锁等待、同步I/O、数据库调用和调度停顿。虚拟机中,steal升高提示可能存在宿主机调度争用,但steal较低也不能独立证明不存在资源争用。容器环境还应查看CPU配额及节流计数的增量,不能把“被配额限制”直接归为处理器单核能力不足。
单核计算瓶颈的有效证据链是:关键线程接近可用执行上限、计算耗时增加、Tick超预算、业务队列随后增长,同时没有更强的等待型解释。
带宽描述单位时间内可传输的数据量;时延描述一次传输或往返需要多久;抖动描述时延或到达间隔的波动;丢包则意味着数据没有按预期到达。这些指标会相互影响,但不能互相替代。
实时对战的单个消息可能很小,平均吞吐并不高,却对到达时间敏感。以应用载荷估算,200名在线玩家,每人每秒接收20条、每条250字节的状态消息:
200 × 20 × 250 = 1,000,000字节/秒,即1MB/s;按十进制换算,约为8Mbps。
这个估算不含协议头、重传、登录流量和资源下载,也没有反映发送突发。即便100Mbps出口的平均占用只有约8%,短时间内的集中发包、共享链路拥塞、包速率限制或某段路径丢包,仍可能影响体验。
因此,“平均带宽没满”只能排除一部分持续吞吐不足的情况,不能排除网络问题。
下面是另一组模拟数据,统计口径仍为60秒窗口:
| 窗口 | Tick耗时P99 | 服务端消息处理P99 | 应用RTT P50 | 应用RTT P99 | 端到端探测丢包率 | 出口吞吐 |
|---|---|---|---|---|---|---|
| 正常阶段 | 24ms | 5ms | 42ms | 66ms | 0% | 8Mbps |
| 某接入路径波动 | 25ms | 6ms | 45ms | 188ms | 0.8% | 8Mbps |
| 路径恢复后 | 24ms | 5ms | 43ms | 71ms | 0% | 8Mbps |
这里的端到端探测丢包率,应由明确数量的应用探测包或协议统计计算,并说明方向及样本量,不能用某个中间路由器“不回应探测”的比例替代。
这组变化更支持链路问题:服务端Tick和处理耗时基本不变,客户端中位RTT变化不大,但尾部时延和端到端丢包同时恶化。下一步应比较受影响与未受影响玩家的地区、运营商和接入方式,而不是立即升级CPU。
应用RTT本身也包含服务端等待。如果心跳消息和战斗逻辑共用队列,主线程卡住同样会拉高“网络延迟”。因此,应把心跳的接收、排队、处理、发送阶段分开记录,或使用不经过重业务逻辑的轻量探测辅助判断。
有效的路径对照,应保留相同客户端版本、相近测试时段和一致业务负载:
TCP连接可以结合ss -tin查看连接的RTT、重传等信息,但应观察故障前后的变化,不能把累计重传量直接当作当前重传率。UDP业务则需要应用序列号、乱序率、重复率和接收间隔统计,并结合系统UDP错误计数;TCP指标不能替代UDP质量指标。
中间节点的探测丢包只适合提供线索。如果后续节点与最终目的端没有相应丢包,可能只是该节点降低了探测报文响应优先级,不应据此判定业务转发异常。
内存“已使用比例高”不等于内存不足,因为文件缓存也会占用内存。更有判断价值的是可用内存、换页活动、重大缺页、内存压力和应用停顿是否同步变化。
例如,加载新地图时Tick突然变长,如果同时出现重大缺页和磁盘读取延迟上升,应考虑工作集未驻留、资源加载或换页,而不是先认定单核不够。相反,托管运行时的垃圾回收暂停可能发生在内存尚有余量时,需要看暂停时间、分配速率和存活对象变化。
还要注意因果方向:内存增长可能导致停顿,也可能是下游变慢后消息队列不断堆积的结果。
测试服常将游戏进程、数据库、日志和资源文件放在同一实例。日志同步写入、数据库刷盘、资源解压或备份,都可能与逻辑线程争用存储。
在已安装sysstat的Linux环境中,可以同时观察:
vmstat 1 60
iostat -xz 1 60
vmstat可帮助查看运行队列、换页和I/O等待;iostat可观察块设备延迟、队列和吞吐。部分工具首个报告可能是启动以来的平均值,应以随后的区间数据分析故障。
不要把磁盘%util接近100%直接等同于所有存储设备都已达到性能上限。在虚拟化存储和支持并行处理的设备上,它需要结合I/O延迟、队列、吞吐及具体读写模式解释。反过来,低吞吐也不代表没有I/O瓶颈,大量小块同步写入可能消耗很少带宽,却带来明显等待。
如果网卡吞吐正常、CPU也不高,但所有玩家的响应同时变慢,重点检查主线程是否同步等待数据库、锁、文件或其他服务。
| 联动现象 | 优先候选 | 需要补充的验证 |
|---|---|---|
| 主线程CPU升高,Tick与队列同步增长 | 计算热点、单线程容量不足 | 热点采样、相同场景对照 |
| CPU不高,锁等待和Tick耗时增加 | 应用锁竞争 | 锁持有时间、阻塞线程栈 |
| 数据库耗时先升高,应用队列随后增长 | 查询、锁或数据库资源问题 | 慢查询、锁等待、数据库I/O |
| 查询执行稳定,连接获取时间升高 | 连接池耗尽、连接未释放 | 活跃连接、等待队列、连接持有时长 |
| I/O延迟与Tick同时出现尖峰 | 同步日志、刷盘、资源读取 | 文件操作时间、读写进程 |
| 服务端稳定,仅部分路径RTT恶化 | 网络路径或玩家接入问题 | 多点对照、端到端丢包与抖动 |
数据库“调用耗时”最好拆成连接池等待和查询执行两部分。查询本身只用5毫秒,但等待连接用了200毫秒,与查询执行用了200毫秒,需要完全不同的处理。
依赖超时还可能触发重试,让队列进一步增长。因此,错误率、超时率、重试量和成功完成量要一起看:没有明显报错,不代表系统没有排队;报错增加,也不一定意味着最初的问题来自网络。
A5数据提供面向游戏测试场景的香港物理服务器资源,覆盖Xeon Gold、AMD EPYC等平台,并配备SSD或NVMe存储、不同内存规格及CN2和国际带宽方案,可承载主线程计算、数据库读写、日志处理与实时通信等任务。依托美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的服务器资源,A5数据也能为多地区访问与链路对照提供部署基础。
小团队可以把每次判断写成“支持证据、替代解释、验证动作”,避免一次性更换CPU、带宽和数据库后,虽然暂时恢复,却不知道是哪项改动有效。
若确认是单线程计算受限,优先定位热点、减少主线程同步工作,或按房间、地图、进程拆分负载。硬件侧可对比单线程执行能力更强的实例,但应使用同一游戏构建和相同业务场景验证。主频、vCPU数量都只是线索,不能代替业务测试。增加核心更适合能并行的任务或多个独立进程,不保证单房间Tick变短。
若确认是调度或配额问题,检查同机竞争、容器CPU限制和虚拟化资源争用。此时需要的是更稳定的执行时间或合理配额,而不一定是更多标称核心。
若确认是网络抖动,以目标玩家地区和运营商为范围做跨时段复测,评估不同接入路径的尾延迟与丢包。香港这一地理位置本身,不能保证各条访问路径表现一致;也不存在仅凭一个平均Ping值就能代表全部测试玩家的结果。
若确认是内存、存储或数据库问题,分别围绕工作集、暂停时间、同步I/O和依赖等待处理。仅增加带宽不会缩短数据库锁等待;仅升级CPU也不一定能解决换页或磁盘延迟。
带宽升级仍有适用场景:例如链路持续接近有效限速、发送队列增长,并且限制吞吐的证据与卡顿窗口重合。但如果流量主要来自补丁或资源下载,应先区分下载流量与实时游戏流量,避免用整体吞吐掩盖两类业务的相互影响。
复测应尽量一次只改变一个主要变量,并保留相同的构建版本、地图、房间数、在线人数、战斗事件密度和数据库状态。只固定在线人数还不够:相同人数下,站在大厅与集中释放技能的计算压力可能差很多。
验收也不能只看“CPU降了”。需要确认在成功处理相同业务量的前提下,Tick超预算比例下降、队列不再持续增长、响应尾延迟改善,并且错误率没有上升。如果程序通过丢弃消息或减少处理量降低耗时,那不是同等负载下的性能改善。
网络复测则要保留测试地区、运营商、协议、消息大小、发送频率和样本数量,并覆盖不同时段。短时间探测正常只能说明该窗口正常,不能推导所有时段都正常。
下一次玩家反馈卡顿时,建议直接调出三组联动视图:
这些指标的价值不在于分别跨过某条固定阈值,而在于它们是否在同一窗口内形成连贯变化:谁先变慢,谁随后排队,哪些指标保持稳定,以及只改变一个条件后,整条异常链是否随之改善。 对带宽看似够用的香港游戏测试服,这比继续盯着平均带宽或整机CPU,更容易找到真正需要处理的瓶颈。