香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


固定文件系统后,香港 PCIe Gen4 NVMe 服务器的压测重点不是把 iodepth 调到越高越好,而是找出吞吐开始趋平、尾延迟仍可接受的队列深度。建议先用固定的文件系统、挂载参数、I/O 引擎、块大小和测试文件建立基线,再只改变一个变量:队列深度。随后用 IOPS、带宽、p95/p99 延迟、CPU 占用、设备利用率和温度共同判断,而不是只看某一次压测的最高 IOPS。
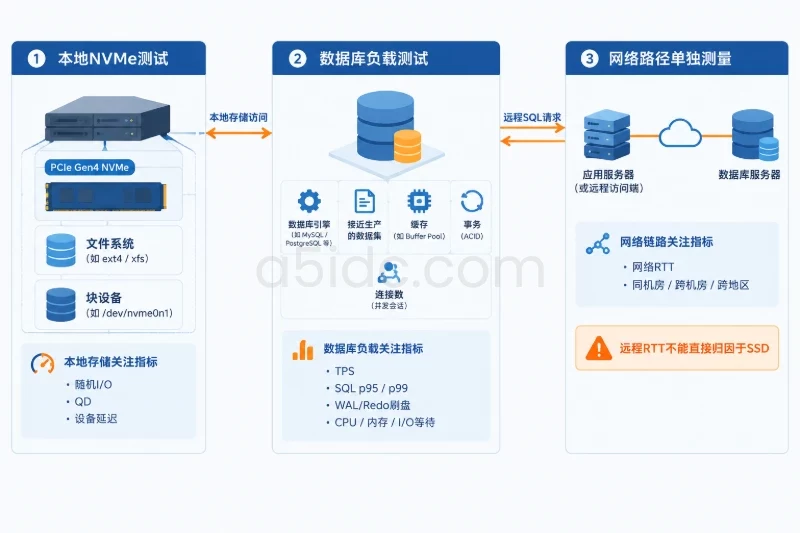
香港机房的位置主要影响应用服务器到客户端的网络往返时间,不会直接改变本地 NVMe 设备的队列机制。fio 在服务器本机测到的是存储路径表现;如果业务请求来自其他香港服务器或跨地域节点,还需要单独测量网络、应用线程池和数据库连接池带来的端到端延迟,不能把网络延迟归因于 SSD。
A5数据提供香港物理服务器租用,覆盖Xeon Gold、AMD EPYC等平台,并配备SSD或NVMe存储及不同内存规格,可为数据库、业务后台和多任务计算提供稳定的硬件资源基础。结合CN2与国际带宽方案,香港服务器也能承载面向不同访问区域的应用部署,为文件系统、I/O模式和队列深度测试提供明确的设备环境。
文件系统选择和队列深度选择属于两个不同变量。若一轮测试中同时把 ext4 换成 XFS、把 direct=0 换成 direct=1、把块大小从 4 KiB 改成 1 MiB,再把队列深度从 1 调到 64,最后即使结果发生变化,也无法判断究竟是哪项配置造成的。
常见文件系统可以先按业务特征进行初选:
| 文件系统 | 更适合优先验证的场景 | 需要重点观察的指标 | 不能直接推断的结论 |
|---|---|---|---|
| ext4 | 通用业务、较多小文件、工具链成熟的环境 | 小块随机 I/O、元数据操作、恢复流程、挂载参数 | 不能仅凭通用随机读结果认定它一定优于 XFS |
| XFS | 大文件、并行写入、较高并发文件操作 | 并发分配、顺序吞吐、随机写尾延迟、文件系统空间使用 | 不能把大文件顺序性能直接套用到数据库小块 I/O |
| 应用专用或数据库建议文件系统 | 由应用文档、发行版支持范围和运维要求共同决定 | 应用实际 I/O 模式、同步写语义、崩溃恢复 | 不能只凭 fio 的裸设备结果替代应用验收 |
如果服务器已经部署业务,通常不应为了单次压测直接重新格式化生产分区。重新创建文件系统会破坏该分区上的数据,必须先完成备份、确认维护窗口和回滚方案;更稳妥的做法是使用独立测试盘、独立云盘或专用测试挂载点。
文件系统确定后,应把以下参数视为测试条件的一部分:
noatime、是否启用压缩或配额。O_DIRECT。先用命令确认,而不是凭配置文件或面板信息猜测:
findmnt -T /srv/io-test -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT /srv/io-test
lsblk -o NAME,MODEL,SERIAL,SIZE,TYPE,FSTYPE,MOUNTPOINTS
上面示例假设测试目录是 /srv/io-test。实际环境中应替换为专用挂载点。不要把生产数据库文件、虚拟机镜像或唯一业务数据文件直接作为 fio --filename 的目标。
PCIe Gen4 x4 链路提供的是接口层能力,最终性能还会受到 SSD 控制器、闪存颗粒、固件、温度、剩余空间、写入放大、虚拟化层和文件系统的影响。可以在压测前检查链路状态:
readlink -f /sys/class/block/nvme0n1/device
sudo lspci -vv -s 0000:65:00.0 | grep -E 'LnkCap|LnkSta'
其中 0000:65:00.0 只是示例,需要替换为上一条命令返回路径中的实际 PCI 地址。重点查看:
LnkCap:设备或插槽支持的最高速度与通道宽度。LnkSta:当前实际协商出的速度与通道宽度。在云服务器中,宿主机可能不会向虚拟机完整暴露 PCIe 链路信息。此时应把虚拟块设备作为实际测试对象,不能因为产品描述中写有“PCIe Gen4”就默认虚拟机一定获得了完整的 Gen4 x4 性能。
先记录内核、fio 版本、设备队列参数和 NVMe 健康信息。设备名不能固定假设为 nvme0n1,应根据 lsblk 和挂载关系替换。
uname -a
fio --version

findmnt -T /srv/io-test -o TARGET,SOURCE,FSTYPE,OPTIONS
lsblk -o NAME,MODEL,SERIAL,SIZE,TYPE,FSTYPE,MOUNTPOINTS

cat /sys/block/nvme0n1/queue/scheduler
cat /sys/block/nvme0n1/queue/nr_requests
cat /sys/block/nvme0n1/queue/logical_block_size
cat /sys/block/nvme0n1/queue/physical_block_size

sudo nvme list
sudo nvme smart-log /dev/nvme0
如果系统没有 nvme 命令,不要直接根据猜测安装或修改配置;可以先确认发行版软件包和维护窗口,再补充 nvme-cli。温度、可用备用空间、介质错误和警告信息应在测试开始前记录一次。
同时打开监控窗口:
iostat -xz 1
必要时另开窗口观察 CPU 和进程:
mpstat -P ALL 1
pidstat -dru 1
iostat 中可以关注读写 IOPS、吞吐、await、aqu-sz 和 %util。NVMe 使用多队列,%util=100 不一定等于传统单队列磁盘意义上的“完全饱和”,应与吞吐平台期、尾延迟和温度变化一起判断。
文件测试会消耗空间,随机写测试还会覆盖目标文件中的原有内容。建议预留独立挂载点,并先确认可用空间:
df -hT /srv/io-test
下面的命令创建一个 64 GiB 级别的测试文件。Linux 中 G 后缀通常按二进制单位处理,具体行为以系统工具版本为准。此文件只应位于专用测试目录:
fallocate -l 64G /srv/io-test/fio-test.bin
执行前需要确认:
如果要测试完整 SSD 的稳态随机写性能,64 GiB 测试文件通常不能代表整个盘的介质状态。写缓存、垃圾回收和过度预留都会影响结果,应使用更长的预热时间、覆盖更大范围的数据,必要时在独立设备上进行预处理。不要把小测试文件的结果直接写成整块盘的长期写入能力。
如果业务是数据库或对象索引一类的小块随机读,可以先使用 4 KiB 随机读作为队列深度基线。下面的命令固定了文件系统、文件、块大小、I/O 引擎、进程数和运行时间,后续只改变 iodepth:
fio --name=randread-q1 \
  --filename=/srv/io-test/fio-test.bin \
  --rw=randread \
  --bs=4k \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=1 \
  --numjobs=1 \
  --size=64G \
  --time_based \
  --runtime=120 \
  --ramp_time=20 \
  --randrepeat=0 \
  --group_reporting \
  --eta=never
这组参数的含义是:
--rw=randread:只验证随机读,避免把读写比例同时引入。--bs=4k:每个 I/O 请求为 4 KiB。--ioengine=libaio:在常见 Linux 发行版上提供异步 I/O 路径;如果系统不支持,应先用 fio --enghelp 核验。--direct=1:尽量绕过页缓存,减少内存缓存对结果的影响。--iodepth=1、--numjobs=1:先测单个工作线程、单个未完成请求。--ramp_time=20:前 20 秒作为预热,不把刚启动时的波动当成稳定结果。--runtime=120:稳定运行 120 秒,用于观察平均值和尾延迟。direct=1 适合模拟应用使用直接 I/O 的情况,但不代表所有业务都应这样测。普通文件读写、日志写入和部分数据库配置可能依赖页缓存;如果真实应用使用缓冲 I/O,应另做一组 direct=0 的实验,并保持缓存清理、测试文件大小和运行时间一致。两组结果不能混为一谈。
对于写入压测,randwrite 会改写测试文件;如果只在专用文件上操作,影响范围是该文件。若业务依赖同步提交,还需要在单独的一轮测试中加入与应用一致的 fsync 或 fdatasync 语义。同步写和异步写必须分开记录,因为它们代表不同的性能目标。
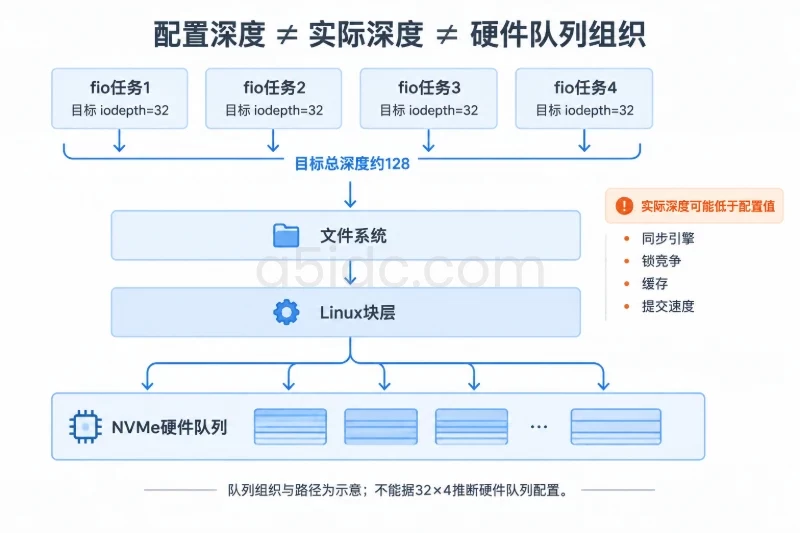
iodepth、线程数和总并发在 fio 中,iodepth 是每个作业允许保持的未完成 I/O 数量,numjobs 是并行作业数。简单情况下,可以把潜在总深度近似看作:
总未完成请求数 ≈ iodepth × numjobs例如,numjobs=4、iodepth=4 的潜在并发约为 16,但真实有效深度还会受文件系统、I/O 引擎、应用提交节奏和设备完成速度影响。
因此第一轮测试应固定 numjobs=1,只让 iodepth 按 1、2、4、8、16、32、64 变化。下面的循环不会修改其他参数:
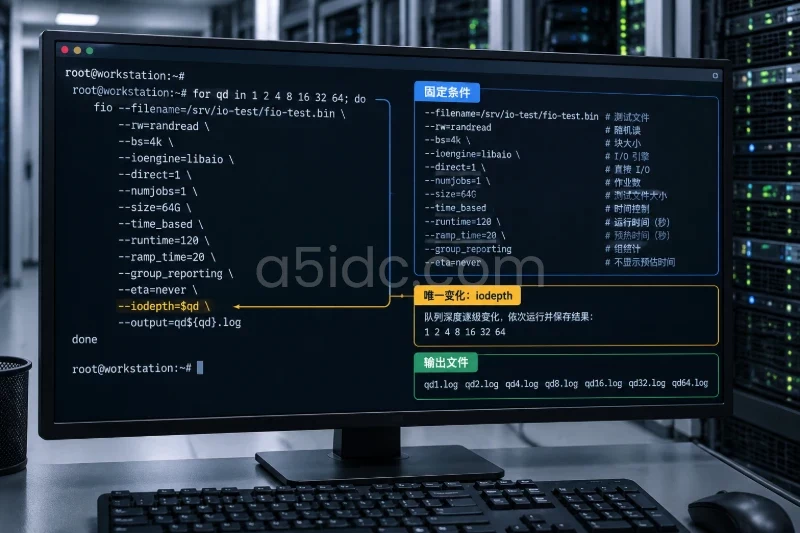
mkdir -p /var/tmp/fio-qd-results

for qd in 1 2 4 8 16 32 64
do
  fio --name="randread-qd${qd}" \
    --filename=/srv/io-test/fio-test.bin \
    --rw=randread \
    --bs=4k \
    --ioengine=libaio \
    --direct=1 \
    --iodepth="${qd}" \
    --numjobs=1 \
    --size=64G \
    --time_based \
    --runtime=120 \
    --ramp_time=20 \
    --randrepeat=0 \
    --group_reporting \
    --eta=never \
    --output="/var/tmp/fio-qd-results/qd${qd}.log"
done
如果使用 io_uring,应先确认内核、fio 版本和权限支持,再把它作为另一轮独立实验。不能在队列深度阶梯测试过程中同时切换 libaio 和 io_uring,否则无法判断结果差异来自队列深度还是 I/O 引擎。
下面是一组用于说明判断方法的模拟结果,单位和数值仅用于演示,不代表某台香港服务器的实测性能。测试对象为 4 KiB 随机读,numjobs=1,带宽以 MiB/s 表示,延迟为 fio 的完成延迟 p99:
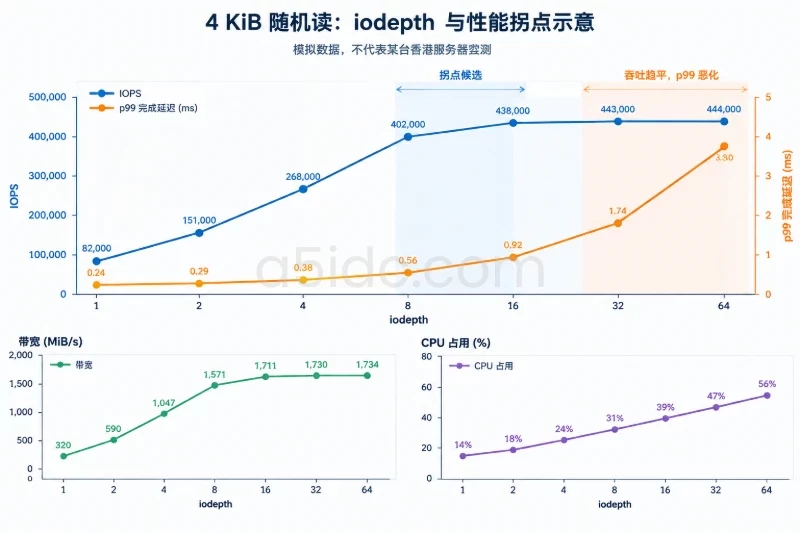
iodepth | IOPS | 带宽 | 平均完成延迟 | p99 完成延迟 | CPU 占用 | 观察 |
|---|---|---|---|---|---|---|
| 1 | 82,000 | 320 MiB/s | 0.15 ms | 0.24 ms | 14% | 延迟低,但设备并发不足 |
| 2 | 151,000 | 590 MiB/s | 0.18 ms | 0.29 ms | 18% | 吞吐明显增加 |
| 4 | 268,000 | 1,047 MiB/s | 0.23 ms | 0.38 ms | 24% | 仍处于扩展区间 |
| 8 | 402,000 | 1,571 MiB/s | 0.31 ms | 0.56 ms | 31% | 吞吐接近平台前段 |
| 16 | 438,000 | 1,711 MiB/s | 0.45 ms | 0.92 ms | 39% | 吞吐增幅变小 |
| 32 | 443,000 | 1,730 MiB/s | 0.78 ms | 1.74 ms | 47% | 吞吐几乎不再增加 |
| 64 | 444,000 | 1,734 MiB/s | 1.40 ms | 3.80 ms | 56% | 尾延迟明显恶化 |
这组数据的拐点大约在 QD8 到 QD16 之间。若应用的 p99 目标是 1 ms,QD16 已经接近边界,实际生产可能需要选择 QD8 并保留波动余量;如果应用是离线批处理,吞吐比尾延迟更重要,QD16 或 QD32 才可能有价值,但应继续确认温度和持续运行后的稳定性。
不能仅因为 QD64 的 IOPS 最高,就把应用队列统一改成 64。上表中 QD32 到 QD64 几乎没有吞吐收益,却增加了等待时间。更深的队列往往只是把请求堆积在设备或文件系统中,不能解决 SSD 已经达到处理能力上限的问题。
单次运行可能受到 CPU 调度、后台任务、SSD 温度和云主机邻居噪声影响。建议对候选队列深度至少重复 3 次,记录中位数和 p99;如果同一 QD 的 IOPS 波动超过约 10%,先调查环境,而不是立即调参。
重复测试时要保持:
fio 版本和 I/O 引擎。如果 QD8 的结果为 400,000 IOPS,QD16 的结果为 438,000 IOPS,但 QD16 的 p99 从 0.6 ms 增加到 1.2 ms,就不能只看 9.5% 的 IOPS 增长。最终选择应由应用的延迟目标和吞吐需求共同决定。
fio 输出可以按以下方式解释常见现象:
| 现象 | 更可能的原因 | 下一步验证 |
|---|---|---|
| QD 增加后 IOPS 快速增加,p99 只小幅上升 | 设备仍有并发处理空间 | 继续按 2 倍阶梯测试 |
| IOPS 基本不变,p99 快速上升 | SSD、虚拟块设备或某一层已接近饱和 | 检查 iostat、温度和设备错误 |
| IOPS 不高但 CPU 占用接近满载 | I/O 提交、校验、文件系统或应用线程成为瓶颈 | 查看 mpstat、pidstat 和进程级 CPU |
| 顺序带宽很高,随机 IOPS 较低 | 负载类型不同,不一定是故障 | 分别建立顺序和随机基线 |
| 第一次运行很快,持续运行后下降 | 缓存、SLC 写缓存、垃圾回收或温度限制 | 延长预热和测试时间,观察温度曲线 |
fio 很快,但应用 p99 很高 | 应用线程池、网络、锁等待或数据库提交过程限制 | 从业务客户端做端到端测量 |
NVMe 的 %util、队列长度和 await 不能单独作为结论。比如设备利用率接近 100% 而 p99 仍满足业务要求,可能是合理的高效运行;反过来,利用率不高但应用延迟很高,也可能是上层线程、网络或同步提交造成的等待。
文件测试结果不是裸设备结果。文件系统需要处理文件偏移、分配、元数据和空间回收;但使用 direct=1、预分配测试文件和大块顺序读时,部分文件系统差异可能被弱化。
建议至少区分以下测试:
direct=1 测应用明确采用直接 I/O 的场景。direct=0 测依赖页缓存的普通文件访问。例如,4 KiB 随机读得到的 QD8 结论,不能直接用于 1 MiB 顺序写。顺序 I/O 更容易受带宽、PCIe 链路、SSD 写缓存和文件系统分配策略影响;随机写还需要观察写放大、垃圾回收和持续写入后的尾延迟。
fio 参数fio --iodepth=16 不是“服务器全局队列深度设置”。它只表示这一个测试作业尝试保持的未完成请求数量。生产环境中的有效队列可能来自:
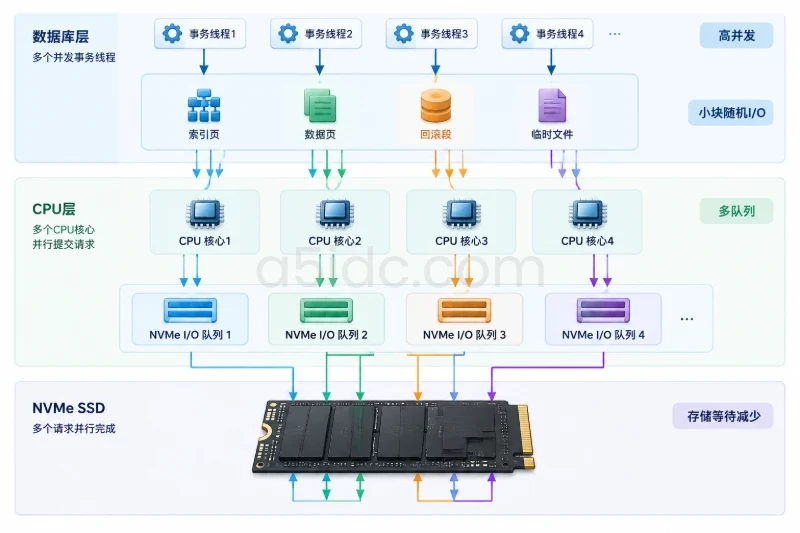
如果应用只有 4 个工作线程,每个线程最多提交 1 个请求,那么把设备参数改到 QD64 不会让应用自动产生 QD64 的有效并发。相反,如果几十个进程同时访问同一 SSD,即使单个进程的 iodepth=1,设备侧总队列也可能已经很深。
更稳妥的调整顺序是:
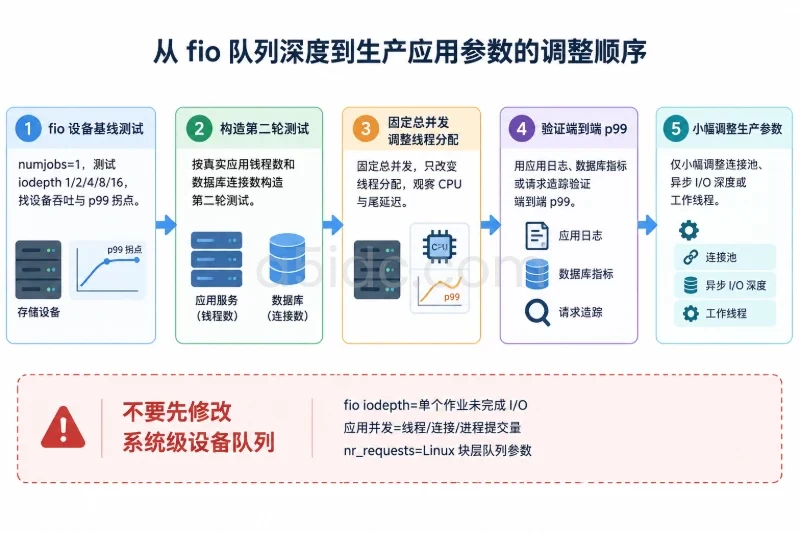
numjobs=1、iodepth=1/2/4/8/16... 找出设备拐点。例如,模拟结果显示 QD8 已达到 400,000 IOPS,QD16 只有约 9% 的吞吐增加,但 p99 增加约 64%。如果业务峰值只需要 220,000 IOPS,QD8 可能比 QD16 更适合;如果业务是低延迟交易,甚至可能要从 QD4 开始验证。
nr_requests 当成业务队列深度/sys/block/ 是 Linux 块层队列相关参数,不等同于 fio 的 iodepth,也不等同于数据库或应用的并发数。随意修改它可能改变排队和内存占用,却没有解决应用提交不足、CPU 受限或 SSD 饱和的问题。
压测第一轮应只读取它并保持不变:
cat /sys/block/nvme0n1/queue/nr_requests
cat /sys/block/nvme0n1/queue/scheduler
如果确实要修改块层参数,应先记录原值,确认内核和发行版支持方式,安排维护窗口,并准备恢复原值的回滚步骤。修改后也必须重新执行完整基线,不能把修改前后的不同负载结果直接比较。
磁盘容量规划不能只看当前数据量,还应考虑增长周期、文件系统元数据、快照、临时文件、日志和 SSD 需要保留的空闲空间。下面用十进制单位演示:
增长量为:
18 GB × 180 = 3,240 GB = 3.24 TB
规划期末的数据量为:
1.2 TB + 3.24 TB = 4.44 TB
如果要求这部分数据只占规划容量的 80%,则至少需要:
4.44 TB ÷ 0.80 = 5.55 TB
这里的 5.55 TB 是业务数据对应的最低可用容量估算,不包含独立副本、备份、快照和 RAID 损耗。如果本地还要保存两份数据,则先将数据量乘以 2:
4.44 TB × 2 ÷ 0.80 = 11.10 TB
文件系统元数据和目录结构所需空间应根据文件数量、平均文件大小和具体文件系统另行估算。不能把“20% 空闲”误认为任何 SSD、任何写入模式下都足够;高比例随机写、持续日志写入和快照密集环境可能需要更大的增长余量。
假设业务峰值为 220,000 次 4 KiB I/O 每秒,并希望设备只使用约 70% 的已验证能力,则所需能力为:
220,000 ÷ 0.70 = 314,286 IOPS
在前面的模拟结果中,QD8 约为 402,000 IOPS,看起来能够覆盖这个目标;但这只是 4 KiB 随机读结果。如果实际业务是 70% 读、30% 写的混合负载,必须重新测试 randrw,不能直接使用纯随机读的数字。
4 KiB IOPS 换算为带宽时,应区分十进制和二进制单位:
220,000 × 4,096 字节 = 901,120,000 字节/秒
因此约为:
这只是 220,000 个 4 KiB 请求在理想连续提交下的带宽需求,不包含协议、文件系统和应用开销。对于混合读写,还要分别记录读 IOPS、写 IOPS、读写带宽和写入延迟。
性能余量和容量余量是两件事:
这套方法得到的是特定服务器、特定 NVMe 设备、特定文件系统和特定负载下的选择依据,不是 PCIe Gen4 NVMe 服务器的通用固定值。以下情况发生后,应重新建立基线:
fio、文件系统或挂载参数发生变化。最终的队列深度应以“满足业务 p99 和峰值吞吐,并保留增长余量”为准。若只进行一次短时 fio,只能说明该时间窗口、该测试文件和该负载下的局部表现;只有在相同条件下复测,并用真实应用负载验证端到端延迟,才能把压测结果用于生产配置。