香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


香港服务器出现“访问慢”“偶尔打不开”或“连接频繁中断”时,先确认故障发生在哪些用户、哪些网络、哪些请求上,再沿着本地网络、DNS、路由与丢包、TCP连接、服务器资源和应用响应逐层排查。ping用于观察基础可达性,traceroute用于寻找路径变化,TCP抓包用于核对连接和数据传输过程,三者提供的证据不能相互替代。
排查的关键不是找到一个异常数值就下结论,而是缩小故障范围。例如,只有某个运营商的用户访问异常,应优先检查该访问方向的路径;所有地区都慢,但TCP连接建立很快,则应继续检查服务器和应用。一次ping超时、某个中间路由节点不回复,都不足以证明香港服务器线路存在故障。
这三类现象对应的检查重点不同:
| 现象 | 优先观察的证据 | 下一步 |
|---|---|---|
| 域名打不开,直接指定IP可以访问 | DNS解析结果、解析耗时、IPv4与IPv6差异 | 检查解析记录和不同地址的可达性 |
| TCP连接超时 | SYN是否发出、是否收到SYN-ACK、监听与过滤规则 | 检查路径、服务监听和访问控制 |
| 连接很快,页面迟迟没有内容 | TLS耗时、首字节时间、应用与数据库日志 | 检查服务处理和下游依赖 |
| 下载开始正常,随后速度下降 | 重传、接收窗口、带宽占用、磁盘读取 | 区分网络传输与主机资源瓶颈 |
| 仅部分地区或运营商异常 | 多地同目标测试、路由变化、终点丢包 | 检查特定访问方向 |
| 长连接或大响应容易中断 | RST、超时、MTU、负载均衡连接策略 | 核对断开方及触发条件 |
记录故障时,应保留时间和时区、客户端所在地区与运营商、目标域名、实际连接IP、端口,以及受影响的请求类型。对于间歇性故障,准确时间比一句“今晚很卡”更有诊断价值。
可以按照下面的顺序建立问题树:
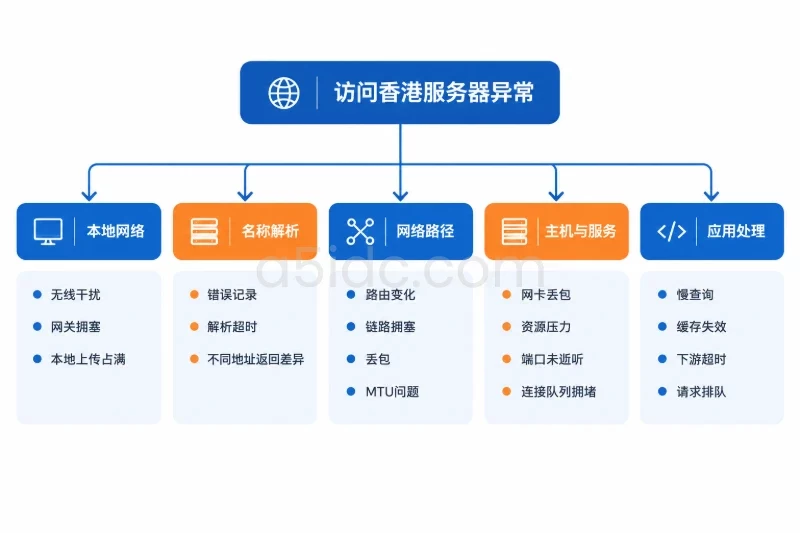
访问香港服务器异常
├─ 本地网络:无线干扰、网关拥塞、本地上传占满
├─ 名称解析:错误记录、解析超时、不同地址返回差异
├─ 网络路径:路由变化、链路拥塞、丢包、MTU问题
├─ 主机与服务:网卡丢包、资源压力、端口未监听、连接队列拥堵
└─ 应用处理:慢查询、缓存失效、下游超时、请求排队
每个分支都需要对应的观察证据。网络层测试正常,只能降低网络故障的可能性,不能直接证明应用正常;应用请求超时,也不一定意味着网络丢包。
下文命令以常见Linux环境为例。客户端可以使用Linux工作站,服务器检查需要相应管理权限;mtr、dig、tcpdump等工具可能需要预先安装。Windows客户端可先使用ping、tracert和Resolve-DnsName进行基础检查。
示例中的example.com、203.0.113.10和198.51.100.20均为占位目标,后两个属于文档示例地址,执行前必须替换。优先使用只读检查,不要一开始就重启服务、清空防火墙或修改网络参数,否则可能丢失现场证据。
第一组测试应该同时包含本地网关、香港目标和一个已知正常的对照目标。Linux客户端可以先查看默认路由,再测试网关:
ip route show default
ping -c 20 <本地网关IP>
ping -c 20 203.0.113.10
如果无线连接下网关也频繁丢包,应先换有线连接,或检查无线信号和本地流量。如果访问多个无关目标都变慢,而另一台设备正常,问题更可能位于当前设备或本地接入网络。
网关也可能限制ICMP回复,因此仍要结合实际访问表现判断。对照目标只是用于观察本地是否普遍异常,不要求它与香港服务器具有相同的延迟。
接着使用另一条独立接入网络测试同一域名、同一IP和同一端口。例如,固定宽带与移动数据的对照可以帮助缩小范围:
测试期间应暂停大规模上传、下载和其他会占满接入带宽的任务。尤其是上传占满时,本地队列可能让交互请求延迟明显升高。
先查询域名的IPv4和IPv6记录:
dig example.com A
dig example.com AAAA
重点观察返回地址、查询耗时、TTL,以及失败时的状态。不同客户端得到不同地址,不一定是错误:CDN、地域调度和多地址部署都可能产生这种结果。
对于HTTPS服务,不宜直接访问https://IP地址作比较,因为证书、SNI和虚拟主机匹配可能不同。可以保留域名,同时指定连接地址:
curl -4 --connect-timeout 5 --max-time 20 \
  --resolve example.com:443:203.0.113.10 \
  -o /dev/null -sS \
  -w 'remote=%{remote_ip} code=%{http_code} total=%{time_total}\n' \
  https://example.com/
如果普通域名访问失败,而指定正确IP后成功,DNS或域名返回的其他地址值得继续检查;如果二者都失败,则不能把问题停留在解析层。
域名同时有A和AAAA记录时,还应分别用curl -4和curl -6测试。仅IPv6失败,可能是IPv6路径、监听或访问控制问题。没有AAAA记录时,IPv6解析失败本身并不是故障。
若业务经过CDN或负载均衡,普通域名访问测试的是入口路径,指定源站IP测试的是另一段路径。源站正常并不代表入口正常;源站只允许特定回源地址访问时,直接连接被拒绝也不代表源站故障。
对真实目标进行一段连续观察:
ping -c 100 -i 0.5 203.0.113.10
需要同时看回复是否持续、延迟是否波动、终点是否出现丢包,并与正常时段或其他接入网络比较。
例如,一组示例结果从平时约35毫秒变成频繁超过180毫秒,说明路径或端点处理存在变化,但还不能判断变化来自哪一侧。香港服务器的往返延迟取决于访问地区、运营商、跨境路径和当时拥塞情况,不宜用统一数值判断所有用户。
ICMP丢包不等于业务TCP丢包。 服务器可能降低ICMP回复优先级,甚至不回应ICMP。如果网站仍能稳定连接和传输,应继续使用业务端口测试,而不是仅凭ping判定网络中断。
常见Linux环境可以使用:
traceroute -n 203.0.113.10
mtr -n -r -w -c 100 203.0.113.10
如果实际故障发生在HTTPS连接,还可以在工具版本支持时使用TCP探测:
traceroute -n -T -p 443 203.0.113.10
mtr -n -r -w -c 100 --tcp --port 443 203.0.113.10
部分功能需要额外权限,可先通过--help核验。TCP探测更接近业务端口,但依然不能完全复现真实请求。
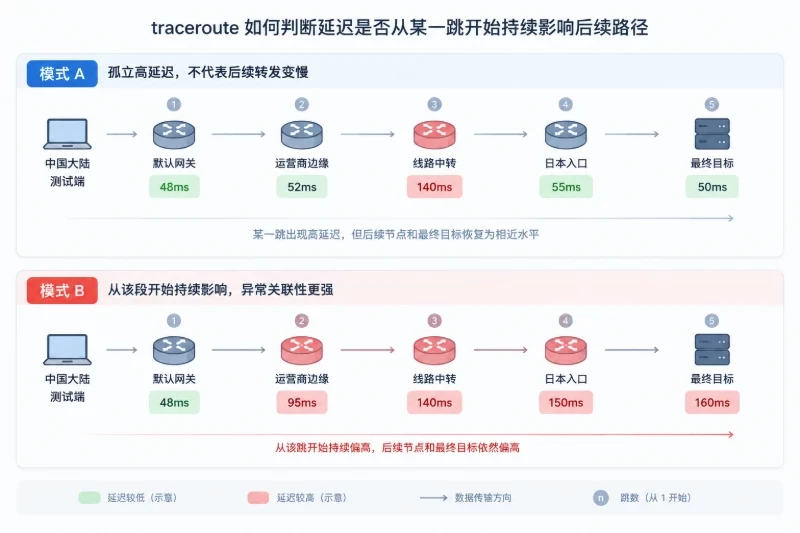
解释结果时,应遵守以下边界:
| 路径现象 | 可以得出的判断 | 不能直接得出的判断 |
|---|---|---|
| 某中间跳高丢包,后续跳和终点正常 | 该节点可能限制探测回复 | 业务流量在该节点同样丢包 |
| 某跳以后延迟整体升高 | 该位置附近是进一步核查的候选范围 | 该节点一定是拥塞源 |
| 后续跳和终点持续丢包 | 路径或终点可能存在实际异常 | 单向测试即可精确定位故障链路 |
出现多个*,终点仍正常 | 部分节点不回应或过滤探测 | 路径中断 |
| 路径变化,但业务指标正常 | 路由发生变化 | 新路径一定更差 |
路由探测显示的是探测报文经过的路径,各跳的回复还可能走不同回程。香港服务器与客户端之间也可能存在去程、回程不对称。需要定位运营商或上游问题时,应尽量从服务器向客户端方向补充测试;客户端位于NAT后或不回应探测时,反向结果也有局限。
怀疑MTU问题时,Linux可尝试:
ping -M do -s 1472 -c 4 203.0.113.10
在无IP选项的IPv4场景中,1472字节载荷加上20字节IP头和8字节ICMP头,共1500字节。这只是验证线索:失败也可能是ICMP过滤,不能据此立即修改MTU。大响应停顿、小请求正常,并且抓包出现相关重传或“需要分片”提示时,MTU方向才更值得深入。
对一个无需登录、响应较小的HTTPS地址进行测试:
curl -4 --connect-timeout 5 --max-time 20 \
  -o /dev/null -sS \
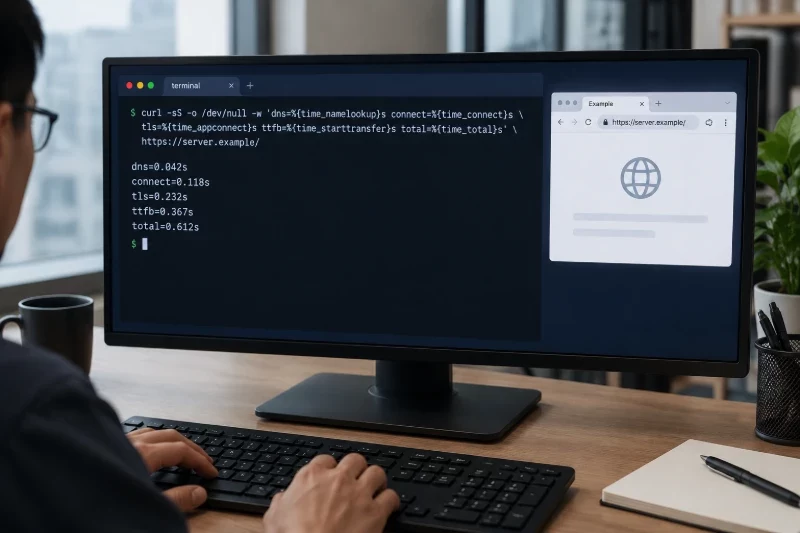
  -w 'ip=%{remote_ip} code=%{http_code} dns=%{time_namelookup} tcp=%{time_connect} tls=%{time_appconnect} first=%{time_starttransfer} total=%{time_total}\n' \
  https://example.com/
这些时间通常以秒表示,并且是从请求开始计算的累计时间,而不是各阶段独立耗时。对于一次没有重定向的简单HTTPS GET请求:
tcp - dns可近似观察TCP建连耗时。tls - tcp可近似观察TLS握手耗时。first - tls包含请求发送、往返等待和服务处理等时间。total - first主要反映首字节之后的响应传输耗时。首字节等待时间不能直接等同于应用执行时间。若服务器很快生成响应,但返回路径发生丢包,客户端同样可能迟迟收不到首字节。
下面是一组示例状态,而非真实环境检查结果:
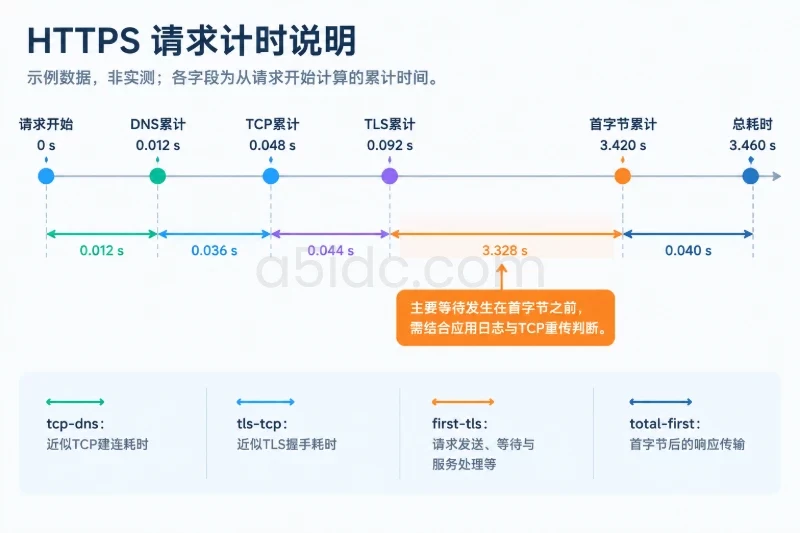
dns=0.012 tcp=0.048 tls=0.092 first=3.420 total=3.460
这组结果显示,连接和TLS握手相对较快,主要等待发生在握手后、首字节到达前。下一步应核对应用日志,同时抓包确认这段时间是否存在重传,而不是立即认定服务器线路慢。
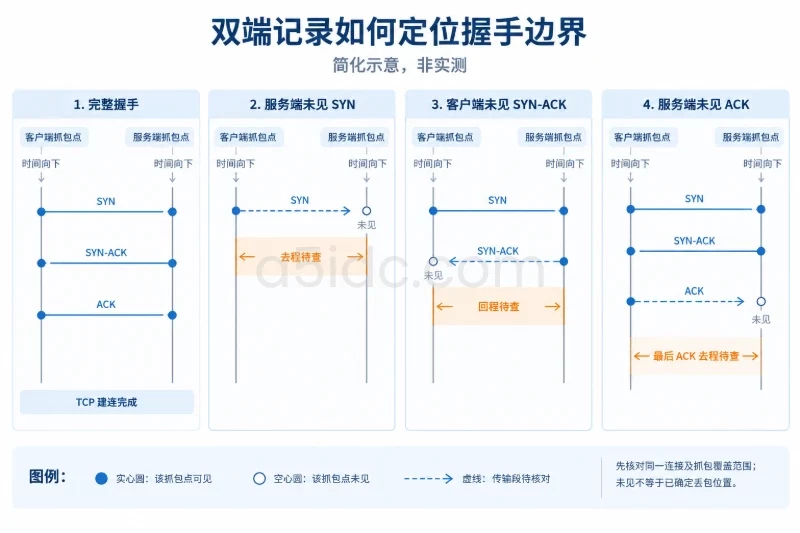
在客户端与服务器两侧同步抓包,通常比只抓一侧更容易区分报文是否到达。两侧时钟应尽量同步,并记录发起测试请求的时间。
客户端示例:
sudo timeout 60 tcpdump -i any -nn -s 128 -c 2000 \
  -w /tmp/client-443.pcap \
  'host 203.0.113.10 and tcp port 443'
服务器端示例:
sudo timeout 60 tcpdump -i any -nn -s 128 -c 2000 \
  -w /tmp/server-443.pcap \
  'host 198.51.100.20 and tcp port 443'
服务器过滤条件应使用它实际看到的客户端出口IP。存在CDN或负载均衡时,源站看到的可能是入口设备地址,不能直接使用用户设备的内网IP。
示例限制了60秒和2000个包,并截取每包前128字节,适合初步分析握手及多数TCP头字段,不适合还原完整应用报文。文件可能包含地址、端口及部分敏感信息,应限制访问、确认磁盘空间,并按运维制度保留和清理。高流量服务器应进一步缩小过滤范围,避免抓包本身增加负担。
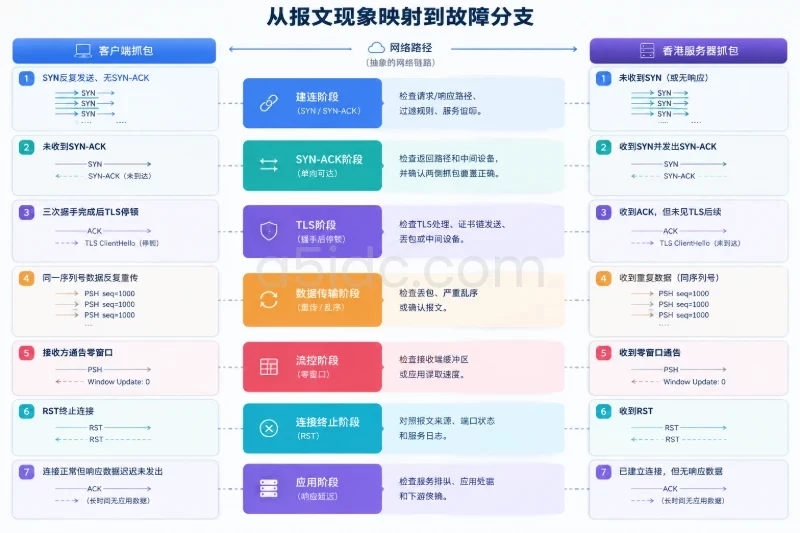
| 抓包现象 | 优先核查方向 |
|---|---|
| 客户端反复发送SYN,未收到SYN-ACK | 请求或响应路径、过滤规则、服务监听 |
| 服务端收到SYN并发出SYN-ACK,客户端未收到 | 返回路径或中间设备;先确认两侧抓包覆盖正确 |
| 三次握手完成,随后TLS阶段停顿 | TLS处理、证书链发送、丢包或中间设备 |
| 同一序列号数据反复重传 | 丢包、严重乱序或确认报文未及时到达 |
| 接收方持续通告零窗口 | 接收端缓冲区或应用读取速度 |
| 连接被RST终止 | 对照报文来源、端口状态和服务日志 |
| 连接正常、无明显重传,响应数据迟迟未发出 | 服务排队、应用处理、下游依赖 |
RST的源地址可以提供线索,但中间设备也可能代发,不能仅凭地址就断定是谁主动关闭连接。Wireshark标注的重传、乱序等提示也应结合时序分析;抓包丢包、网卡卸载功能或any接口重复采集可能制造误判。
HTTPS载荷通常是加密的。TCP抓包可以帮助分析握手、重传、窗口和断开时序,但不能默认直接读出HTTP状态码或应用错误。
在服务器上进行只读检查:
ss -lntp
ss -s
ss -tin
ip -s link
uptime
vmstat 1 10
分别观察业务端口是否监听、监听地址是否正确、连接状态是否异常,以及网卡错误、丢包和系统资源变化。
“进程存在”不等于“端口正在监听”。只监听本机回环地址,也不能直接接收公网连接。连接超时时,还应只读核对云平台安全规则、主机防火墙和服务访问控制;不同层的规则需要分别确认,不能因为其中一处允许443端口,就认为整个路径都已放行。
ss -lntp中,监听套接字的队列信息可以帮助识别等待接收的连接是否积压;ss -tin则有助于观察具体连接的RTT、重传及拥塞状态。网卡计数通常是累计值,应在故障前后取差值。虚拟化或容器环境存在多层接口,某个计数增长也不一定能直接归因于公网链路。
CPU、内存和磁盘异常是否相关,要看它们是否与请求变慢发生在同一时间:
负载平均值不是CPU使用率,多核服务器也不能只按一个固定负载数字判断。若安装了sysstat,可进一步用iostat -xz 1 10观察存储、用pidstat观察进程;没有工具时,应先利用已有监控和系统日志。
发现资源压力后,不宜立即扩容或重启。慢查询、连接泄漏、异常重试和突发任务都可能产生相似表象,应先定位占用来源。
如果使用Nginx反向代理,可在已配置相关字段的访问日志中观察request_time、upstream_connect_time和upstream_response_time。它们不是所有默认日志都会包含的字段。
下面是示例日志:
request_id=demo-001 status=504 request_time=30.001 upstream_connect_time=0.003 upstream_response_time=30.000
这表示反向代理连接上游较快,但等待上游响应约30秒后返回超时。下一步应按请求标识或时间定位应用日志、数据库慢查询、连接池等待及其他下游调用,而不是继续只检查公网路由。
还要注意各字段统计口径不同,重试或多个上游可能产生多个值,不能机械相减。业务接口应使用同一请求、相同认证条件进行比较;服务器本机调用健康检查正常,只能证明该轻量路径正常,不能证明涉及数据库的真实接口正常。
一份有用的诊断结果应说明故障时间、影响范围、失败阶段和对应证据,而不是只写“网络不好”。
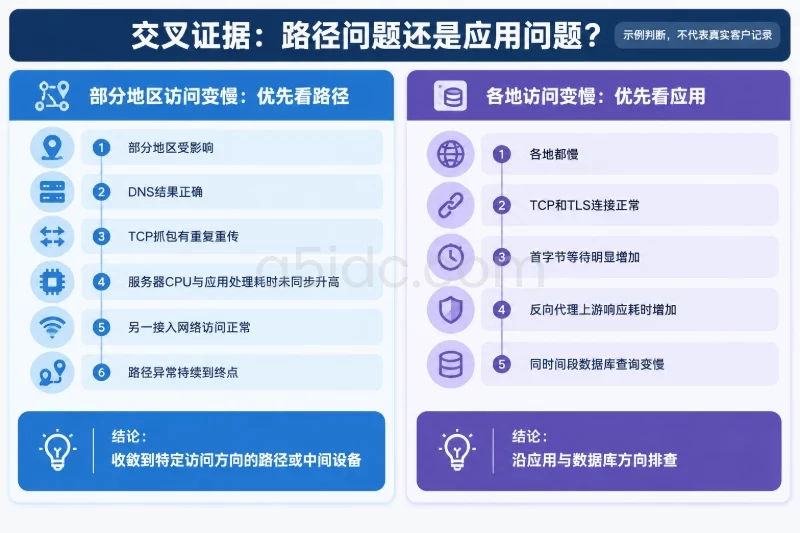
例如,一个示例故障表现为:部分地区访问香港服务器变慢;DNS结果正确;TCP抓包存在重复重传;服务器CPU和应用处理耗时没有同步升高;另一接入网络访问正常。结合路径测试中持续到终点的异常,可以把问题收敛到特定访问方向的路径或中间设备,再由网络服务方继续核查。
另一个示例表现为:各地都慢;TCP和TLS连接正常;首字节等待明显增加;反向代理日志显示上游响应耗时增加;同时间段数据库查询变慢。此时根因应沿应用与数据库方向排查。
向A5IDC或其他服务方提交网络工单时,建议附上:
提交前应脱敏账号、认证信息和无关流量,并明确测试的是CDN入口、负载均衡还是源站。
修复后,不能只看ping恢复。应使用原故障地区、原运营商、原域名、原端口和原请求重新测试,并与正常对照比较。
若修复涉及防火墙、路由或服务配置,变更前应保留原配置和必要的管理通道,明确影响范围及回滚方式。验证失败时按预定方案回退,不要连续叠加修改,让原因再次变得不可区分。
香港服务器的持续监控不宜只有一个存活探针。可从不同地区、不同运营商定期执行轻量业务请求,分别记录解析、建连、TLS、首字节、总耗时和成功率;主机侧同步记录带宽、网卡计数增量、TCP重传、连接队列、CPU、内存和磁盘;应用侧保留错误率、请求分位耗时及下游等待时间。
告警阈值应根据业务要求和历史基线设置,而不是把所有地区套进同一个延迟标准。可以结合连续异常窗口、多个独立探针和业务错误率降低误报,同时保留路径变化及发布变更的时间线。
分层排查最终要形成一条可核对的证据链:谁受影响、在哪一层失败、哪些原因已被排除、修复后原请求是否恢复。这样即使故障再次出现,也能从已有监控和对照记录快速收敛,而不必重新依赖一次ping猜测原因。
A5数据(A5IDC)提供香港及美国、日本、新加坡等地区的物理服务器资源,香港产品覆盖CN2与国际带宽、SSD或NVMe存储、Xeon Gold和AMD EPYC等配置,并提供多IP方案。针对网站、业务后台、数据库和接口服务,可结合访问区域、网络路径、主机资源与数据规模,构建便于分层观察和持续运维的服务器部署基础。