香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


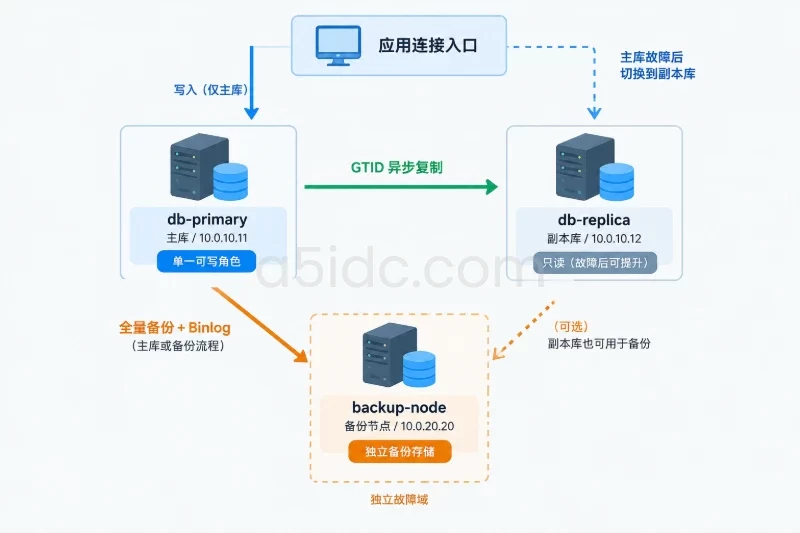
要让香港服务器上的 MySQL 高可用架构具备可恢复能力,目标不应止于“主库故障后切换到从库”,还应包括:主从同时遭遇误删时,能够从独立备份恢复;需要撤销某次错误操作时,能够把数据库恢复到该事务提交之前。实现这一目标,需要把一致性全量备份、连续 binlog 归档、异地保留和恢复演练配置成一条完整链路。
以下以 Ubuntu 22.04、MySQL 8.0.26 及以上的 8.0 系列为操作环境,围绕现有一主一从架构补齐备份与时间点恢复。示例采用逻辑备份,适合能在备份窗口内完成导出的数据库;数据量较大、恢复时限较短时,应改用与 MySQL 版本匹配的物理备份工具,但备份坐标、日志连续性、隔离恢复和验收原则不变。
围绕MySQL高可用、备份归档与隔离恢复场景,A5数据提供香港物理服务器及多地区服务器资源,覆盖常规建站、Xeon Gold和AMD EPYC等配置,并配备SSD或NVMe存储方案,可为主库、从库、备份节点和恢复实例提供独立的硬件基础。香港存储型服务器采用大容量企业级硬盘,适合承载备份文件与历史日志归档;结合香港、美国、日本、新加坡等地区资源,也能为不同业务访问范围下的数据部署提供选择。
主从复制解决可用性问题,独立备份解决历史数据恢复问题。 正常复制会把误删、错误更新等操作同步到从库,因此从库不能直接代替备份。
上线前分别定义两组目标:
| 场景 | 主要手段 | 必须验证的内容 |
|---|---|---|
| 主库进程或服务器故障 | 主从切换、写入口调整 | 从库追平情况、旧主隔离、应用重连 |
| 误删表、错误批量更新 | 全量备份与 binlog 回放 | 能否恢复到错误事务之前 |
| 主从存储同时受损 | 独立存储中的备份副本 | 备份是否离开生产故障域 |
| 备份损坏、密钥丢失 | 多副本、校验、恢复演练 | 是否存在可用副本与解密材料 |
可将“数据恢复 RPO 不超过 1 分钟、RTO 不超过 2 小时”作为示例目标,而不是默认承诺。前者取决于 binlog 已经安全归档到哪里,后者取决于备份下载、导入、日志回放和业务验证的总耗时。
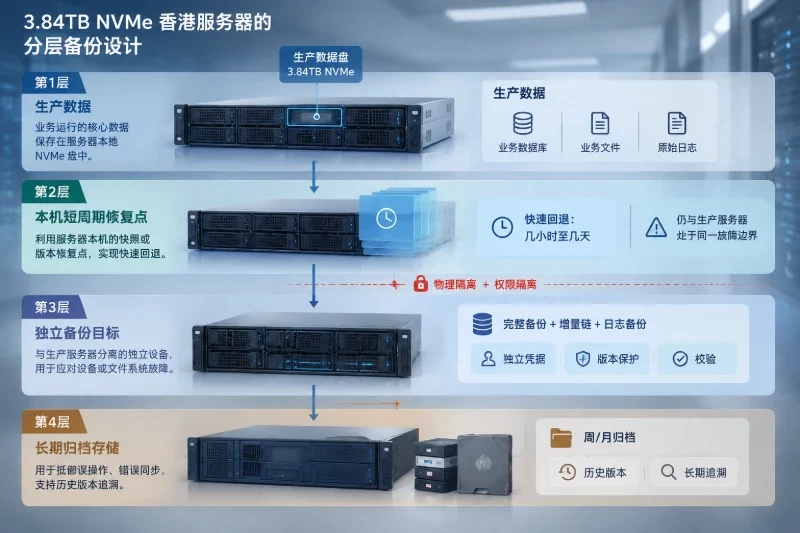
香港服务器上的主从节点应尽量分散故障域。备份不能只放在主库本机,也不应只存于主从共同依赖的同一块存储。异地传输走受控连接并启用加密;涉及个人信息、订单等数据时,还应核对保存地点、访问权限和跨地域存储要求。
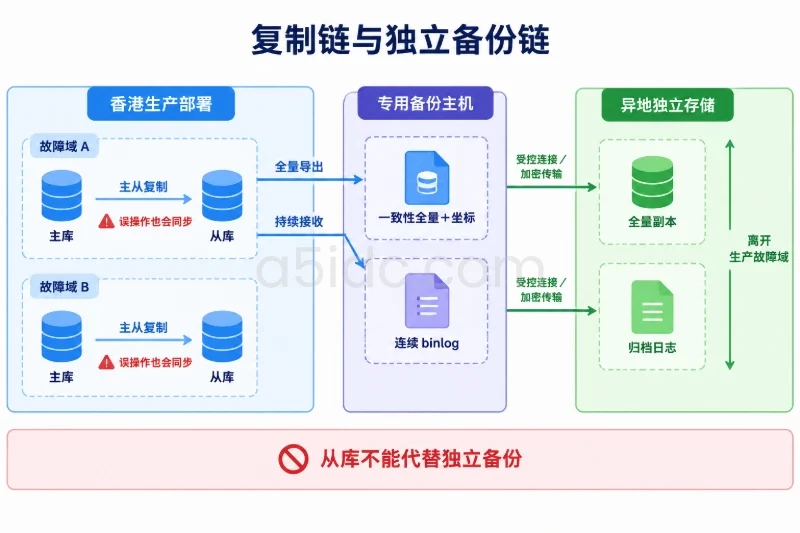
本文示例业务库为 shop 和 inventory,应作为一个整体导出,避免订单与库存落在不同的一致性时间点。
备份范围至少包括:
DEFINER 依赖。用户与权限应单独保存为受保护的重建清单,不建议为了恢复业务表,直接覆盖目标实例的 mysql 系统库。数据库备份也不会自动保护订单附件、上传文件或对象存储内容,这些数据需要协调恢复点。
先核验环境,不急于调整配置:
SELECT VERSION();

SHOW GLOBAL VARIABLES
WHERE Variable_name IN (
  'log_bin',
  'binlog_format',
  'binlog_expire_logs_seconds',
  'gtid_mode',
  'enforce_gtid_consistency',
  'sync_binlog',
  'innodb_flush_log_at_trx_commit',
  'log_replica_updates',
  'server_id'
);

SHOW MASTER STATUS;
SHOW REPLICA STATUS\G

SELECT TABLE_SCHEMA, TABLE_NAME, ENGINE
FROM information_schema.TABLES
WHERE TABLE_SCHEMA IN ('shop', 'inventory')
  AND TABLE_TYPE = 'BASE TABLE'
  AND ENGINE <> 'InnoDB';
最后一项应返回空结果。本文的一致性逻辑备份依赖业务表使用 InnoDB;存在非事务表时,不能仅凭 --single-transaction 宣称整个备份一致。
以下是目标配置片段,不是可直接覆盖原文件的完整配置。先通过 mysqld --verbose --help 核对配置文件读取顺序,再备份现有配置并合并调整。
[mysqld]
server_id=101
log_bin=mysql-bin
binlog_format=ROW

gtid_mode=ON
enforce_gtid_consistency=ON
log_replica_updates=ON

sync_binlog=1
innodb_flush_log_at_trx_commit=1
binlog_expire_logs_seconds=604800
从库使用不同的 server_id,保持业务只读;若计划将从库提升为主库,也应准备本地 binlog 与归档链路。
其中,sync_binlog=1 和 innodb_flush_log_at_trx_commit=1 有助于降低异常停机时已提交事务丢失的风险,但会增加持久化写入成本,也不能替代可靠存储和备份。
启用 binlog、调整 GTID 模式或重启实例,可能影响现有复制和业务连接。 已上线实例必须先取得可恢复备份、检查现有复制状态并安排维护窗口。尤其不要把正在使用的非 GTID 拓扑直接改成 GTID 拓扑;应按其转换流程实施。配置回滚时恢复原文件,但不要随意删除日志或重新初始化复制。
下面是一套示例策略,可根据业务 RPO、备份耗时和变更量调整:
| 对象 | 示例频率 | 示例保留周期 | 一致性或可用性要求 |
|---|---|---|---|
| 业务全量备份 | 每日一次 | 14 天 | 同一事务快照、记录日志坐标 |
| binlog 归档 | 持续接收 | 21 天 | 无文件缺口,覆盖最早保留备份 |
| 配置与权限清单 | 每次变更后 | 覆盖全部保留恢复点 | 能重建对应环境 |
| 异地备份副本 | 全量完成后立即复制,日志持续传输 | 按恢复窗口保留 | 与生产故障域分离 |
| 恢复演练 | 每月及重大变更后 | 保留演练记录 | 实际完成导入、回放与业务验证 |
保留策略必须按“全量备份+其后连续日志”的依赖关系执行。 不能保留了 14 天前的全量备份,却只剩最近 7 天的归档日志。源库本地日志保留 7 天,是归档故障的缓冲时间,不代表最终只能恢复 7 天。
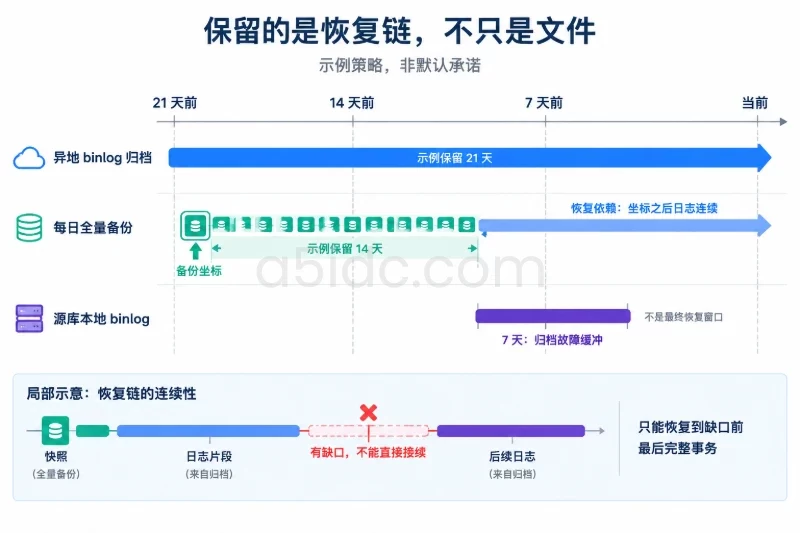
空间估算也应分别计算。例如,每份压缩全量备份约 80 GB,每日日志约 15 GB,则上述保留策略约需要:
这里使用十进制 GB,尚未计入另一套副本、临时文件和恢复盘空间。备份完成后的文件大小应作为后续预算依据,不能仅用数据库目录大小推算。
全量备份账号需要业务库的读取、视图、触发器和事件相关权限,以及读取存储过程定义的权限。本文使用的 --source-data=2 还需要相应的全局日志状态与刷新权限;MySQL 8.0 可结合 SHOW_ROUTINE 等权限按实际对象配置。
日志归档账号使用独立账号,授予读取复制日志所需的 REPLICATION SLAVE 权限;需要查询日志列表、状态时再授予 REPLICATION CLIENT。不要让备份任务长期使用业务写账号或远程 root。
在专用备份主机上,可以建立客户端登录配置:
mysql_config_editor set \
  --login-path=backup \
  --host=db-primary.internal \
  --user=backup_reader \
  --password
密码由交互输入,避免出现在命令行参数中。登录配置文件只是降低明文暴露风险,并非可靠的密码加密保险箱;仍应限制操作系统账号权限,并保护备份主机。
以下命令在备份主机执行,先输出到临时文件,成功后才生成正式备份文件:
#!/usr/bin/env bash
set -euo pipefail
umask 077

ROOT=/srv/mysql-backup
mkdir -p "$ROOT"

WORK=$(mktemp -d "$ROOT/full-$(date -u +%Y%m%dT%H%M%SZ)-XXXXXX")
date -u +%FT%TZ > "$WORK/started_at.txt"

mysqldump --login-path=backup \
  --single-transaction \
  --source-data=2 \
  --set-gtid-purged=OFF \
  --routines \
  --events \
  --triggers \
  --hex-blob \
  --no-tablespaces \
  --default-character-set=utf8mb4 \
  --databases shop inventory \
  2>"$WORK/dump.stderr" \
  | gzip -c > "$WORK/business.sql.gz.part"

gzip -t "$WORK/business.sql.gz.part"
mv "$WORK/business.sql.gz.part" "$WORK/business.sql.gz"

gzip -cd "$WORK/business.sql.gz" \
  | sed -n '/SOURCE_LOG_FILE\|MASTER_LOG_FILE/p' \
  > "$WORK/coordinates.txt"

test -s "$WORK/coordinates.txt"
date -u +%FT%TZ > "$WORK/finished_at.txt"

(
  cd "$WORK"
  sha256sum business.sql.gz coordinates.txt \
    started_at.txt finished_at.txt > SHA256SUMS
)
这组参数的关键边界是:
--single-transaction 为 InnoDB 数据建立一致性快照,但备份期间仍需避免 ALTER TABLE、DROP TABLE、TRUNCATE TABLE 等 DDL。--source-data=2 将源库日志坐标写为注释,配合事务快照用于后续回放。建立坐标时可能短暂取得全局读锁,长事务或 DDL 会延长等待。--set-gtid-purged=OFF 适用于本文的业务逻辑恢复,不自动设置目标实例的 GTID 历史;这份备份不能直接视为新复制节点的完整 GTID 初始化材料。pipefail 确保导出失败不会被压缩程序的成功状态掩盖。备份期间监控锁等待、磁盘吞吐、业务延迟和从库复制状态。超过维护窗口应停止本次备份、保留上一份已验证备份,并检查阻塞原因。失败的 .part 文件不得纳入可恢复备份清单。
为了避免误用坐标,本文从主库导出。如果改在从库执行,必须使用能够记录上游源库坐标的备份流程,并处理复制 SQL 线程与快照的对应关系;不能拿从库自身的 binlog 坐标去回放主库归档日志。
先核对客户端能力与源库日志列表:
mysqlbinlog --version
mysqlbinlog --help | grep connection-server-id
mysql --login-path=backup -e "SHOW BINARY LOGS;"
归档账号另行配置为 archive 登录路径。在受进程管理工具监督的归档任务中,可使用:
mysqlbinlog --login-path=archive \
  --read-from-remote-server \
  --raw \
  --stop-never \
  --connection-server-id=900001 \
  --ssl-mode=VERIFY_IDENTITY \
  --ssl-ca=/etc/mysql/certs/ca.pem \
  --result-file=/srv/mysql-binlog-archive/ \
  mysql-bin.000123
示例中的文件名必须替换为实际起始文件,归档连接编号也应避免冲突。源库证书需要与连接主机名匹配。
--raw 保存可供回放的二进制文件;--stop-never 让客户端继续接收后续日志。实际生产还必须补齐:
不能只监控“归档进程存在”。异地副本只上传关闭文件时,其实际 RPO 还取决于日志轮转和上传间隔;应以异地已持久化的最后一个完整事务衡量恢复覆盖范围。
发生主从切换后,也不能简单按文件名拼接新旧主库日志。不同实例可能使用相同文件名,且事务存在重叠;必须结合源实例身份、切换记录和 GTID,核对缺失与重复。
恢复前先记录事故信息:错误操作涉及哪些库表、应用操作时间、数据库时区、相关账号和事务。随后选择目标时间之前的一份已验证全量备份,取得从备份坐标到目标事务边界的全部日志。
时间点恢复不是“恢复文件修改时间之前的数据”,而是从一致性快照开始,回放连续事务,并在目标事务边界停止。
恢复实例应满足以下条件:
event_scheduler=OFF,防止恢复后的事件自动运行。本文不提供向生产库直接覆盖导入的操作。导入会修改目标业务库,错误指向生产地址可能造成严重影响。
在恢复主机执行:
cd /srv/restore/full-backup
sha256sum -c SHA256SUMS
gzip -t business.sql.gz
校验失败时停止,不继续导入。通过后,将 restore 登录路径明确指向隔离实例:
set -o pipefail

gzip -cd /srv/restore/full-backup/business.sql.gz \
  | mysql --login-path=restore \
      --init-command="SET SESSION sql_log_bin=0"
关闭本次恢复会话的 binlog,需要相应管理权限,作用仅限该连接。它可以避免恢复过程生成另一套难以区分的业务日志,不应改变生产实例的全局日志配置。
视图、存储过程和触发器可能依赖特定 DEFINER。应预先创建所需的受限身份,并在恢复后核对权限;不要通过随意替换所有定义者来掩盖权限问题。
先解码相关日志用于检查,不执行输出内容:
TZ=UTC mysqlbinlog \
  --base64-output=DECODE-ROWS \
  -vv \
  /srv/restore/binlog/mysql-bin.000130 \
  > /srv/restore/inspect-000130.txt
DECODE-ROWS 输出用于阅读行事件,不是本文的正式回放输入。
时间筛选可以缩小检查范围,但不能忽略时区,也不能把停点放在事务中间。应结合 GTID、BEGIN、行事件、Xid 或 COMMIT 确认完整事务边界。
例如,全量备份坐标为 mysql-bin.000123:456789,错误事务从 mysql-bin.000130 的位置 987654 开始。若需要保留该事务之前已经提交的事务,停止位置应选为错误事务开始事件的位置,而不是事务内部某条行事件的位置。
下面文件名和位置均为示例,必须替换为已验证的实际值。日志需要按顺序完整列出:
mysqlbinlog \
  --start-position=456789 \
  --stop-position=987654 \
  --skip-gtids \
  /srv/restore/binlog/mysql-bin.000123 \
  /srv/restore/binlog/mysql-bin.000124 \
  /srv/restore/binlog/mysql-bin.000125 \
  /srv/restore/binlog/mysql-bin.000126 \
  /srv/restore/binlog/mysql-bin.000127 \
  /srv/restore/binlog/mysql-bin.000128 \
  /srv/restore/binlog/mysql-bin.000129 \
  /srv/restore/binlog/mysql-bin.000130 \
  > /srv/restore/replay.sql
在这种多文件调用中,起始位置用于第一个文件,停止位置用于最后一个文件。生成失败时不得执行不完整文件;应检查命令退出状态,并确认结束点符合预期。
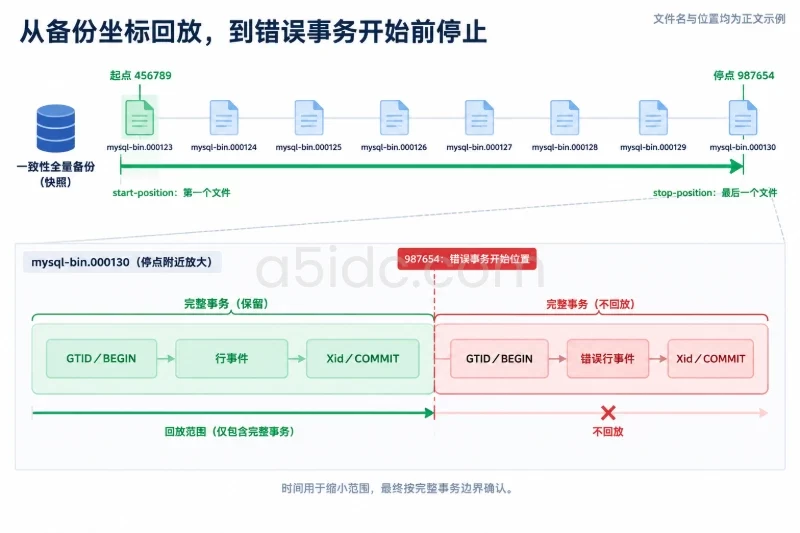
本文通过 --skip-gtids 在隔离实例上重放业务状态,不建立与生产一致的 GTID 历史。验收后的实例若要成为新主库,应另外设计复制重建流程。
正式回放:
mysql --login-path=restore \
  --init-command="SET SESSION sql_log_bin=0" \
  < /srv/restore/replay.sql
不使用 --force 忽略 SQL 错误,也不随意加 --database 过滤。跨库事务、触发器和语句事件可能因此被遗漏。
本文全量备份覆盖指定业务库,但原始 binlog 可能包含账号管理或其他全局语句。回放前需要审查这些内容,回放后重新核对权限和配置;若实例还有其他业务库,必须把它们纳入恢复设计,不能靠临时过滤获得所谓完整恢复。
压缩文件校验通过,只证明文件没有在传输中发生可检测的变化;SQL 导入成功,也不等于恢复结果正确。验收至少包含三层。
检查表、视图、触发器、存储过程和事件是否齐全,确认事件调度器仍处于关闭状态。检查恢复日志是否存在权限、字符集、重复主键或对象缺失错误。
按业务定义选择可复核指标,例如:
不要把恢复库与仍在写入的生产库直接比较总行数。验证参照应属于目标恢复时间,可来自历史对账结果、审计记录或预先保存的业务汇总。
记录下载、导入、回放和业务核验的耗时,总和才是本次恢复时间。
例如,80 GB 备份通过 200 Mbps 链路传输,按十进制单位计算,理想耗时为:
80 × 8 × 1000 ÷ 200 = 3200 秒,即 53 分 20 秒。
这还没有计入传输开销、解压、导入及验证。因此,若目标 RTO 为 2 小时,单靠带宽标称值无法确认是否达标,必须通过完整演练测量。
同时记录最后安全归档事务与事故时刻之间的差距。归档进程在线、日志文件存在,都不能替代这一项 RPO 验证。
| 现象 | 优先检查 | 处理边界 |
|---|---|---|
| 全量导出卡住 | 网络、磁盘、长事务、DDL 与锁等待 | 不先批量终止业务会话 |
| 文件校验失败 | 传输结果、原始副本、存储状态 | 重取文件,不强行解压恢复 |
| 归档进程退出 | 连通性、TLS、权限、磁盘空间 | 先确认日志缺口,再决定续传 |
| 源库日志已清理 | 异地归档、其他保留副本 | 不凭文件名伪造连续链 |
| 回放出现重复键 | 导入是否重复、起点是否错误 | 从干净实例重新恢复 |
| 回放出现对象缺失 | 备份范围、DDL、日志缺口 | 不跳过错误继续上线 |
| 时间点不正确 | 时区、事务开始与提交边界 | 重定边界,重新恢复 |
| 切换后无法连接 | 写入口、权限、连接池、旧连接 | 不立即允许旧主重新写入 |
当日志缺口无法补齐时,应明确报告“只能恢复到缺口之前的最后一个完整事务”,不能把较新的文件直接接上去宣称恢复成功。
隔离恢复失败时,保留执行日志、备份编号和回放边界,停止使用当前恢复实例,重新准备干净实例。不要在半恢复状态上反复导入,否则容易产生重复数据或掩盖错误。
备份配置变更失败时,恢复原配置并按维护流程重启;保留旧备份与归档,不要为了回滚删除已有恢复材料。
恢复结果验收后,先暂停业务写入并阻断旧主写入口,再切换连接地址。切换前保存旧实例状态和最后可取的日志,新实例重新建立备份与复制后才进入正常运行。
回滚边界取决于新实例是否已经接受写入。
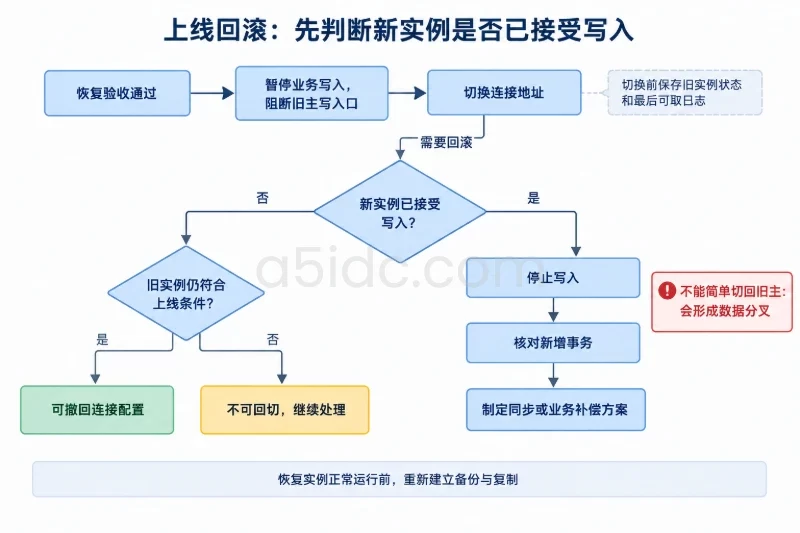
时间点恢复还意味着目标时间之后的有效事务可能一并被排除。支付回调、消息队列、缓存及外部系统状态需要单独核对,必要时做补录和对账,不能只看数据库启动成功就结束事故处理。
验收交付应是一份可复现的恢复记录:明确使用哪份备份、哪些日志、停止在哪个事务边界,以及恢复后通过了哪些业务检查。这样的记录,才足以证明香港服务器上的 MySQL 高可用架构不仅能够切换,也具备经过验证的数据恢复能力。