香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


缓存命中率高时,美国服务器上的 NVMe 与 SATA SSD 在数据库随机读写上的差异可能明显减弱,但不会自动消失。对于已经命中数据库缓冲池的读取请求,通常不需要访问存储设备,NVMe 的低延迟优势自然难以体现;但事务日志刷盘、脏页回写、检查点、临时文件、缓存未命中和故障恢复仍会触发存储 I/O。
因此,“缓存命中率高,所以 NVMe 和 SATA SSD 对数据库性能影响不大”只能在特定读请求成立。若数据库包含较多写事务、要求较低提交延迟,或者业务存在高并发随机读、临时表、报表扫描和缓存抖动,随机读写差异仍可能体现在提交延迟、P95/P99 响应时间、吞吐上限和恢复时间上。
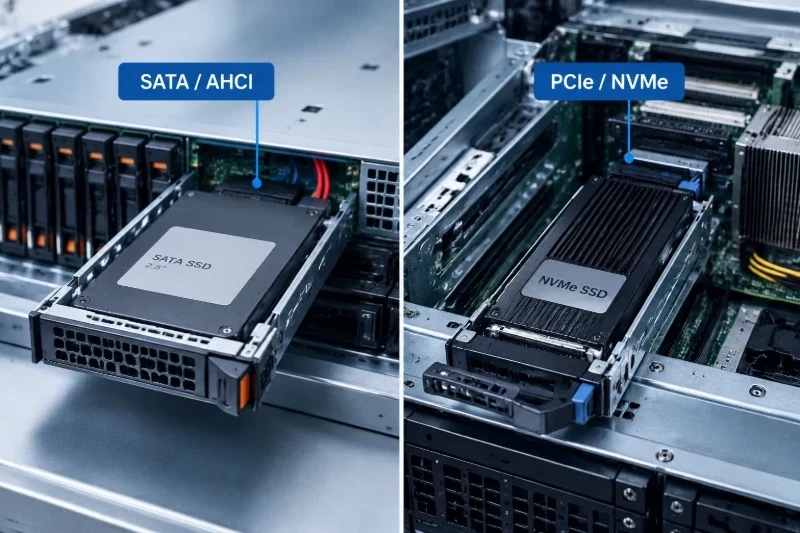
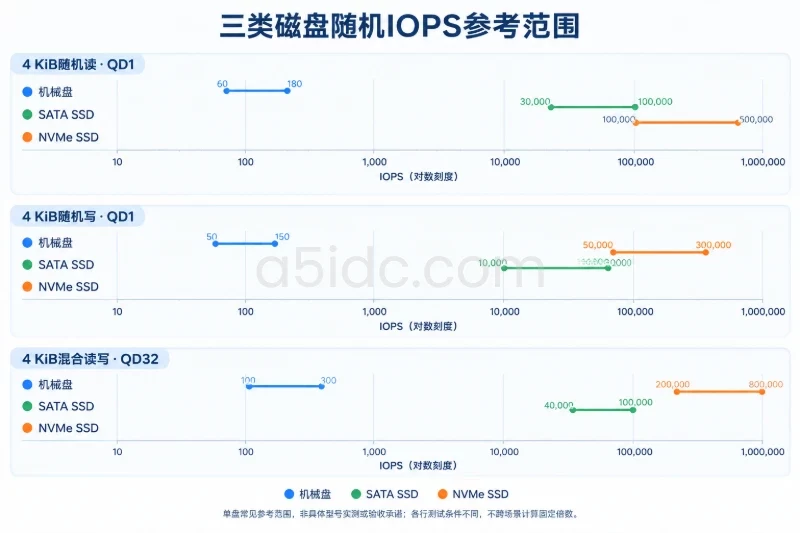
NVMe 与 SATA SSD 的差异,通常来自连接协议、队列能力、设备并发处理能力和单次 I/O 延迟,而不只是“容量相同但接口不同”。
SATA SSD 通过 SATA 协议连接,接口理论带宽受到 SATA 链路限制;NVMe SSD 通常通过 PCIe 连接,并针对非易失性存储设计了更高效的队列和命令处理方式。在并发随机 I/O、低延迟提交和高 IOPS 场景下,NVMe 通常更有优势。
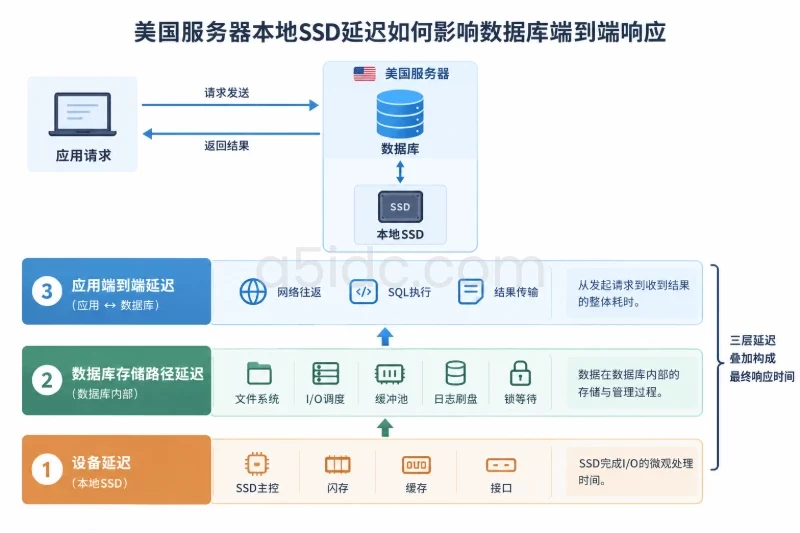
但数据库并不是每次查询都直接读取 SSD。一次查询可能经历以下路径:
如果大多数请求停留在前两步,存储设备只承担少量读取工作,NVMe 与 SATA SSD 的差异当然可能变得不明显。
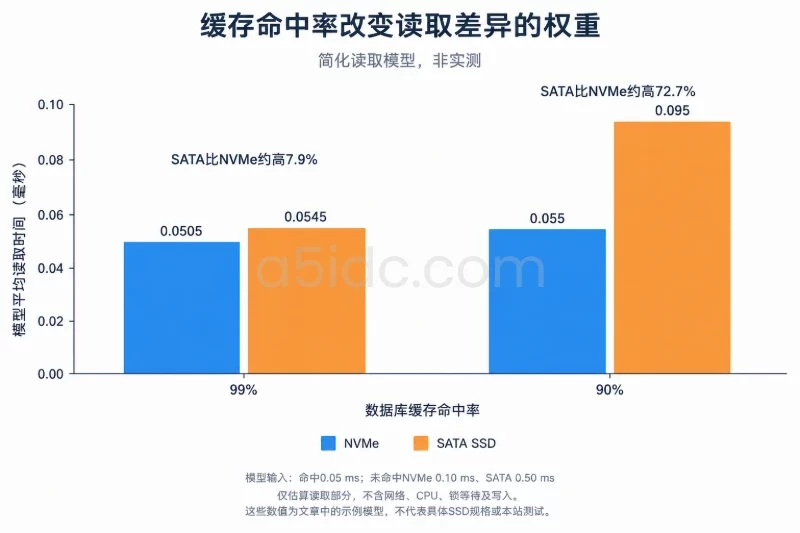
假设数据库有 10,000 次逻辑读取请求,缓存命中率为 99%,意味着约有 100 次读取没有命中数据库缓存:
如果缓存命中的处理时间约为 0.05 毫秒,缓存未命中后使用 NVMe 的读取时间约为 0.10 毫秒,使用 SATA SSD 的读取时间约为 0.50 毫秒,那么仅从这组读取估算:
两者相差约 7.9%,对整体查询耗时的影响可能很小,尤其是在应用与美国服务器之间还存在较高网络延迟、数据库查询本身还涉及锁等待或 CPU 计算时。
但是,如果缓存命中率降到 90%,同样的计算变为:
此时读取部分的差异约为 72.7%。这不是在说明所有 NVMe 与 SATA SSD 都符合这些延迟,而是说明缓存命中率会改变存储差异在整体性能中的权重。
数据库监控中常见的“缓存命中率”并不一定指同一个指标。将应用缓存、数据库缓冲池和操作系统页缓存混在一起,容易得出过于乐观的判断。
如果商品详情、会话信息或热点查询结果已经由应用缓存返回,数据库没有收到请求,那么这部分请求与 NVMe、SATA SSD 基本无关。
但应用缓存通常只覆盖一部分业务路径。写入、缓存失效、后台任务、权限校验、分页查询和个性化查询仍可能进入数据库。不能用应用缓存命中率替代数据库整体 I/O 判断。
PostgreSQL 的 shared_buffers、MySQL InnoDB 的 Buffer Pool 都属于数据库缓冲机制。数据页和索引页命中缓冲池后,查询通常不需要从存储设备读取对应页面。
数据库缓冲池命中率高,往往说明热点数据适合放在内存中,但它无法直接回答以下问题:
以 PostgreSQL 为例,统计视图中的 blks_hit 和 blks_read 主要反映数据库共享缓冲区层面的命中和读取。blks_read 并不等于每次都已经落到物理 SSD;数据还有可能由操作系统页缓存提供。
因此,数据库显示缓存未命中,并不必然代表 SATA 或 NVMe 设备已经产生了同等数量的物理读请求。需要结合 iostat、设备延迟和队列情况判断。
反过来,数据库层面缓存命中率很高,也不代表存储设备空闲。事务日志、脏页回写、临时文件和其他数据库实例可能在持续使用存储。
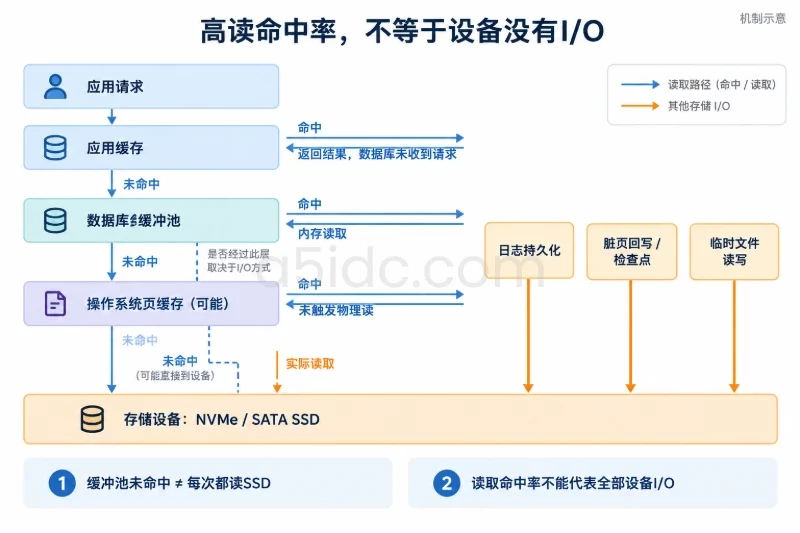
这是最容易被忽略的边界。
一个订单系统可能有 99%以上的热点数据读取命中率,但每次订单创建仍需要执行以下操作:
读取缓存命中并不会跳过这些写入过程。
数据库通常会先记录日志,再将数据页异步或批量写回。日志写入常常具有较强的顺序性,但提交时的 fsync 或等效持久化操作仍然受到设备延迟影响。
数据页回写则可能表现为大量随机写,特别是在以下情况下:
一个简化的写入例子是:每秒有 3,000 次事务提交,每次事务平均产生约 4 KiB 日志。仅按日志数据量估算:
这个数据量并不一定会超过 SATA SSD 的持续带宽,但数据库性能可能仍受影响,因为每次提交关心的不只是每秒写多少 MB,还包括单次刷盘延迟、并发队列和尾延迟。日志写入还可能发生组提交,因此真实 I/O 形态不能简单等同于“每个事务一次独立 4 KiB 写入”。
如果为了提高吞吐而降低刷盘要求,NVMe 与 SATA SSD 的差异可能被掩盖,但代价是断电或系统异常时的数据安全边界发生变化。
比较时应保持数据库持久性配置一致,例如:
fsync、synchronous_commit、full_page_writes;innodb_flush_log_at_trx_commit、sync_binlog;不能通过关闭关键持久性设置来证明 SATA SSD 足够,也不能在一台服务器上使用宽松设置、另一台使用严格设置后直接比较 NVMe 和 SATA SSD。
平均响应时间容易掩盖少量慢请求。
假设 99.5%的读取请求命中缓存,剩下 0.5%的请求需要从存储读取。对于每秒 20,000 次逻辑读取:
从带宽角度看,这个读流量很低,SATA SSD 可能完全能够承担。但如果这 100 次读取集中在同一批接口、同一类租户或同一组索引页上,SATA SSD 较高的单次延迟仍可能把这些请求推入 P95 或 P99。
这类问题通常表现为:
数据库应用更应该观察分位数延迟,而不是只看平均值。缓存命中率高只能说明大多数逻辑读取没有触发对应层级的读取,不能保证尾部请求也具备相同延迟。
排序、分组、哈希连接、临时表和中间结果可能使用临时文件。它们不一定显著降低数据库主表的缓存命中率,却可能对 SSD 产生额外读写压力。
典型场景包括:
work_mem;此时,监控中的主表缓存命中率可能依然很高,但设备层面的写入量、队列长度和等待时间已经上升。NVMe 更高的并发处理能力通常有助于降低这类混合负载的相互干扰,但最终效果仍取决于设备型号、虚拟化方式和数据库配置。
数据库的平稳查询阶段,不代表全天所有阶段都相同。
检查点会将一部分脏页写回数据文件。如果脏页积累较多,检查点可能产生短时间的写入高峰。缓存命中率统计主要描述读取是否命中,并不能反映脏页回写的压力。
在 SATA SSD 上,检查点写入可能更容易造成队列积压;NVMe 也不是完全不受影响,只是通常能够在更高并发下处理更多 I/O。若数据库的检查点策略不合理,单纯更换存储只能缓解问题,不能消除写入集中。
PostgreSQL 的自动清理、索引维护,MySQL 的表重建和统计信息更新,都可能读取大量数据并产生额外写入。它们与在线业务共享同一存储设备时,缓存命中率不能代表维护任务的 I/O 成本。
系统重启后,数据库需要重放事务日志。复制延迟较高的副本也可能需要持续读取日志、访问数据页并执行写入。恢复阶段的性能通常比热缓存查询更依赖存储延迟和持续 I/O 能力。
因此,如果业务要求较短的重启恢复时间、较快的副本追赶速度或较低的复制延迟,NVMe 与 SATA SSD 的差异可能比在线热查询阶段更明显。
“美国服务器使用 NVMe”并不必然等于获得某种固定性能,“使用 SATA SSD”也不等于性能一定不足。需要确认存储设备实际如何提供给服务器。
在美国服务器环境中,常见的存储形态包括:
虚拟机里显示为 NVMe,并不一定意味着底层是独占本地 NVMe;显示为 SATA,也不一定意味着底层只有一块低性能消费级 SSD。虚拟化层、宿主机调度、存储网络、共享池限速和突发策略都可能改变实际结果。
Linux 中可以先使用只读查询确认设备呈现方式:
lsblk -o NAME,TYPE,ROTA,TRAN,MODEL,SIZE,MOUNTPOINT
ROTA、TRAN 和 MODEL 只能作为初步线索。在虚拟化或云块存储环境中,系统暴露的设备信息可能无法完整反映底层硬件,仍需要结合服务商对 IOPS、延迟、突发、限速、持久性和故障恢复的说明。
美国服务器的“美国”属性,主要影响应用到服务器之间的网络距离和访问延迟,不会直接改变 NVMe 与 SATA SSD 的协议差异。
如果用户在其他地区访问美国服务器,单次请求可能包含几十毫秒甚至更高的网络往返时间。在这种情况下,数据库内部多出 0.2 或 0.4 毫秒的存储读取延迟,可能被网络延迟、TLS、应用处理和接口排队掩盖。
但以下情况仍可能放大本地存储差异:
所以不能用“用户距离美国服务器较远”直接推断 SATA SSD 足够,也不能用“美国服务器网络延迟高”否定 NVMe 的价值。
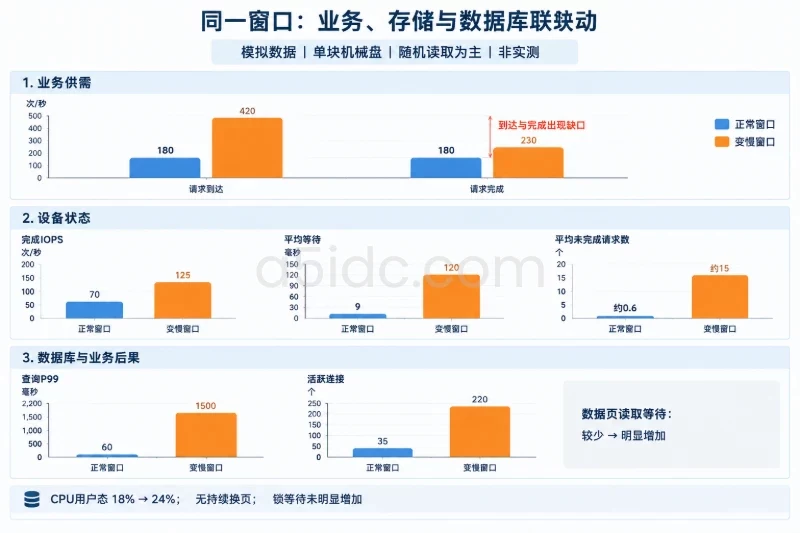
验证重点不是只读取一个缓存命中率,而是把数据库逻辑指标和设备实际指标放在同一时间窗口内观察。
PostgreSQL 可以查看数据库累计的共享缓冲区命中和读取情况:
SELECT
    datname,
    blks_hit,
    blks_read,
    ROUND(
        100.0 * blks_hit / NULLIF(blks_hit + blks_read, 0),
        2
    ) AS shared_buffer_hit_pct
FROM pg_stat_database
WHERE datname IS NOT NULL;
这个结果是累计统计,不能直接代表最近五分钟。应在业务高峰前后记录两次,使用差值计算时间窗口内的命中率,并分别观察在线业务库、报表库和后台任务。
MySQL InnoDB 可以查看 Buffer Pool 相关计数:
SHOW GLOBAL STATUS
WHERE Variable_name IN (
    'Innodb_buffer_pool_read_requests',
    'Innodb_buffer_pool_reads',
    'Innodb_buffer_pool_read_ahead',
    'Innodb_buffer_pool_read_ahead_evicted'
);
可以用以下方式理解核心比例:
Innodb_buffer_pool_read_requests;Innodb_buffer_pool_reads;1 - 物理读取次数 / 逻辑读取请求次数。不同 MySQL 版本和统计更新方式可能存在差异,仍应结合时间差值,而不是只看服务器启动以来的累计数值。
Linux 上可以使用 iostat 观察设备级别的读写等待:
iostat -xmd 1
重点关注:
r_await:平均读请求等待时间;w_await:平均写请求等待时间;aqu-sz:平均队列长度;%util:设备忙碌程度;不同 sysstat 版本的字段显示可能略有区别,先确认已安装对应工具,并确认观察的是数据库实际使用的设备,而不是系统盘或其他挂载点。
如果数据库缓存命中率维持在 99%以上,但 w_await 在提交高峰明显升高,说明问题可能在日志刷盘或脏页回写,而不是缓存读取。若 r_await 只在报表运行时上升,则应单独分析报表查询和临时文件。
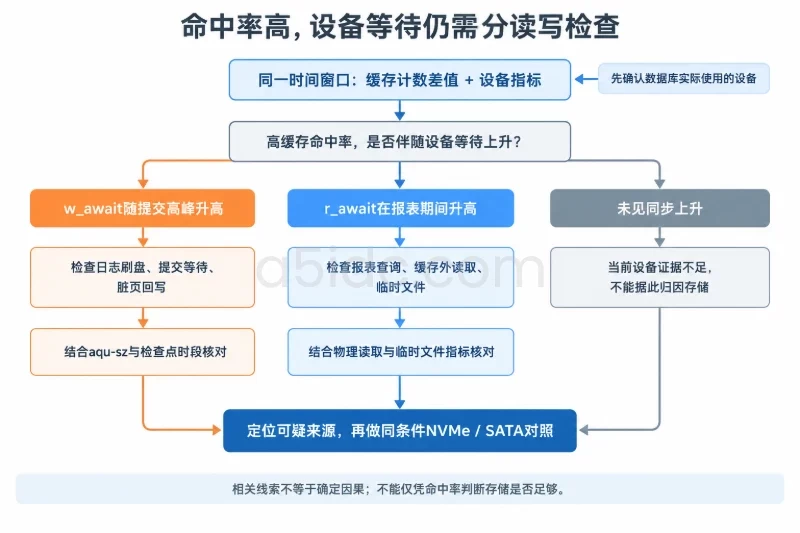
不要把所有存储 I/O 汇总成一个数字。至少应分别观察:
| I/O 类型 | 主要来源 | 需要关注的指标 | NVMe/SATA 差异可能体现的位置 |
|---|---|---|---|
| 随机读 | 缓存未命中、索引访问、冷数据查询 | r_await、物理读次数、P95/P99 | 冷查询延迟、并发读取上限 |
| 日志写 | WAL、Redo Log、二进制日志 | 刷盘延迟、提交等待、复制延迟 | 事务提交和同步复制 |
| 随机数据写 | 脏页回写、检查点、索引更新 | w_await、队列长度、写入峰值 | 检查点和写入高峰 |
| 临时 I/O | 排序、哈希、临时表 | 临时文件大小和数量、设备写入 | 报表、复杂查询、批处理 |
| 恢复 I/O | 日志重放、副本追赶 | 恢复速度、复制延迟 | 故障恢复和副本同步 |
数据库总体命中率可能掩盖少数高成本查询。应从慢查询日志、数据库统计视图或查询分析工具中找出:
以 PostgreSQL 为例,EXPLAIN (ANALYZE, BUFFERS) 可以帮助查看查询使用了多少缓存命中和实际读取。由于 ANALYZE 会真正执行查询,生产环境应选择只读、低风险、可控范围的语句,并评估额外负载;涉及写入的语句不能直接在生产环境随意执行。
如果只做热缓存测试,容易得出“NVMe 与 SATA 没区别”;如果只做冷缓存测试,又可能夸大存储对日常业务的影响。更合理的方式是至少准备两组场景:
| 对照场景 | 数据状态 | 主要回答的问题 |
|---|---|---|
| 热缓存读取 | 工作集已稳定加载到内存 | 日常热点查询是否受存储影响 |
| 冷数据读取 | 工作集明显大于可用缓存,或使用独立测试副本 | 未命中读取的延迟差异 |
| 写入与提交 | 保持持久性配置一致 | 日志刷盘和提交等待是否受影响 |
| 混合负载 | 读写、报表、后台任务同时运行 | 设备在竞争场景下的尾延迟 |
| 检查点或维护 | 模拟脏页回写和后台任务 | 高峰期队列是否堆积 |
| 恢复或副本追赶 | 使用测试副本和可控日志量 | 恢复速度是否成为瓶颈 |
冷缓存测试不应直接在生产服务器上清空系统缓存或删除数据库缓存。更安全的做法是使用数据副本、独立测试卷或可回滚的测试实例。涉及真实数据库文件的复制、覆盖和恢复操作,都应先确认备份、影响范围和回滚路径。
NVMe 的宣传参数和 SATA SSD 的顺序吞吐参数,不能直接代表数据库随机 I/O 表现。数据库测试至少应考虑以下变量:
同一台机器上比较时,应尽量保持以下条件一致:
如果无法在同一服务器更换存储设备进行对照,至少应使用同一类 CPU、内存、虚拟化规格和数据库参数,并确认两台美国服务器没有不同的宿主机限速策略。否则,测到的可能是宿主机或云存储差异,而不是 NVMe 与 SATA 协议差异。
若要先建立美国服务器的NVMe测试基线,可将A5数据的美国AMD EPYC 4584PX方案作为规格参照:该套餐搭配64GB DDR5内存和960GB NVMe。先判断这组内存与磁盘容量能否容纳你的热点工作集、数据库及日志,再决定是否纳入测试;它提供的是具体硬件候选,并非SATA对照结果,也不能仅凭NVMe标识推断提交延迟或长尾表现。
以下条件同时满足时,NVMe 与 SATA SSD 对在线查询的差异通常可能被其他因素掩盖:
这里的“暂时不把 NVMe 作为首要因素”不等于 SATA SSD 在任何扩容阶段都够用。数据量增长、缓存命中率下降、事务量上升或业务从读多写少变为高频写入后,原来的判断可能失效。
以下条件出现时,应把 NVMe 纳入重点对照,而不是只看缓存命中率:
w_await、队列长度或提交等待明显上升;在这些场景中,NVMe 的价值不一定体现为“所有查询都快很多”,更可能体现为高并发下队列不容易堆积、提交延迟更稳定,以及后台任务对在线请求的干扰更小。
最终判断可以保留为一个条件句:缓存命中率高时,NVMe 与 SATA SSD 对缓存内随机读取的影响确实可能很小;但只要数据库仍需要等待日志持久化、处理缓存未命中、写回脏页、生成临时文件或执行恢复,随机读写差异就仍然可能影响数据库性能。
对于美国服务器,选择前还应确认存储是本地盘还是共享块存储、是否存在 IOPS 或突发限制、虚拟机看到的 NVMe 是否对应独占设备,以及服务商能否说明持续延迟和故障恢复边界。只有把数据库缓存、提交写入、设备队列和业务长尾放在同一组数据中,才能判断 SATA SSD 的性能是否真的足够,或者 NVMe 的额外能力是否能够转化为可观察的数据库收益。