香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


把海外服务器从 CUBIC 切换到 BBR,不应设计成一次性修改全机参数并立即重启的操作。生产变更的目标应是:在确认内核支持、出口网卡和业务流量范围后,仅让新建 TCP 连接逐步使用 BBR,同时保留原始 CUBIC、队列规则和持久化配置的可恢复副本。
这类变更的主要风险不在于命令本身,而在于影响面容易被低估。BBR可能改变出口带宽占用、队列长度、重传行为和不同业务之间的带宽公平性;net.core.default_qdisc只决定默认队列,当前网卡上的实际 qdisc 还可能需要单独处理。生产方案应按照“现状核对—备份准备—小流量实施—分阶段观察—满足条件才扩容”的顺序执行。
本次变更通常包含两个目标:
fq 队列,或者确认现有队列已经满足业务和内核要求。目标配置一般如下:
net.ipv4.tcp_congestion_control = bbr
net.core.default_qdisc = fq
但这两个参数的作用范围并不完全相同:
| 配置项 | 作用 | 是否立即迁移已有连接 | 影响范围 |
|---|---|---|---|
net.ipv4.tcp_congestion_control | 新建 TCP Socket 的默认拥塞控制算法 | 否 | 主要影响主机上的 TCP 连接 |
net.core.default_qdisc | 新注册网络设备时采用的默认队列规则 | 否 | 主要影响后续创建或重新初始化的网络设备 |
| 网卡当前 root qdisc | 当前接口实际使用的排队规则 | 不适用 | 可能影响该接口上的全部流量,包括部分非 TCP 流量 |
因此,修改 net.core.default_qdisc=fq 不等于当前网卡已经切换为 fq。如果当前接口仍然使用 fq_codel、pfifo_fast、noqueue 或复杂的 classful qdisc,需要单独核对是否要修改。
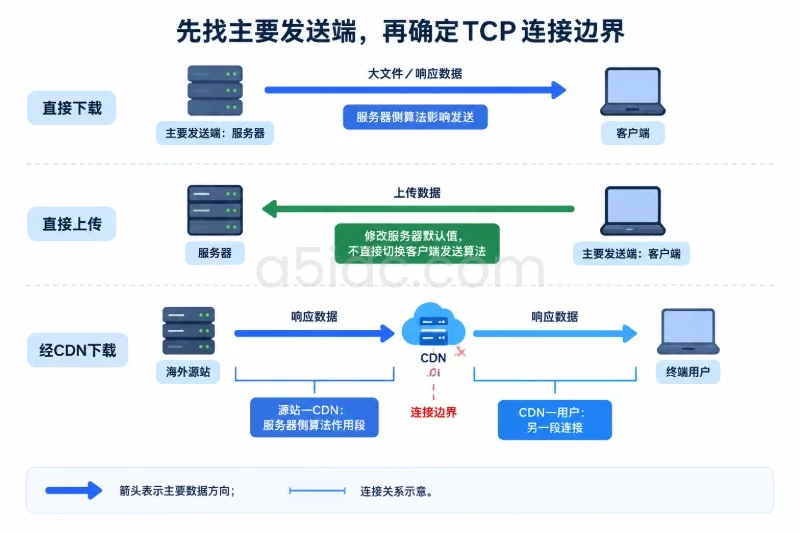
BBR控制的是本机 TCP 发送方向的拥塞控制,不能改变通信对端的算法。
| 流量类型 | 服务器侧切换 BBR 的可能影响 |
|---|---|
| 服务器向海外用户返回网页、文件或 API 响应 | 通常会影响服务器出口方向的新 TCP 连接 |
| 服务器向上游数据库、对象存储或 API 发起 TCP 请求 | 通常会影响服务器到上游的发送方向 |
| 海外用户向服务器上传文件 | 主要由客户端的拥塞控制算法决定,服务器不能替客户端切换 BBR |
| UDP 业务 | 不受 Linux TCP 拥塞控制参数直接影响 |
| QUIC 等基于 UDP 的协议 | 通常由协议实现自身管理拥塞控制,不使用 Linux TCP 的 tcp_congestion_control |
对于跨地区业务,不能只看主机整体平均值。至少应按业务方向、目标地区、运营商或上游网络分别观察。某一条海外线路改善,不代表其他线路也会同步改善。
长肥管道通常意味着带宽高、RTT较大,带宽时延积较高。例如:
带宽时延积为:
1,000,000,000 bit/s × 0.18 s ÷ 8 = 22,500,000 bytes
也就是约 22.5 MB。
这个数值用于判断链路理论上可能需要多少在途数据,并不意味着应直接把 tcp_rmem、tcp_wmem 或 net.core.wmem_max 设置成 22.5 MB。Linux TCP接收窗口、应用读取速度、发送缓冲区、网卡队列和中间设备都会影响实际结果。没有基线数据时,盲目放大缓存可能增加内存占用和排队延迟,甚至掩盖应用处理能力不足。
先记录操作系统、内核版本和当前拥塞控制算法。不要根据“某个发行版通常支持 BBR”直接进入实施。
uname -a
cat /etc/os-release

sysctl -n net.ipv4.tcp_congestion_control
sysctl -n net.ipv4.tcp_available_congestion_control
sysctl -n net.ipv4.tcp_allowed_congestion_control 2>/dev/null || true
正常情况下,tcp_available_congestion_control 可能包含类似以下内容:
reno cubic bbr
如果列表中没有 bbr,可以尝试加载发行版已经提供的内核模块:
sudo modprobe tcp_bbr
sysctl -n net.ipv4.tcp_available_congestion_control
如果 modprobe tcp_bbr 失败,或者加载后仍然没有 bbr,本次变更应停止。不要在生产窗口内临时安装来源不明的内核脚本或替换内核。需要升级内核时,应把“内核升级、重启、启动后验证”作为独立变更,不能和拥塞控制切换混在同一个回滚单元中。
BBR v1 与 BBR v2 也不能仅凭名称判断。不同发行版可能对内核做了回移植,tcp_bbr 模块名称相同并不代表实现版本相同。生产记录中应至少保存以下信息:
uname -r 的内核版本;tcp_available_congestion_control 输出;modinfo tcp_bbr 是否可用;如果本次目标只是从 CUBIC 切到 BBR,应优先使用当前发行版已经验证过的 bbr,不要同时引入 BBR v2、第三方补丁或自定义内核。
先找到真实承载业务流量的接口。不要默认使用 eth0,云主机可能使用 ens3、enp1s0 或其他命名。
DEST_IP=198.51.100.10
ip route get "$DEST_IP"
示例输出可能类似:
198.51.100.10 via 192.0.2.1 dev ens3 src 192.0.2.20
记录其中的 dev 网卡名,再查看当前队列:
IFACE=ens3

ip -details link show dev "$IFACE"
tc qdisc show dev "$IFACE"
重点记录:
如果输出显示当前接口是复杂的 classful qdisc,或者由云平台网络代理管理,不应直接执行 tc qdisc replace ... root fq。这会覆盖当前 root qdisc,可能使流量分类、限速、优先级或容器网络行为发生变化。
先查看现有值,避免把与本次目标无关的 TCP 参数一起改掉:
sysctl \
  net.ipv4.tcp_congestion_control \
  net.core.default_qdisc \
  net.ipv4.tcp_moderate_rcvbuf \
  net.ipv4.tcp_rmem \
  net.ipv4.tcp_wmem \
  net.core.rmem_max \
  net.core.wmem_max
建议按照以下原则处理:
| 参数 | 初次切换建议 |
|---|---|
net.ipv4.tcp_congestion_control | 仅切换为已验证的 bbr |
net.core.default_qdisc | 在内核支持且没有网络编排冲突时设置为 fq |
net.ipv4.tcp_moderate_rcvbuf | 保持当前值,通常不因切 BBR 单独修改 |
net.ipv4.tcp_rmem、net.ipv4.tcp_wmem | 先保持现状,根据吞吐和窗口证据另行调整 |
net.core.rmem_max、net.core.wmem_max | 先保持现状,避免无依据扩大内核内存上限 |
tcp_tw_reuse、tcp_syncookies、tcp_mtu_probing | 不作为 BBR 切换的附带调整项 |
如果业务当前存在 PMTU异常、应用发送缓慢、接收端窗口不足或明显的内存压力,应先单独处理这些问题。一次变更同时修改拥塞控制、MTU、Socket缓冲区和连接回收参数,出现问题后很难定位根因。
至少保存一个完整业务周期内的基线。跨地区业务建议覆盖低峰和一个高峰时段,避免只用几分钟的平均值做判断。
需要记录的指标包括:
可以使用以下命令辅助采集主机层数据。不同发行版的计数器名称可能略有差异,命令输出应以实际系统为准。
ss -s
ss -tin state established | sed -n '1,120p'

nstat -az 2>/dev/null | egrep \
  'TcpRetransSegs|TcpTimeout|TCPTimeout|TCPSynRetrans|TCPBacklogDrop' || true

sar -n DEV 1 5 2>/dev/null || true
ip -s link show dev "$IFACE"
主机指标只能作为辅助。最终放行标准应优先使用业务指标,例如“海外下载成功率不下降、指定地区 p95 不恶化、吞吐达到预期区间”。
建议使用独立的变更编号目录保存现场数据,不直接覆盖原有配置文件。
TS=$(date +%Y%m%d-%H%M%S)
BACKUP="/var/backups/bbr-change-${TS}"

sudo install -d -m 0700 "$BACKUP"

sudo sysctl -a > "$BACKUP/sysctl-all.txt"
sudo sysctl \
  net.ipv4.tcp_congestion_control \
  net.core.default_qdisc \
  net.ipv4.tcp_rmem \
  net.ipv4.tcp_wmem \
  net.core.rmem_max \
  net.core.wmem_max \
  > "$BACKUP/tcp-selected.txt"

sudo tc qdisc show > "$BACKUP/qdisc-all.txt"
sudo ip -details link show > "$BACKUP/link-details.txt"

sudo cp -a /etc/sysctl.d "$BACKUP/sysctl.d"
sudo cp -a /etc/modules-load.d "$BACKUP/modules-load.d"
同时单独记录本次变更使用的接口和原始值:
echo "interface=$IFACE" | sudo tee "$BACKUP/change-state.txt"
echo "old_cc=$(sysctl -n net.ipv4.tcp_congestion_control)" | \
  sudo tee -a "$BACKUP/change-state.txt"
echo "old_default_qdisc=$(sysctl -n net.core.default_qdisc)" | \
  sudo tee -a "$BACKUP/change-state.txt"
sudo tc qdisc show dev "$IFACE" | sudo tee "$BACKUP/qdisc-${IFACE}.txt"
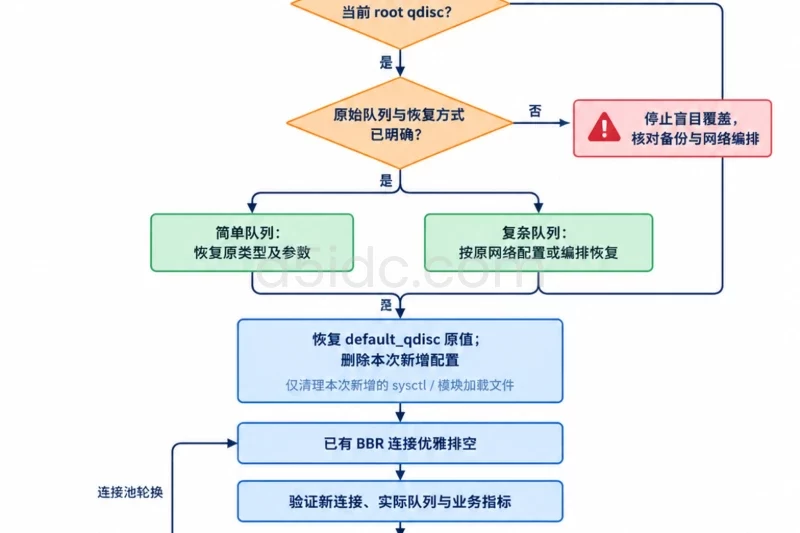
tc qdisc show 的输出是恢复依据,但不一定能直接作为回滚命令。简单的 fq_codel 或 pfifo_fast 可以按原类型恢复;复杂的层级队列必须按照网络配置管理工具或原始编排文件恢复。
变更前必须确认至少有一种不依赖当前业务连接的管理路径:
不能只依赖一条正在经过海外线路的 SSH连接。BBR切换本身通常不会中断 SSH,但覆盖 root qdisc、网络服务重载或错误的持久化配置可能导致连接质量恶化。执行 qdisc变更时,应保留当前管理会话,并从独立终端验证新的登录路径。
net.ipv4.tcp_congestion_control 是主机级默认值,不适合在同一台承载大量不同业务的服务器上直接当成精细化灰度开关。优先级从高到低如下:
如果只有一台服务器,至少要安排低峰窗口、准备管理控制台,并把变更限制在较短的观察阶段。单机无法同时保留 CUBIC 与 BBR 的对照组,结论可信度会下降。
阈值应在实施前确定,不能等出现争议时临时修改。下面是一组可作为起点的示例,实际数值应结合业务基线调整:
| 观察项 | 示例回滚条件 |
|---|---|
| 业务成功率 | 相比基线下降超过 1 个百分点,或连续 5 分钟明显低于历史正常范围 |
| p95/p99延迟 | 同一地区、同一业务接口持续 10 分钟上升超过基线的 20% |
| 吞吐 | 目标方向吞吐下降超过 15%,且不是请求量下降造成 |
| TCP重传 | 重传率较基线增加 30%以上,并伴随吞吐下降或延迟升高 |
| 连接错误 | 超时、RST、连接池耗尽或上游错误出现持续异常 |
| 主机资源 | softnet backlog、网卡丢包、软中断或 CPU 长时间高于预设水位 |
| 其他业务公平性 | 非目标业务出现可归因于队列替换的排队延迟或丢包 |
“单个短时尖峰”不一定需要回滚,但业务错误、连接大量失败、管理通道不稳定属于硬门槛,不应等待完整观察窗口。
在 canary 主机或灰度节点执行:
sudo modprobe tcp_bbr

sysctl -n net.ipv4.tcp_available_congestion_control
sysctl -n net.ipv4.tcp_congestion_control
确认输出中包含 bbr 后,才进入下一步。如果模块加载成功但列表中没有 BBR,应停止变更并检查内核配置,不要继续写入持久化配置。
如果 tcp_bbr 是模块而不是内核内置组件,重启后是否自动加载需要单独处理。只有在确认 modinfo tcp_bbr 可用、且发行版使用标准 modules-load 机制时,才考虑写入:
modinfo tcp_bbr >/dev/null 2>&1
echo $?
返回 0 后,可以创建独立文件:
printf '%s\n' tcp_bbr | sudo tee /etc/modules-load.d/tcp-bbr.conf
sudo chmod 0644 /etc/modules-load.d/tcp-bbr.conf
如果 BBR 已经编译进内核,不需要为了持久化强行创建该文件。无论哪种情况,都应在测试重启或下一次计划重启后重新验证。
如果当前网卡已经是 fq,通常不需要再次替换:
tc qdisc show dev "$IFACE"
如果当前是 fq_codel,BBR仍可能正常工作,是否切换到 fq应由测试数据和队列策略决定。不要把“推荐 fq”理解为“所有现有 qdisc 都必须立即替换”。
只有在以下条件同时满足时,才考虑替换当前 root qdisc:
示例命令如下,但不能脱离现状直接复制执行:
IFACE=ens3
sudo tc qdisc show dev "$IFACE"

# 仅在已确认要使用 fq,且当前 root qdisc 可被安全替换时执行
sudo tc qdisc replace dev "$IFACE" root fq

sudo tc qdisc show dev "$IFACE"
tc qdisc replace 会影响该网卡上的排队行为。它不是只对 BBR连接生效,UDP、其他 TCP业务以及共享该接口的服务都可能受到影响。对于复杂 qdisc,不建议在本文这类 BBR变更中顺带重构队列。
在确认模块和队列状态后,先通过运行时参数验证:
sudo sysctl -w net.ipv4.tcp_congestion_control=bbr
sudo sysctl -w net.core.default_qdisc=fq

sysctl -n net.ipv4.tcp_congestion_control
sysctl -n net.core.default_qdisc
需要注意,net.core.default_qdisc=fq不一定会立刻改变当前接口的 qdisc。当前接口是否使用 fq,仍应通过以下命令确认:
tc qdisc show dev "$IFACE"
如果运行时验证通过,再使用单独的配置文件持久化,避免直接编辑 /etc/sysctl.conf 或覆盖发行版已有文件:
sudo tee /etc/sysctl.d/99-bbr-change.conf >/dev/null <<'EOF'
net.ipv4.tcp_congestion_control = bbr
net.core.default_qdisc = fq
EOF

sudo chmod 0644 /etc/sysctl.d/99-bbr-change.conf
sudo sysctl -p /etc/sysctl.d/99-bbr-change.conf
重新加载后再次检查:
sysctl -n net.ipv4.tcp_congestion_control
sysctl -n net.core.default_qdisc
sysctl -n net.ipv4.tcp_available_congestion_control
不建议在同一时间执行 sysctl --system,因为它可能重新加载多个目录中的全部参数,把与本次变更无关的配置错误一并带入生产环境。
修改默认算法不会把已经建立的 CUBIC连接强制迁移为 BBR。变更后的一段时间内,同一台服务器上可能同时存在两类连接:
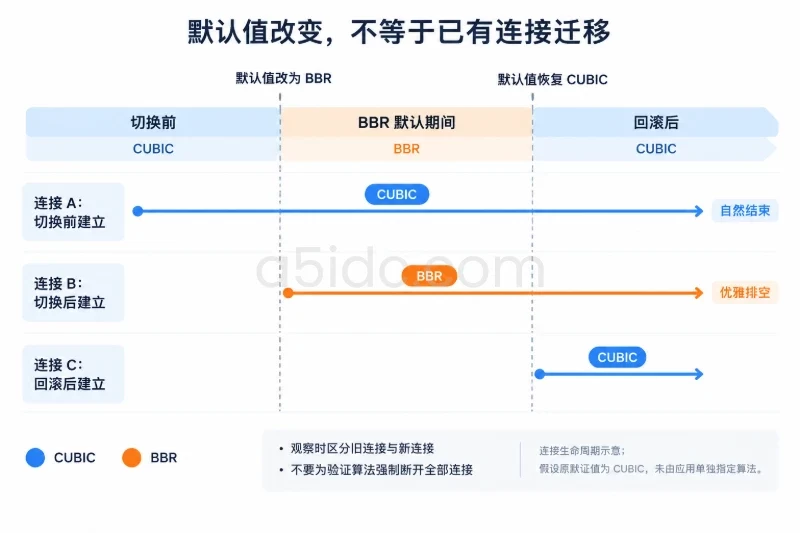
可以通过 ss 查看部分连接信息:
sudo ss -tin state established | sed -n '1,160p'
不同版本的 ss 对 TCP_INFO 的展示格式不同,可能显示 bbr、cubic 或不显示算法名称。因此,不能只用 grep bbr 作为唯一验证方式。更可靠的方式包括:
不要为了“看到 BBR”而强制关闭全部旧连接。大规模断连会把连接重建、TLS握手、应用冷缓存和上游连接池压力混入本次变更,反而降低判断准确性。
运行时修改完成后,先确认四个层面的状态:
sysctl -n net.ipv4.tcp_congestion_control
sysctl -n net.core.default_qdisc
sysctl -n net.ipv4.tcp_available_congestion_control
tc qdisc show dev "$IFACE"
然后确认服务本身没有出现异常:
ss -s
ss -tan state established | wc -l
ip -s link show dev "$IFACE"
如果接口上的丢包、错误或发送队列立即异常增长,应先停止扩容。不要因为应用暂时还能访问,就继续扩大流量比例。
海外业务需要把观测维度拆开。例如:
同一台服务器的总带宽可能上升,但某个关键地区的 p99 延迟也可能恶化。BBR的成功标准不是“总流量越大越好”,而是在目标方向上改善或保持吞吐,同时不引入可接受范围之外的排队、重传和业务错误。
可按照以下节奏推进:
| 阶段 | 建议动作 | 观察重点 |
|---|---|---|
| T+0至15分钟 | 只保留 canary 或单节点 | 模块、qdisc、连接建立、错误率、管理通道 |
| T+15至60分钟 | 维持小流量 | 地区维度的吞吐、p95/p99、重传和 CPU |
| 一个业务高峰 | 扩大到下一批节点 | 是否出现队列堆积、带宽公平性变化 |
| 高峰结束后 | 暂停扩容并比较基线 | 旧连接、新连接、不同方向的长期差异 |
| 完整观察周期 | 决定是否全量 | 是否跨越至少一个完整高峰和低峰 |
如果业务流量很小,15分钟内没有足够的新建连接,不能据此判定成功。此时应延长观察时间,或者通过受控的固定测试流量验证,但不要在生产出口上运行未经审批的大流量压测。
以下现象不一定表示切换失败:
如果 BBR连接的 RTT和重传表现正常,但业务吞吐没有提升,不应直接继续放大 tcp_wmem。应先确认应用写入速度、Socket发送缓冲区、接收端窗口、远端限速和链路容量。
出现以下任一情况,就应暂停下一批节点,并根据影响程度执行回滚:
tcp_available_congestion_control中不存在 bbr。不要等到所有指标都异常才回滚。对于连接大量失败、业务错误持续上升或管理通道不稳定的情况,应优先恢复可预测的 CUBIC状态。
先停止负载均衡向更多节点分配流量,记录当前指标和命令输出。不要先删除配置再收集现场,否则可能丢失定位信息。
date
hostname
sysctl -n net.ipv4.tcp_congestion_control
sysctl -n net.core.default_qdisc
tc qdisc show dev "$IFACE"
ss -s
ip -s link show dev "$IFACE"
使用变更前记录的实际算法。如果原值是 CUBIC,可以执行:
sudo sysctl -w net.ipv4.tcp_congestion_control=cubic
如果变更前不是 CUBIC,应使用备份中的原始值,而不是直接假设为 cubic。
恢复后验证:
sysctl -n net.ipv4.tcp_congestion_control
这一步只影响之后建立的连接。已经建立的 BBR连接通常不会因为修改默认值而自动切回 CUBIC。
只有本次确实执行过 tc qdisc replace,并且原始 qdisc已明确记录时,才执行恢复。
例如,变更前明确记录为 fq_codel,且没有额外参数,可以使用:
sudo tc qdisc replace dev "$IFACE" root fq_codel
如果原始值是 pfifo_fast,则使用:
sudo tc qdisc replace dev "$IFACE" root pfifo_fast
如果原始是 noqueue,则使用:
sudo tc qdisc replace dev "$IFACE" root noqueue
以上命令只能选择与变更前实际输出相符的一条。对于带有 class、filter、handle 或多个子队列的配置,不要用上述简单命令覆盖恢复,应按照备份的完整网络配置或编排工具恢复。
如果本次只修改了 net.core.default_qdisc,没有修改当前接口 root qdisc,则不需要为了回滚而额外执行 tc qdisc replace。错误地替换 qdisc可能比原变更造成更大影响。
可以先恢复运行时的默认队列值,再删除本次新增文件:
sudo sysctl -w net.core.default_qdisc="<变更前记录的值>"
sudo rm -f /etc/sysctl.d/99-bbr-change.conf
上面的 <变更前记录的值>不能直接作为命令输入,应替换为备份中的实际值,例如 fq_codel。如果需要让配置立即重新计算,可以再次读取原有配置文件,但不要无审查地执行整个系统的 sysctl --system。
如果本次新增了模块自动加载文件,也应删除:
sudo rm -f /etc/modules-load.d/tcp-bbr.conf
不建议为了回滚而执行 rmmod tcp_bbr。已有连接可能仍在使用该算法,且 BBR可能是内核内置功能,模块卸载并不成立。恢复新建连接的默认算法即可。
回滚默认值后,旧的 BBR连接仍可能继续存在。应优先采用应用层优雅方式回收:
不要直接对全部 TCP连接执行强制终止,也不要使用 kill -9 代替连接排空。强制断连会造成重连风暴,并可能让刚刚回滚的节点再次出现瞬时拥塞。
回滚完成后,至少持续观察一个完整的短窗口:
sysctl -n net.ipv4.tcp_congestion_control
sysctl -n net.core.default_qdisc
tc qdisc show dev "$IFACE"

ss -s
ip -s link show dev "$IFACE"
同时对比:
如果回滚后新连接恢复,但旧连接仍有异常,应继续通过连接池轮换和优雅排空处理,而不是重复修改内核参数。
只有在以下条件同时满足时,才应关闭本次变更:
如果任一关键指标在观察窗口内持续超过回滚阈值,应保持 CUBIC并结束本次尝试,而不是通过继续放大 TCP缓存、修改 MTU或叠加其他参数来掩盖结果。对于海外长 RTT链路,推荐把“分批切换、至少一个高峰观察、明确回滚阈值”作为固定流程;只有在新建连接表现稳定、旧连接完成自然轮换且业务指标持续满足标准后,才将 BBR保留为生产默认值。