香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


把香港机房选得离访问者更近,通常有助于降低传播时延,但它只能提供一个物理上的参考下限,不能直接等同于实际访问延迟。相隔同样的地理距离,经过不同运营商、不同跨境出口和不同上游线路后,最终的 RTT、抖动和丢包表现可能明显不同。
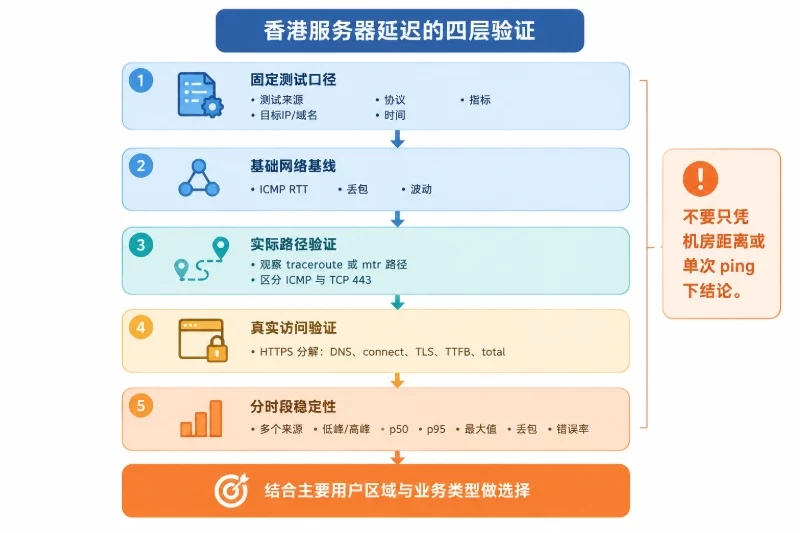
因此,判断香港服务器延迟,不能只问“机房距离用户有多远”,还要确认访问者从哪里出发、实际走哪条网络路径、测试的是哪一种协议,以及服务器收到请求后需要多久才能返回结果。更稳妥的做法,是把延迟拆成网络基础层、路由路径层、传输层和业务响应层逐层验证。
“距离越近,延迟越低”并不是完全错误。网络信号需要在光纤、传输设备和交换节点之间传播,物理距离越长,理论传播时间通常越高。
光纤中的信号传播速度约为每秒 20 万公里。按照理想直连线路估算,往返传播时延可以写成:
往返传播时延下限 ≈ 2 × 路径长度 ÷ 200,000 公里/秒 × 1000 毫秒
例如,假设两地之间存在一条长度为 1000 公里的直连光纤:
所以,在访问来源、运营商和线路质量都接近的情况下,较近的香港机房往往更容易获得较低的基础延迟。距离还会影响长距离访问的理论下限,网络设备再快,也无法完全消除物理传播时间。
问题在于,地图上的距离通常不是数据包实际走过的距离。访问者到香港服务器之间可能经过多个自治系统、不同城市的汇聚节点、跨境网络出口和海缆系统。实际路径可能绕行,也可能因为运营商之间的互联关系而选择一条并非最短的路线。
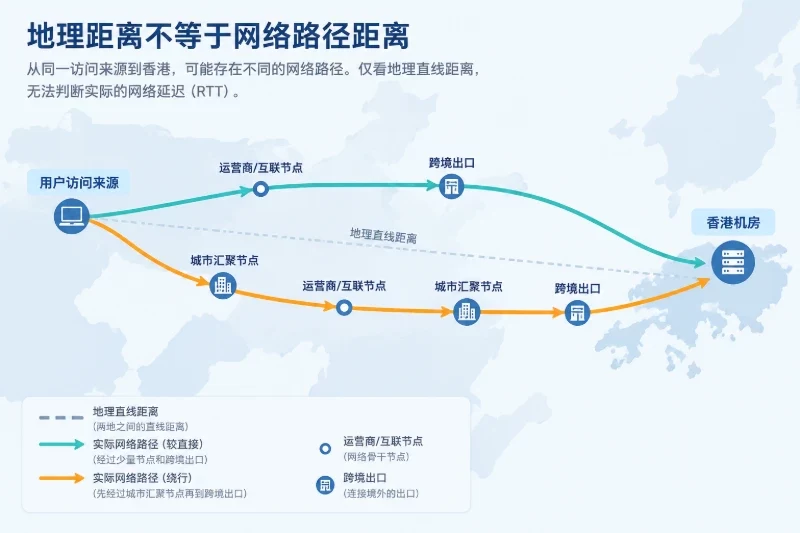
因此,“距离近”更适合作为初步筛选条件,而不是最终性能结论。
机房到用户之间至少存在三种不同的“距离”:
| 距离类型 | 含义 | 对延迟判断的作用 |
|---|---|---|
| 地理直线距离 | 地图上的两点距离 | 可用于估算传播下限 |
| 光纤和传输路径距离 | 数据包实际经过的线路长度 | 更接近真实网络延迟 |
| 路由跳数和网络处理距离 | 中间设备、运营商和互联节点带来的处理过程 | 影响额外时延、抖动和丢包 |
例如,某个用户到香港机房的直线距离并不远,但如果本地运营商先将流量送往其他城市,再从特定跨境出口进入香港,实际线路就可能比地图距离长很多。
相反,另一个地理位置稍远的机房,如果与用户所在运营商存在较好的直连或对等互联,实际 RTT 可能反而更低。
香港不同数据中心的网络出口、上游运营商、BGP 路由和跨境互联条件并不完全相同。即使两台服务器都位于香港,以下条件仍可能不同:
因此,单凭“香港”这个地域标签,不能推导出所有用户都会获得相同延迟。
IP 地址的地理归属也不能直接证明服务器的物理位置。IP 库的城市定位可能是注册地、运营商登记地或网络节点位置,通常只能作为辅助信息。更可靠的判断,应结合实际测试路径、服务商提供的机房信息以及目标 IP 的网络归属进行核对。
ping 测到的是 ICMP Echo 请求和响应的往返时间,它适合观察基础网络连通性,但不包含完整的业务处理过程。
一次 HTTPS 请求可能包含以下阶段:
因此,可能出现以下结果:
ping 只有 25 毫秒,但接口首字节等待 180 毫秒;ping 为 35 毫秒,但静态页面能够在 60 毫秒左右返回;ping 显示的数值高于实际 TCP 访问体验。单次测试中的 20 毫秒,并不能说明全天都能维持 20 毫秒。延迟还需要观察:
如果某条线路的中位数是 25 毫秒,但 p95 达到 100 毫秒,交互式业务可能仍会感到卡顿。另一条线路的中位数是 30 毫秒,p95 只有 38 毫秒,实际稳定性可能更适合接口、远程管理或在线交互。
可以把一次业务访问的总耗时简化为:
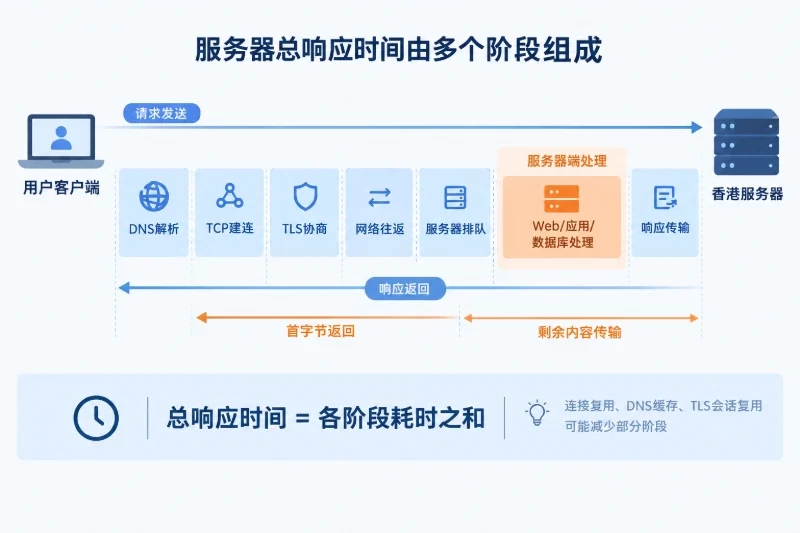
总响应时间 = DNS 时间 + 建连时间 + 加密协商时间 + 网络往返时间 + 排队时间 + 服务处理时间 + 响应传输时间
并不是每次请求都会完整包含这些项目。连接复用、DNS 缓存、TLS 会话复用和 HTTP 长连接都可能减少其中一部分时间。
传播时延主要由线路长度和信号传播速度决定。它是距离影响延迟最直接的部分。
但实际网络一般不会沿两地直线铺设。线路需要经过城市汇聚、运营商骨干节点、跨境设施和海缆登陆站,因此真实路径长度往往高于地图上的直线距离。
路由器需要接收、处理和转发数据包。当链路空闲时,排队时间可能很短;当出口、互联链路或服务器端口出现拥塞时,数据包会在队列中等待,延迟和抖动随之增加。
带宽和延迟也不是同一个指标。举例来说,使用十进制单位时:
这 80 毫秒只是数据发送过程中的序列化时间,不代表建立连接所需的基础 RTT。小请求可能主要受 RTT 和处理时间影响,大响应则还会受到带宽、拥塞窗口和丢包重传影响。
访问香港服务器时,网络通常会依据 BGP 路由、运营商策略、出口容量和互联关系选择路径。影响结果的因素包括:
这也是为什么“距离更远的服务器反而更快”并非不可能。它不一定违反物理规律,而是说明距离并不是总耗时中的唯一变量。
如果服务器上的 Web 服务、应用程序、数据库或磁盘处理较慢,用户会在网络包已经到达服务器后继续等待。
常见表现包括:
因此,测试网页或 API 时,至少要区分“连接建立耗时”和“服务器开始返回数据的耗时”。
在开始比较之前,应先固定测试条件,否则不同结果没有可比性。
| 项目 | 需要固定或记录的内容 |
|---|---|
| 测试来源 | 用户实际所在地区、运营商、IPv4/IPv6 |
| 测试目标 | 服务器 IP、域名、端口、是否经过 CDN 或负载均衡 |
| 测试协议 | ICMP、TCP 443、HTTPS 或具体业务协议 |
| 测试时间 | 工作日、高峰时段、低峰时段 |
| 测试次数 | 每个条件下重复采样,而不是只测一次 |
| 关注指标 | 中位数、p95、最大值、丢包、抖动、首字节时间 |
| 内容类型 | 静态文件、简单接口、真实业务接口 |
如果要比较两台香港服务器,应尽量使用同一个测试来源、同一个域名访问方式、相同的端口和相近的测试时段。否则,差异可能来自测试条件,而不是服务器本身。
ICMP 测试主要回答两个问题:
Linux 示例:
ping -c 20 -i 0.2 198.51.100.10
Windows 示例:
ping -n 20 198.51.100.10
198.51.100.10 是文档示例地址,实际测试时应替换为待验证的服务器 IP。测试频率不宜过高,普通连通性验证不需要使用洪泛方式。
此时建议记录:
如果目标禁止 ICMP,ping 失败并不能直接证明服务器不可访问。此时应转向 TCP 端口或 HTTPS 层测试。
可以使用 traceroute 或 mtr 查看数据包经过的中间节点。
Linux 示例:
traceroute -n 198.51.100.10
如果系统已安装 mtr,可以进行多次采样:
mtr -r -w -c 30 198.51.100.10
其中,-c 30 表示发送约 30 轮探测,-r 输出报告,-w 使用较宽的显示格式。不同发行版和软件版本的参数可能略有差异,执行前可用 mtr --help 或 traceroute --help 核对。
如果业务实际使用 HTTPS,还可以在支持 TCP 探测的环境中观察 443 端口路径:
traceroute -T -p 443 -n 198.51.100.10
路由结果应这样解读:
| 现象 | 更合理的解释 | 不应直接得出的结论 |
|---|---|---|
| 某一中间跳延迟突然升高,后续节点恢复正常 | 该节点可能限制探测包响应,或仅对 ICMP 降优先级 | 不能直接判断该节点造成了业务延迟 |
| 从某一跳开始,后续节点都整体升高 | 可能存在路径拥塞、跨网段变化或实际排队增加 | 仍需结合多次测试确认 |
中间节点出现 *,但目标正常返回 | 该节点可能不回应探测包 | 不能直接判定中间链路丢包 |
| 目标节点持续丢包 | 可能存在真实丢包,也可能是目标侧限速 | 需要结合 TCP 或业务层确认 |
| ICMP 路径和 TCP 443 路径不同 | 不同协议可能使用不同的处理策略或路由 | 不能用 ICMP 结果完全替代业务测试 |
还需要注意,traceroute 通常只反映一个方向的探测结果,而 ping 是往返时延。返回路径可能与去程不同,因此不能仅凭跳数判断线路长短,也不能把某个中间节点显示的 RTT 简单相加。
如果服务器对外提供网站或 API,仅测试 ICMP 还不够。可以使用 curl 分解 HTTPS 请求各阶段的耗时。
示例命令如下:
curl -sS -o /dev/null \
  --connect-timeout 5 \
  --max-time 15 \
  --resolve example.com:443:198.51.100.10 \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s start=%{time_starttransfer}s total=%{time_total}s code=%{http_code}\n' \
  https://example.com/
这里需要将:
example.com 替换为实际域名;198.51.100.10 替换为实际目标 IP;--resolve 让域名仍用于 HTTPS 主机名和证书校验,同时将连接指向指定 IP,适合在多个服务器 IP 之间进行对比。若目标使用 CDN、负载均衡或多层接入,测试到的可能是边缘节点或负载均衡入口,而不是某一台源站服务器,应先确认测试对象。
输出中的常见字段可以这样理解:
| 字段 | 含义 |
|---|---|
time_namelookup | DNS 解析完成时间 |
time_connect | TCP 连接完成时间 |
time_appconnect | TLS 协商完成时间 |
time_starttransfer | 收到首字节的时间,通常称为 TTFB |
time_total | 整个响应完成时间 |
http_code | HTTP 状态码 |
如果 connect 明显偏高,问题更可能出现在网络路径、端口接入或握手阶段;如果 connect 正常而 starttransfer 较高,通常要继续检查 Web 服务、应用程序、数据库或代理层;如果 starttransfer 正常但 total 很高,则要关注响应体大小、带宽和传输过程中的重传。
静态文件和动态接口应分开测试。静态文件可以帮助判断网络和基础服务,动态接口则更接近实际业务,但也会把应用处理、数据库查询等因素纳入结果。
一次测试只能说明某个时间点的状态。更有参考价值的方式,是在不同时间段重复采样。
可以按以下思路组织:
一个用于说明判断逻辑的示例:
| 指标 | 香港服务器 A | 香港服务器 B |
|---|---|---|
| ICMP 中位数 | 25 ms | 31 ms |
| ICMP p95 | 72 ms | 38 ms |
| 丢包率 | 0.3% | 0% |
| HTTPS 首字节中位数 | 68 ms | 74 ms |
| HTTPS 首字节 p95 | 210 ms | 102 ms |
这个示例中,A 的中位数更低,但高分位延迟和丢包表现更差。如果业务更重视稳定交互,B 可能比 A 更合适;如果业务主要关注低负载下的平均响应,A 的优势仍可能有意义。最终选择取决于业务对尾部延迟和稳定性的容忍度。
本地访问的地理距离通常不是主要矛盾,重点应放在:
如果本地用户的 ping 已经较高,而同一服务器从其他地区测试正常,应先检查用户侧接入和运营商路径,而不是直接认为机房位置不合适。
内地访问香港服务器时,跨境路径、运营商互联和出口拥塞通常比单纯的地图距离更重要。不同省份、不同运营商甚至同一运营商的不同接入区域,可能采用不同的跨境出口。
验证时建议至少区分:
如果只有某一家运营商在高峰期延迟升高,不能直接把结论扩大到所有内地用户。
这些地区与香港之间的海缆、运营商互联和路由策略可能不同。地理上较近的地区不一定拥有相同的网络路径,尤其是在多家运营商分别接入时。
测试时应使用对应地区的探测来源,不能用香港本地或内地某一处测试点替代所有地区。对于面向多个海外区域的业务,还要观察最差主要区域,而不只是选择延迟最低的一个来源。
距离对长距离访问的影响会更加明显,传播时延形成的下限更难被压缩。但即使在远距离场景,海缆路径、跨洲上游、互联质量和网络拥塞仍然会造成明显差异。
此时可以先用距离估算理论下限,再用 TCP 和 HTTPS 实际测试验证。如果目标用户分布很广,单一香港服务器可能只能在部分区域取得较好的表现,不能据此推断所有海外用户都会拥有相同的延迟。
不一定。ping 只反映 ICMP 往返情况,无法直接说明 TCP 建连、TLS 协商、应用处理和响应传输都更快。
判断网站或 API 时,应至少补充 TCP 443 和 HTTPS 首字节测试。
不一定。中间路由器可能对探测包降优先级,但仍然正常转发业务流量。如果后续节点恢复到原有水平,通常不能仅凭这一跳下结论。
更有意义的是观察从某一跳开始,后续所有节点是否持续升高,以及目标端是否同时出现丢包和业务超时。
不一定。平均值可能掩盖少量但严重的高延迟样本。对登录、接口调用、远程操作等交互场景,p95、p99、抖动和丢包往往比平均值更值得关注。
不一定。IP 地理定位只提供位置参考,不能替代从实际用户运营商出发的路由测试。服务器位于香港,也不代表所有内地运营商都会通过同样的路径访问。
不一定。不同 IP、不同上游、不同端口和不同接入网络可能对应不同路由。应比较实际要使用的 IP 和域名,而不是用一个地址的结果替代所有服务器。
如果业务是后台管理、短请求 API、在线交互或对响应时间敏感的页面,应重点看:
如果业务主要是大文件传输、备份或批量同步,低 RTT 仍有价值,但还要同时看带宽、拥塞窗口、并发连接数和持续传输能力。一个 RTT 较低但出口带宽不足的服务器,未必适合大流量传输。
如果业务面向多个地区,则不应只围绕“香港离哪里近”做单点判断,而应按主要用户区域分别采样。对于访问来源分散的场景,稳定性和区域覆盖可能比某一个测试点的最低延迟更重要。
机房距离在以下条件下仍然有较强参考价值:
在这些条件成立时,距离更近通常更容易获得较低的传播时延。距离越远,理论下限越高,这一物理关系不会因为路由优化而消失。
但如果线路、运营商、互联、拥塞和服务端处理能力不同,距离就只能作为初筛条件。最终判断香港服务器延迟,应至少完成“基础 RTT、实际路由、TCP/HTTPS 响应、分时段稳定性”四层验证,再根据主要用户区域和业务类型做取舍。地理位置可以解释一部分结果,却不能替代对真实网络路径和真实业务请求的验证。