香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


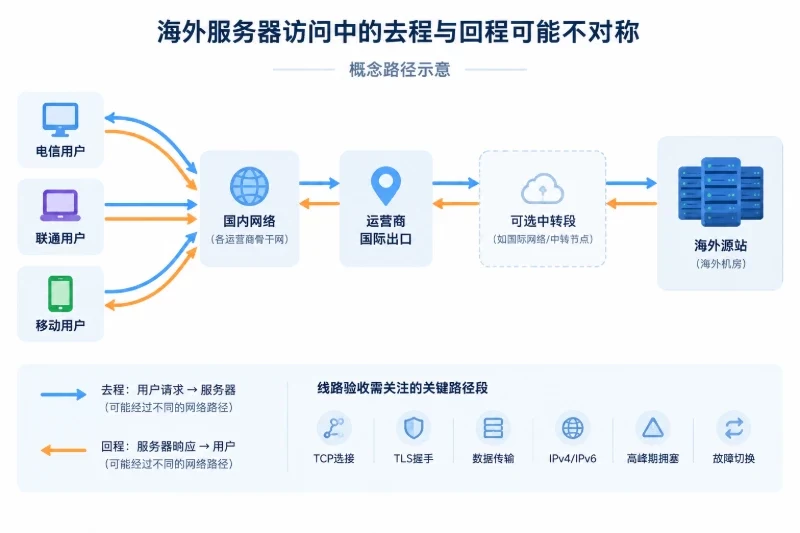
当海外用户打开页面正常、国内用户却长时间等待时,不要先把结论归因于“服务器配置不够”。同一个域名可能在不同地区解析到不同地址,访问链路也可能经过不同运营商、交换节点或安全入口。只有把 DNS、TCP 建连、TLS 握手、首字节时间和服务器内部处理时间拆开,才能判断慢在网络,还是慢在服务器本身。
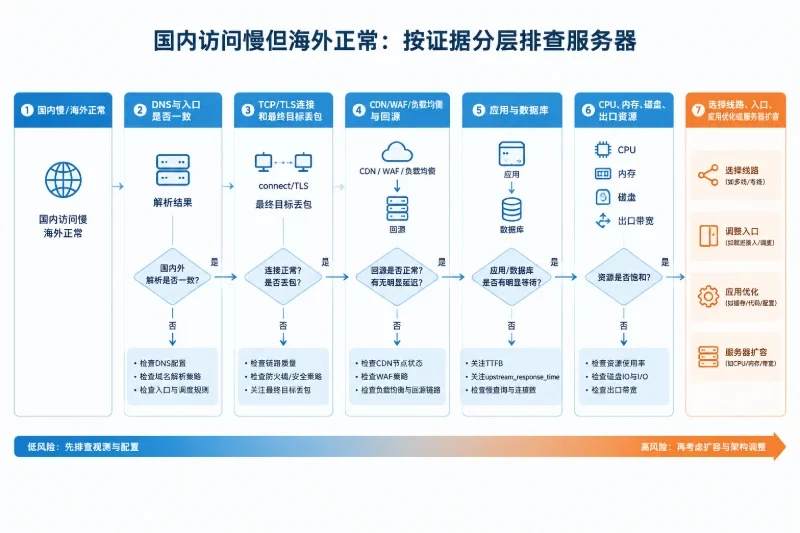
服务器调整应按低风险到高风险进行:先确认国内外是否命中了同一个入口,再检查链路丢包和延迟;如果连接已经建立,再看 Web 入口、应用、数据库和主机资源。链路丢包时,单纯增加 CPU、内存或带宽通常不能解决问题;如果国内外都在等待应用或数据库,则应从程序、连接池或实例容量入手。
排查前先确定一个不会改变业务数据的测试 URL,例如静态文件、公开详情页或只读健康检查接口。不要直接反复请求下单、支付、写入订单等有副作用的地址。
至少记录以下信息:
浏览器开发者工具中的“等待服务器响应”不能直接等同于服务器执行时间。它可能包含 DNS、TCP、TLS、跨地域往返、CDN 排队、WAF 检查以及应用处理等多个阶段。
在 Linux 或 macOS 的终端中,可以用 curl 对安全的 GET 地址做分段计时:
curl -sS -o /dev/null \
  --max-time 20 \
  -w 'http_code=%{http_code}\nremote_ip=%{remote_ip}\nsize=%{size_download}\ndns=%{time_namelookup}s\nconnect=%{time_connect}s\ntls=%{time_appconnect}s\npretransfer=%{time_pretransfer}s\nttfb=%{time_starttransfer}s\ntotal=%{time_total}s\n' \
  'https://www.example.com/readonly-page'
这条命令只丢弃响应正文,不会修改服务端数据。time_namelookup 是 DNS 阶段耗时,time_connect 包含 TCP 建连,time_appconnect 通常反映 HTTPS 握手完成时间,time_starttransfer 是收到首字节的时间,time_total 是完整请求结束时间。
一个用于说明判断方法的示例结果如下,数字为示例,并非某个环境的实测数据:
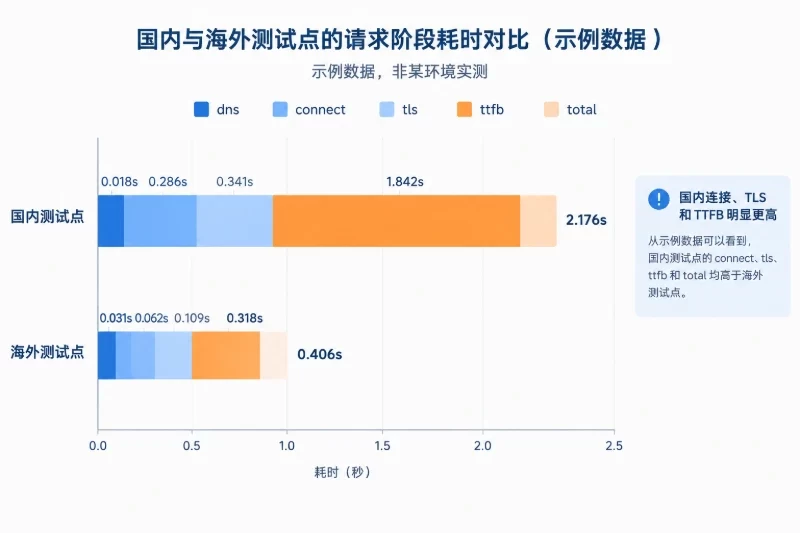
# 国内测试点
http_code=200
remote_ip=203.0.113.20
dns=0.018s
connect=0.286s
tls=0.341s
ttfb=1.842s
total=2.176s

# 海外测试点
http_code=200
remote_ip=203.0.113.20
dns=0.031s
connect=0.062s
tls=0.109s
ttfb=0.318s
total=0.406s
这个结果同时指向两类问题:国内到入口的建连和握手明显更慢,服务器在收到请求后也可能存在额外等待。不能因为 ttfb 较高,就忽略前面的链路延迟;也不能因为连接耗时较高,就认定应用没有问题。
单次请求容易受到 DNS 缓存、连接复用、缓存命中和瞬时拥塞影响。对只读 URL 做少量重复测试更有意义:
for i in $(seq 1 10); do
  date '+%F %T'
  curl -sS -o /dev/null \
    --max-time 20 \
    -w 'code=%{http_code} ip=%{remote_ip} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' \
    'https://www.example.com/readonly-page'
  sleep 1
done
如果国内测试的 connect 和 ttfb 都稳定偏高,通常需要优先检查入口和链路。如果 connect 接近海外测试,但 ttfb 只有国内请求偏高,应继续检查 CDN、WAF、按地区分流规则或应用是否根据来源 IP 进入了不同处理路径。
如果只有第一次请求慢,后续请求明显变快,可能是 DNS 缓存、TLS 会话、连接复用、应用冷启动或缓存预热,而不是持续性带宽不足。
国内访问慢有时不是纯粹的网络超时,而是安全策略重复挑战、频繁重定向或接口持续返回错误。应同时检查状态码和响应头:
curl -sS -D - -o /dev/null \
  --max-time 20 \
  'https://www.example.com/readonly-page'
重点观察:
200 但 time_starttransfer 高:继续分析后端处理或入口排队。301、302 链式跳转:核对 HTTP 到 HTTPS、主域名跳转和地区跳转规则。403:检查 WAF、访问控制、地区策略和误拦截。429:检查限流、连接数和客户端识别策略。502、504:重点看反向代理到应用的连接、超时和应用日志。200 但正文不完整:检查连接中断、上游响应和客户端重试。在国内和海外测试点分别执行以下命令:
dig www.example.com A +short
dig www.example.com AAAA +short
dig www.example.com CNAME +short
如果没有安装 dig,可先用:
getent ahosts www.example.com
重点不是只看解析是否成功,而是比较国内外的结果:
可用下面的方式分别比较 IPv4 和 IPv6:
curl -4 -sS -o /dev/null \
  --max-time 20 \
  -w 'IPv4 ip=%{remote_ip} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' \
  'https://www.example.com/readonly-page'

curl -6 -sS -o /dev/null \
  --max-time 20 \
  -w 'IPv6 ip=%{remote_ip} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' \
  'https://www.example.com/readonly-page'
如果 IPv6 明显慢或无法完成连接,而浏览器优先选择 IPv6,应先修复 IPv6 路由、监听和安全策略,或者在确认业务不依赖 IPv6 后调整 AAAA 发布策略。修改 DNS 前应保存当前记录、TTL 和回滚值;不要在没有备用地址的情况下直接删除正常记录。
ping 只能反映 ICMP 的情况,不能代替 HTTPS 测试。更接近实际访问的是针对 443 端口的 TCP 路由探测。Linux 上可以使用 mtr:
mtr --report --report-cycles 100 --tcp --port 443 www.example.com
如果目标环境的 mtr 不支持上述参数,可以使用:
traceroute -T -p 443 www.example.com
Windows 客户端可使用:
tracert www.example.com
Test-NetConnection www.example.com -Port 443
排查时关注三项:
中间某一跳显示 20% 丢包,并不一定代表业务真的丢了 20% 的包。很多路由设备会对探测报文限速,但会正常转发业务流量。只有当丢包延续到最终目标,且 curl、TCP 重传或业务响应同时异常时,才能把它作为主要证据。
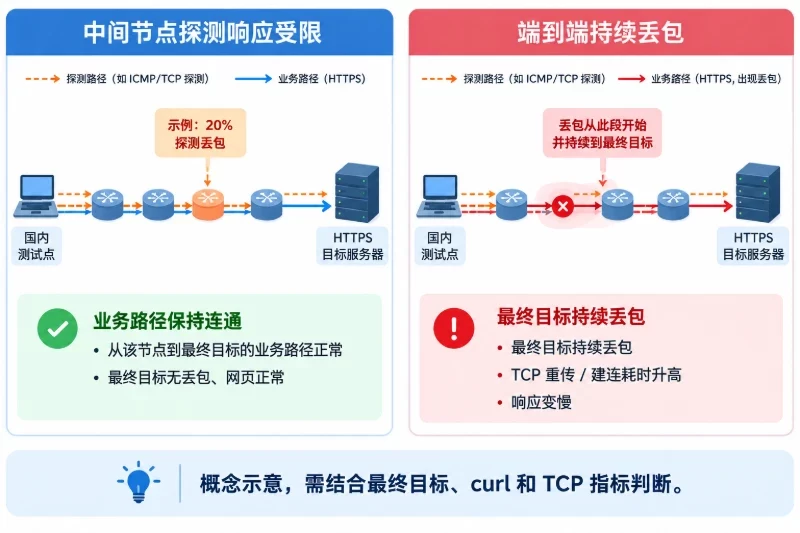
下面是一组用于判断的示例:
| 观察结果 | 更可能的含义 | 下一步 |
|---|---|---|
| 中间节点丢包,最终目标无丢包,网页正常 | 中间设备限制探测响应 | 不要仅凭该跳调整服务器 |
| 最终目标持续丢包,国内连接耗时升高 | 入口线路、运营商路径或服务端网络可能异常 | 更换入口、联系线路提供方并核对服务器网卡 |
| 丢包很低,但 TCP 建连延迟明显高 | 路由绕行、跨网互联延迟或队列等待 | 比较不同线路和入口,不要只增加带宽 |
| TCP 建连正常,TTFB 很高 | CDN 回源、WAF、应用或数据库处理慢 | 转向 Web 和应用层 |
| 连接和 TTFB 都正常,下载阶段很慢 | 响应体大、出口拥塞、限速或丢包重传 | 检查文件大小、压缩、静态资源和出口流量 |
如果条件允许,至少使用两个国内运营商网络和一个海外测试点交叉验证。只有一个家庭宽带或一台海外云主机的数据,不能代表所有地区。
丢包可能来自跨网互联、线路拥塞、错误的 MTU、出口队列、网卡错误、安全设备限速或服务端连接队列。提高带宽只对出口确实饱和的情况有帮助;如果问题是某个运营商到服务器的路径质量,带宽增加后路径仍然可能丢包。
在服务器上可以先做无侵入检查:
ip -s link
ss -s
sar -n DEV 1 5
如果没有 sar,可以使用:
cat /proc/net/dev
观察网卡是否存在持续增长的 dropped、errors,出口吞吐是否接近实例或端口上限,以及 TCP 连接是否大量处于异常状态。ip -s link 中的计数器是累计值,应记录两次读数并比较增长速度,不能只看一个绝对数字。
如果只有某个地区的路径异常,而服务器网卡错误、出口带宽和连接数都正常,应优先联系线路、云平台或 CDN 服务方核查路由质量。不要先调整内核参数、扩大连接队列或关闭安全策略,这些操作可能掩盖根因。
如果前端使用 CDN、WAF 或负载均衡,需要同时查看:
常见的分支是:国内用户到边缘节点的连接很快,但边缘到源站的回源时间很长。这时调整源站 CPU 未必有效,应检查边缘到源站的线路、源站白名单、回源 DNS 和回源连接复用。
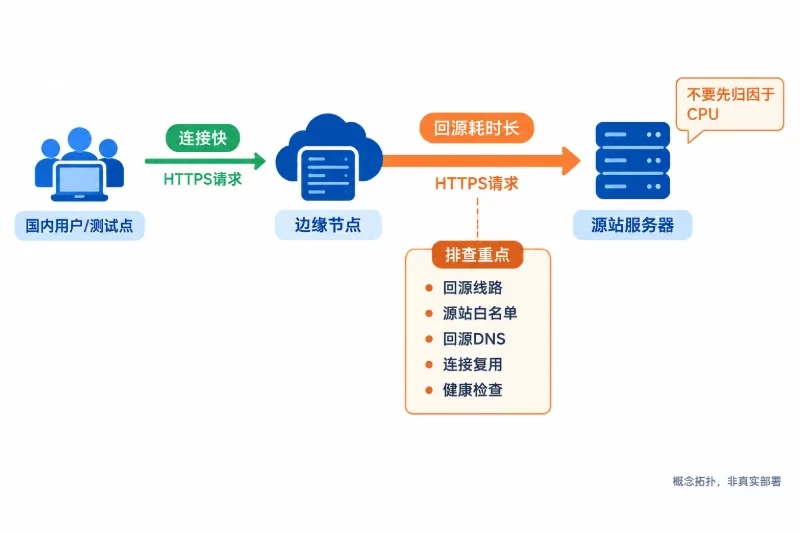
相反,如果国内用户连边缘节点本身就慢,且海外用户命中另一组正常节点,问题更接近 DNS 调度、节点质量或地区接入策略。
静态内容和动态内容应分开判断。图片、JavaScript、CSS 等静态文件适合在合规的 CDN 入口缓存;带登录态、购物车、订单和个性化数据的接口不能因为“加缓存”就直接缓存,需要明确缓存键、失效条件和隐私边界。
如果源站使用 Nginx,可先用只读方式查看当前配置:
sudo nginx -T 2>/dev/null | grep -E 'log_format|access_log|proxy_pass|fastcgi_pass|keepalive|worker_connections'
不同发行版的配置路径和服务名可能不同,先确认实际服务:
systemctl list-units --type=service | grep -E 'nginx|openresty'
systemctl status nginx --no-pager
nginx -T 可能输出证书路径、上游地址甚至敏感参数,不要把完整输出直接发布到工单或公开平台。
如果访问日志已经记录了 $request_time 和 $upstream_response_time,可以抽取慢请求:
sudo grep 'GET /readonly-page' /var/log/nginx/access.log | tail -n 20
日志路径需要以实际配置为准。典型的时间字段含义如下:
request_time:Nginx 从收到请求到发送完响应的总时间。upstream_connect_time:连接应用上游所需的时间。upstream_header_time:等待上游响应头的时间。upstream_response_time:上游返回响应所需的时间。一个示例日志可能类似下面的形式,数字仅用于展示判断路径:
10.0.0.8 - - [12/Mar/2025:10:20:31 +0800] "GET /readonly-page HTTP/2.0" 200 18432 rt=1.842 uct=0.003 uht=1.817 urt=1.821
这里 uct 很低而 uht、urt 很高,说明 Nginx 很快连上应用,但应用迟迟没有返回,应该继续排查应用和数据库。如果 uct 本身就很高,可能是应用连接池耗尽、上游地址异常或网络层问题。
若日志没有这些字段,可以在变更前备份实际配置文件,再增加临时日志字段。配置文件位置必须以 nginx -T 显示的结果为准,示例片段如下:
log_format timing '$remote_addr "$request" $status '
                  'rt=$request_time '
                  'uct=$upstream_connect_time '
                  'uht=$upstream_header_time '
                  'urt=$upstream_response_time';

access_log /var/log/nginx/access_timing.log timing;
应用前执行语法检查:
sudo nginx -t
只有显示 syntax is ok 和 test is successful 后,才在维护窗口执行平滑重载:
sudo systemctl reload nginx
如果重载后出现配置错误、日志异常或请求失败,应立即恢复备份文件,再执行 nginx -t 和 reload。不要直接重启生产服务来“试试看”,因为重启会中断现有连接,并可能放大问题。
可先查看监听端口、连接状态和进程:
ss -lntp
ss -ant '( sport = :443 )' | head -n 30
ps -eo pid,ppid,comm,%cpu,%mem,stat --sort=-%cpu | head -n 20
需要重点判断:
SYN-RECV 是否持续堆积,说明建连或 accept 阶段可能存在压力。ESTAB 是否远超平时,连接是否长期不释放。worker_connections、连接超时和缓冲区不是越大越好。提高并发上限会增加文件描述符、内存和上游压力;把 proxy_read_timeout 调大,只会让请求等待更久,并不会让应用执行得更快。调整前应有连接数、内存和应用并发的基线,并保留配置回滚版本。
仅凭浏览器显示“等待服务器响应”,无法知道请求是在排队、调用外部接口、等待数据库,还是进行大对象序列化。建议为请求增加唯一标识,例如 X-Request-ID,并让 Nginx、应用日志和下游调用日志使用同一个 ID。
一个请求的时间可以拆成:
总耗时 = 网络与握手耗时 + Web 入口排队 + 应用处理耗时 + 数据库耗时 + 外部服务调用耗时 + 响应传输耗时
这不是严格的所有场景公式,因为部分阶段可能并行执行,但足以帮助建立排查顺序。
应用日志中应关注:
如果只有国内用户慢,但应用日志中同一接口的服务端执行时间正常,且 Nginx request_time 明显高于应用耗时,问题更可能在入口、回源或响应链路。若应用日志也显示国内请求耗时增加,则需要查看地区判断、第三方接口和数据库调用。
应用可能根据来源 IP、请求头、语言、登录区域或租户信息选择不同的资源。例如:
可先只读查看应用服务状态和近期错误:
systemctl status your-app.service --no-pager
journalctl -u your-app.service --since '30 minutes ago' --no-pager
your-app.service 只是占位符,必须替换为实际服务名。若服务不是 systemd 管理,使用应用自身日志系统查询。不要在高峰期直接重启应用来清理线程池;重启可能暂时缓解现象,却丢失现场并造成连接中断。确需重启时,应先确认有多实例、流量摘除和回滚方案。
如果发现某个外部接口在国内路径持续慢,应先增加连接、读取和总超时的可观测日志,并设置合理的失败降级。不要把超时无限延长,也不要在没有幂等设计的情况下盲目增加重试,因为重试会把慢请求放大成流量峰值。
应用层修改应优先采用单实例、单接口或小比例流量验证。可选的低风险调整包括:
每次只改变一个主要变量,并记录调整前后的 p50、p95、p99、错误率和数据库连接数。不要在应用、Nginx、数据库和服务器规格上同时动手,否则即使速度改善,也无法知道真正的原因。
当 Nginx 连接上游很快,但上游响应时间高,数据库是常见等待点。应先查看只读指标:
MySQL 或 MariaDB 可以使用只读账号执行:
mysql -h DB_HOST -u readonly_user -p -e "SHOW FULL PROCESSLIST;"
mysql -h DB_HOST -u readonly_user -p -e "SHOW GLOBAL STATUS LIKE 'Threads_connected';"
mysql -h DB_HOST -u readonly_user -p -e "SHOW GLOBAL STATUS LIKE 'Threads_running';"
密码建议交互式输入,不要直接写在命令行中,避免进入 shell 历史记录。重点观察长时间处于 Locked、Waiting 或执行时间异常的语句,以及连接数是否接近上限。
PostgreSQL 可以查询活动会话:
SELECT pid,
       usename,
       state,
       wait_event_type,
       wait_event,
       now() - query_start AS elapsed,
       left(query, 160) AS query_text
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
这些查询本身不修改数据,但生产环境仍应使用权限受限的账号。不要未经确认直接执行 KILL、终止会话、删除数据或修改全局参数。
拿到真实的慢 SQL 后,先使用 EXPLAIN 分析访问路径:
EXPLAIN
SELECT id, status, created_at
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 20;
应关注是否全表扫描、扫描行数是否远大于返回行数、排序是否产生临时空间,以及索引是否符合查询条件。示例中的表名和字段只是说明格式,不能直接在生产库执行。
如果需要新增索引,应先:
不要为了验证一个猜测,在高峰期直接重建大表索引。索引增加后也可能降低写入性能;如果查询量不高,索引未必是最合适的修复方式。
如果应用、数据库和用户入口分布在不同地区,动态请求可能经历多次跨地域往返。例如应用服务器在海外、数据库在国内,或者应用在国内但依赖的数据库在海外。一次页面请求内若执行几十次串行 SQL,单次增加的往返时间会被放大。
这类问题的调整方向可能是:
读写分离、多地域数据库和跨地域复制都可能带来数据一致性、故障切换和成本变化,不能只看页面响应时间就直接上线。
Linux 主机上可以先执行以下只读命令:
uptime
vmstat 1 5
free -h
df -h
iostat -xz 1 5
如果 iostat 不存在,通常需要安装或启用 sysstat,不要为了临时排查直接在生产高峰期安装大量软件。
判断时不要只看 load average:
us、sy 持续高:CPU 计算或内核处理压力大。wa 高:进程在等待磁盘或块设备。si、so 持续有值:可能发生交换,内存压力较大。await 高且 %util 接近满载:磁盘响应或队列可能成为瓶颈。检查文件描述符和连接上限:
ulimit -n
sysctl net.core.somaxconn
sysctl net.ipv4.tcp_max_syn_backlog
这些值只是系统限制,不能说明业务一定已经用满。应结合 ss、进程打开文件数、连接数和应用指标判断。直接修改内核参数前,必须记录当前值、确认发行版和内核版本,并准备重载或重启后的恢复方案。很多参数需要重启或影响全机服务,不适合用作第一步试验。
下面几种情况,扩容服务器或增加实例才更有针对性:
如果只有国内访问慢,海外访问正常,且服务器内部 CPU、内存、磁盘、应用执行时间都正常,优先级通常应是入口线路、节点分布、DNS 调度、CDN 回源和运营商路径,而不是直接把实例规格扩大数倍。
排查结果应与调整动作对应,避免“看见慢就升配”。
| 主要证据 | 更适合的调整方向 | 不宜直接采取的动作 |
|---|---|---|
| 国内解析到异常 IP 或 IPv6 路径不稳定 | 修正 DNS、健康检查、地址池和 IPv6 配置 | 直接删除全部解析记录 |
| 国内到目标端口建连延迟高、最终丢包持续存在 | 更换接入线路、优化多线入口、引入合适的边缘节点或 CDN | 只增加 CPU 和内存 |
| 边缘连接正常,但回源时间长 | 检查回源线路、源站白名单、源站连接复用和健康检查 | 盲目延长回源超时 |
Nginx 连接上游快,但 upstream_response_time 高 | 排查应用线程池、外部依赖、数据库和缓存 | 只提高 Nginx worker 数量 |
| SQL 扫描量大或存在锁等待 | 优化查询、索引、事务边界和连接池 | 高峰期直接杀会话或重建大表 |
| CPU、内存、磁盘或出口长期饱和 | 升级实例、增加副本、拆分静态与动态流量 | 同时修改所有系统参数 |
| 国内外都出现应用处理变慢 | 从应用容量、数据库和主机资源整体扩容 | 只调整 DNS 试图掩盖源站过载 |
| 只有特定地区命中 403、429 或重复跳转 | 检查 WAF、限流、地区规则和认证链路 | 直接关闭全部安全策略 |
如果服务器位于海外,而主要国内用户到该源站存在稳定的跨网延迟或丢包,可以考虑在合规条件下增加国内接入节点,或使用能提供合适国内边缘接入的 CDN。若海外用户也很重要,单纯把服务器搬到国内可能改善国内访问,却改变海外访问路径;多地域接入、按地区调度或静态与动态分离通常更容易兼顾两类用户,但会增加同步、运维和故障切换复杂度。
DNS 调度和多地域架构上线前,应先确认:
每次调整前保存:
request_time 与上游耗时。不要只记录平均值。平均值可能掩盖少量极慢请求,至少同时看 p50、p95 和 p99。例如平均 TTFB 从 1.8 秒降到 1.2 秒,但 p99 仍然超过 10 秒,用户仍可能频繁遇到卡顿。
推荐按以下顺序验证:
curl 测试。DNS 变更、CDN 回源切换和多节点调度都可能受 TTL、缓存和连接复用影响,因此刚切换几分钟的结果不能代表最终效果。回滚时使用变更前保存的解析、节点权重和配置,不要临时手工拼写一套新值。
修复后仍需持续观察:
当国内访问恢复,而海外指标同步恶化时,说明流量可能只是被转移,不能视为完整修复。只有在国内链路质量、入口耗时、应用处理和资源负载都处于可接受范围,并且经过持续观察没有新增错误,才适合结束本轮调整。