

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


在线课堂出现声音断续、画面冻结、延迟逐渐升高或频繁重连时,先确认影响范围:是单个师生、某个地区或网络,还是所有课堂同时发生;是入会慢,还是入会后音视频持续卡顿。不同表现对应的故障层级不同,不能仅凭一次 ping 延迟偏高就认定香港服务器线路有问题。
建议按“本地网络 → DNS与连接目标 → 跨境路由和丢包 → 香港服务器负载 → 应用及媒体服务”依次排查。每一步都记录发生时间、受影响用户、课堂房间和测试结果;发现异常后先做小范围验证,再调整配置。排查过程中尽量保持测试条件一致,例如使用同一终端、同一网络和同一课堂,避免把网络变化误判为修复效果。
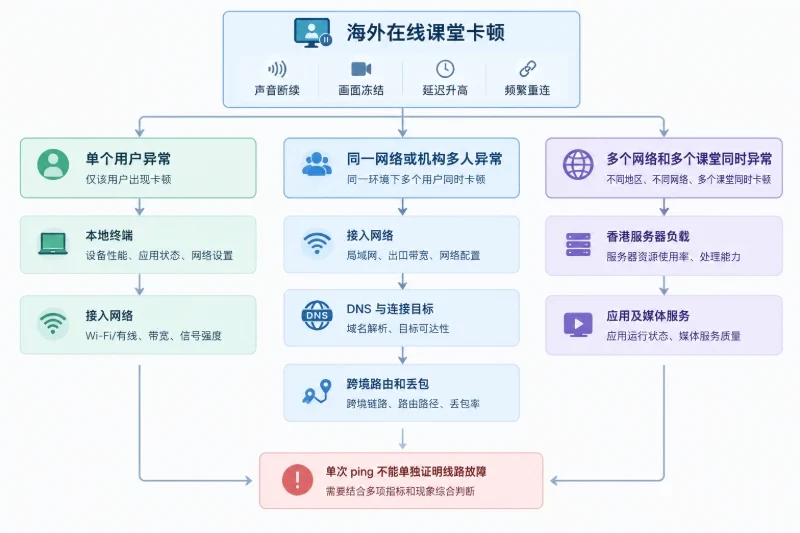
将用户反馈整理为可比较的现象,重点区分以下几类:
| 现象 | 优先检查方向 | 判断依据 |
|---|---|---|
| 页面或课堂入口打开慢,音视频尚未建立 | 本地网络、DNS、HTTPS请求及应用接口 | 是否卡在解析域名、登录、获取课堂配置等阶段 |
| 能进入课堂,但声音断续、画面冻结 | 本地网络质量、媒体链路丢包、服务器资源及媒体服务 | 是否出现抖动、丢包、重传或服务器处理队列增长 |
| 单个用户卡顿,其他师生正常 | 该用户终端、本地网络或接入网络 | 同房间其他参与者能否正常收发音视频 |
| 同一机构或同一网络下多人同时卡顿 | 局部出口网络、DNS解析、共同路由段 | 不同终端是否在相近时间出现相同症状 |
| 多个课堂、不同网络的用户同时卡顿 | 香港服务器、媒体服务、共享链路或应用依赖 | 服务端负载、接口错误和媒体节点指标是否同步异常 |
| 只有一位师生听不到或看不到某个人 | 单端上行、权限、设备采集或媒体会话 | 其他参与者能否收到该用户的音视频 |
在线互动的体验不只由往返时延决定。实时音视频还会受抖动、丢包、突发拥塞、编码处理时间和终端性能影响。作为排查参考,稳定课堂中几十毫秒量级的网络抖动通常比持续增长的抖动更容易处理;如果出现连续丢包、明显的音频断续或数百毫秒级延迟,往往需要进一步检查链路和服务端。具体可接受范围取决于课堂交互方式、编码策略和业务目标,不能用单一数值作为所有场景的合格线。
先从出现卡顿的参与者侧开始。教师端上行异常会影响多个学生;学生端下行异常通常只影响该学生。若只有一端报告问题,不宜先重启服务器或修改服务配置。
请受影响用户记录卡顿发生时使用的网络类型、连接方式和终端状态。优先进行低风险对照:
若切换网络后明显改善,或同一网络下多个终端同时出现卡顿,问题更可能位于本地接入或共同出口,而不是香港服务器单点故障。若只有某台设备异常,继续检查设备资源、浏览器或客户端状态,以及音视频采集权限。
Windows 可在命令提示符中查看到服务器的基础连通情况:
ping -n 20 classroom.example.com
Linux 或 macOS 可使用:
ping -c 20 classroom.example.com
将 classroom.example.com 替换为课堂实际使用的域名。观察往返时间是否持续波动、是否出现超时,以及不同测试时间是否差异明显。需要注意,ping 使用 ICMP 探测;目标服务器或中间网络可能限制、降低 ICMP 响应优先级。ping 超时不一定代表课堂业务不可达,ping 正常也不能证明实时媒体链路没有丢包。
如果客户端能提供音视频统计信息,应同时记录发送端和接收端的指标,例如往返时间、抖动、丢包、码率和分辨率变化。发送端持续丢包通常需要检查上行;接收端丢包或解码帧率下降,可能与下行链路或终端处理能力有关。不要只看画面分辨率:自适应码率降低分辨率可能是链路拥塞的结果,也可能是服务端主动调整。
DNS 解析通常影响首次访问、登录或加入课堂的速度。已建立的音视频会话出现持续卡顿时,DNS 往往不是直接原因,但错误或不一致的解析结果可能使不同用户连接到不同服务地址,导致问题集中在特定用户或特定入口。
Linux/macOS 可用 dig 查看解析结果:
dig classroom.example.com
Windows 可用:
nslookup classroom.example.com
重点核对:
解析结果不同不必然代表故障。域名可能依据部署策略返回多个地址;需要结合应用日志、连接目标和服务状态判断。若只有解析阶段超时或返回错误地址,先核对域名配置、记录变更和本地 DNS 缓存,再通过重新解析或更换受控测试环境进行验证。不要在未确认影响范围前直接修改全体用户的 DNS 设置。
DNS 修复后的验证应包含新用户重新加入课堂,并确认其网页入口、信令接口和媒体连接均正常。已经建立的会话可能仍使用旧连接,不宜只观察存量课堂判断解析调整是否生效。
确认本地网络和解析没有明显异常后,再检查到香港服务器的路径。路由变化、跨境链路拥塞或特定网络出口质量波动,都可能造成延迟增加或丢包。应在卡顿发生时测试,并与恢复时段或正常用户的结果对照。
Linux 可使用:
traceroute classroom.example.com
若系统没有 traceroute 命令,可先核实系统已有的诊断工具,不要为了测试直接安装来源不明的软件。Windows 可使用:
tracert classroom.example.com
输出通常逐跳显示从测试端到目标的路径及探测时间。关注路径是否明显变化、延迟从哪一段开始增加,以及是否出现连续多跳超时。某一跳显示 * 只说明该跳没有按时响应探测包,可能是路由器不回应或限制探测流量,并不能单独证明该节点正在丢弃课堂数据。若后续跳数和目标仍正常响应,单个中间跳的星号通常不构成充分故障证据。
在 Linux 上,如果已安装 mtr,可用报告模式做一段时间的路径观察:
mtr -rw -c 50 classroom.example.com
如果工具不可用,使用 ping 与 traceroute 分时段重复采样,并结合课堂客户端的媒体统计。不同探测工具的协议和优先级可能与实际媒体流量不同,路径结果只能作为辅助证据。尤其是某中间节点显示丢包、但后续节点和目标没有相应丢包时,可能只是该节点限制了探测响应。
判断路由问题时可按以下逻辑推进:
如果怀疑 UDP 媒体流受影响,应以客户端或媒体服务的会话统计、丢包和抖动为主要依据。对网页 HTTPS 端口的探测成功,只能说明对应连接可建立,不能证明媒体流所需的所有连接路径均正常。也不要通过大范围开放端口或关闭防火墙来“试试看”;先依据应用实际端口配置、服务日志和网络策略确认受影响的流量,再做限定范围的变更,并保留原配置以便恢复。
如果多个地区或不同接入网络的师生在相近时间同时卡顿,而本地网络问题无法解释,应查看香港服务器在故障时段的资源与网络指标。要把课堂卡顿时间与监控数据对齐,重点检查 CPU、内存、磁盘 I/O、网络吞吐、连接数和系统日志,而不是仅查看当前状态。
Linux 服务器可先运行以下只读命令:
uptime
free -h
vmstat 1 5
ip -s link
ss -s
这些命令用于查看系统负载、内存、运行队列、网卡收发统计和连接概况。结果需结合服务器规格、业务基线和进程情况判断:
uptime 中负载持续升高,且运行队列长期大于可用 CPU 处理能力,提示计算资源可能成为瓶颈;短时尖峰不一定代表故障。free -h 显示可用内存持续减少,同时系统出现频繁换页或进程被终止,需检查内存压力及进程占用。vmstat 中运行队列、等待 I/O 或交换活动异常持续,可能说明 CPU、磁盘或内存存在压力;应结合进程级数据确认。ip -s link 的网卡错误或丢弃计数持续增长,提示检查接口、虚拟网络或主机网络配置。计数器是累计值,需比较两个时间点的增量,而非只看总数。ss -s 可辅助观察连接规模变化,但连接数量本身不能说明媒体服务一定过载。如果服务器启用了 sar,可查看历史资源曲线;若没有该工具,优先使用已有监控平台或系统指标,不要为排障贸然更改系统配置。需要进一步定位进程时,可使用:
top
观察课堂信令服务、媒体服务及相关工作进程的 CPU 和内存变化。某个进程占用升高并不自动等同于根因,还要核对同一时段的会话数、房间数、码率、错误率和服务日志。
发现资源压力后,先确认影响的是单个进程、整个主机,还是某个共享依赖。重启服务会中断连接或影响正在进行的课堂,不应作为第一步。若确需重启或调整资源,应提前评估课堂影响、告知相关人员、保存当前配置和日志,并准备恢复方案;变更后要观察新建课堂与存量课堂是否都恢复。
网络路径和主机资源没有明显异常时,检查课堂应用自身的响应链路。一次课堂互动可能涉及登录、房间分配、信令建立、媒体协商、媒体转发和状态上报等环节。网页入口响应正常,不代表信令与媒体服务都正常;信令建立成功,也不代表媒体数据持续稳定。
可按用户操作顺序核对:
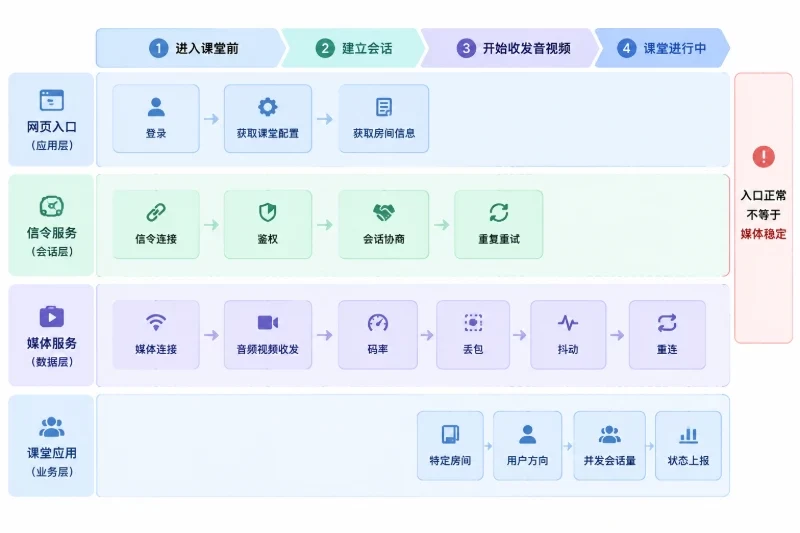
对照客户端、应用和服务器日志时,统一使用可关联的时间戳、房间标识和会话标识;涉及个人信息时应按内部安全要求脱敏。日志应回答“故障发生在哪个环节”,而不是只收集大量文本。比如,同一时段出现大量媒体协商失败,但服务器 CPU 和网卡统计正常,应继续核对服务配置、监听状态及会话分配;若入口接口响应正常,客户端却反复报告媒体收发中断,排查重点应转向媒体会话和实际数据流。
不要仅通过增加超时时间掩盖响应变慢,也不要直接清空日志、重置连接或大范围修改服务参数。这类操作可能让故障证据消失,或扩大课堂中断范围。对配置调整应保留变更前副本和参数值,先在可控范围验证;若异常加重,按记录恢复原值并检查连接是否重新建立。
当课堂正在发生卡顿,可按以下顺序操作:
修复完成不等于故障已经解决。建议在与故障相同或相近的课堂场景中复测,并确认以下几项:
测试时长应覆盖业务实际使用的课堂时间,并与故障发生时的并发量和互动方式尽量接近。若只有短暂恢复,应继续观察;若路径探测正常而媒体统计仍异常,回到应用及媒体链路继续定位,不要将单次 ping 成功当作最终验收。
同类问题复发时,时间线和对照数据往往比单条命令输出更有价值。每次事件至少保留故障开始与恢复时间、影响范围、DNS解析结果、路径探测结果、客户端媒体统计、服务器资源曲线、关键应用日志和已执行变更。记录中的测试应标明终端网络和目标域名,避免后续把不同路径的数据混在一起。
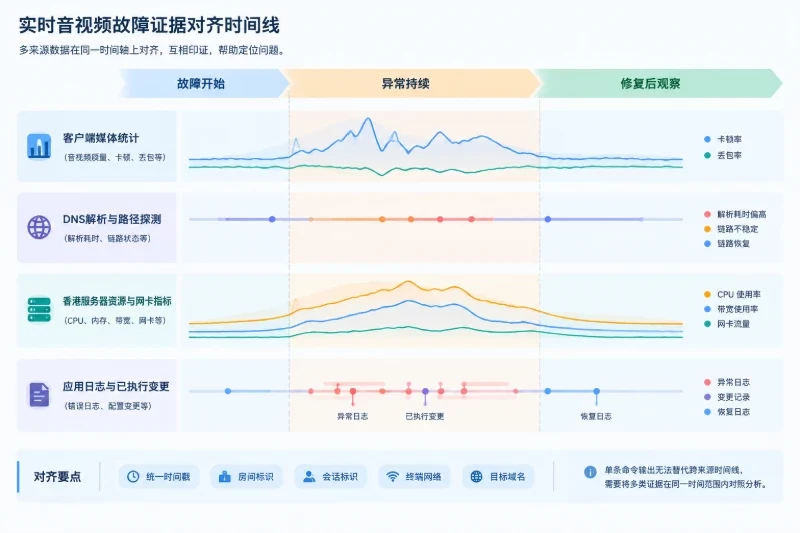
日常监控可关注目标端延迟变化、媒体丢包与抖动、课堂重连率、信令失败率、服务器 CPU 和内存压力、网卡丢弃增量及应用接口错误率。为指标设置符合业务基线的告警,并把“单用户异常”和“多用户同时异常”分开处理。这样发生卡顿时,才能快速判断问题位于师生本地、解析与路径、香港服务器资源,还是应用和媒体服务,而不是依靠单一现象反复猜测。


