香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


CPU型号相同,服务器内存也该配一样吗?通常不应该直接这样判断。CPU主要决定计算能力、核心数、线程数和一部分内存通道能力,但服务器实际需要多少内存,更多取决于运行的进程、并发量、数据集大小、缓存策略、虚拟机或容器数量,以及业务高峰时还要保留多少余量。
因此,选择8G、16G还是32G,不能只看CPU型号。更可靠的方法是观察业务高峰期的进程占用、系统可用内存、交换分区活动和内存压力,再结合增长和突发空间估算。相同CPU的轻量网站、数据库服务器和多容器节点,完全可能需要不同容量的内存。
“同一款CPU搭配同样大小的内存”在批量部署或集群节点中有时是合理的,但它属于运维统一策略,不是由CPU型号直接推导出来的结论。
同一型号CPU可能被放在不同用途的服务器上:
| 服务器用途 | 影响内存需求的主要因素 | 可能出现的差异 |
|---|---|---|
| 轻量网站或单一应用 | 进程数量、访问并发、运行时开销 | 8G可能够用,也可能因并发增长需要16G |
| 网站加应用服务 | Web进程、应用进程、连接池、日志和缓存 | 多个进程同时运行,余量要求更高 |
| 数据库服务器 | 缓冲池、连接数、排序和临时表 | 数据量和查询并发变化后,内存增长明显 |
| 容器节点 | 每个容器的限制、共享组件、镜像和日志 | 宿主机可用内存需要覆盖多个工作负载 |
| 编译、构建或批处理服务器 | 并行任务数、临时文件、构建进程 | 平时空闲,高峰时可能瞬间占用较多内存 |
CPU使用率和内存使用率也不是同步变化的。一个服务器可能CPU长期只有30%,但因为数据库缓存、Java堆、容器内存或多个常驻进程占用较多,已经频繁使用交换空间。反过来,CPU持续较高但内存仍有大量余量,增加内存也不一定能解决性能问题。
还要区分两个问题:
CPU型号可能影响内存通道或平台支持上限,但不能说明某项业务一定需要8G、16G或32G。
在Linux服务器上,free -h通常比单纯看used更有参考价值:
free -h
常见字段可以这样理解:
| 字段 | 含义 | 判断时的注意点 |
|---|---|---|
total | 系统可识别的总内存 | 可能与购买时标注的8G、16G、32G显示值略有差异 |
used | 已被使用的内存,具体统计方式与系统版本有关 | 不能单独据此判断内存不足 |
free | 当前完全空闲、未被使用的内存 | 数值较小并不一定代表异常 |
buff/cache | 缓冲区和文件缓存 | 一部分可以在需要时回收 |
available | 系统估算的、无需明显交换就能提供给新进程的内存 | 判断余量时重点关注 |
swap | 交换空间的使用情况 | 不能只看是否使用过,还要看是否持续换入换出 |
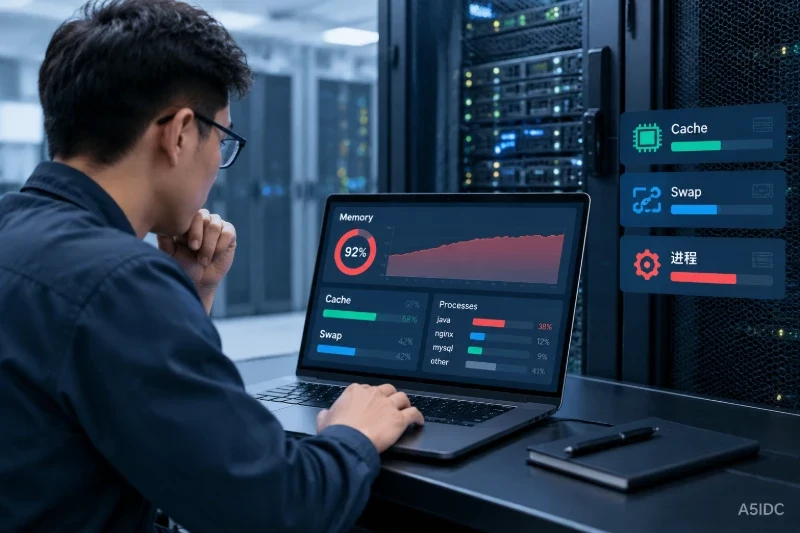
Linux会主动利用空闲内存做文件缓存,因此一台运行正常的服务器,free可能并不大,但available仍然充足。把“used很高”直接等同于“内存不够”,容易把正常缓存误判为内存压力。
需要注意,available也是估算值,不是业务可以无条件使用的容量。内核、驱动、共享内存、文件缓存、容器限制和瞬时分配都可能影响实际结果。判断时应观察业务高峰期的最低可用值,而不是只执行一次命令。
服务器产品或服务配置中的“8G”,可能按十进制GB标注;Linux命令则经常使用GiB显示。除此之外,内核和其他系统组件也可能占用一部分内存,所以购买或配置的容量不一定会完整出现在应用可用数字中。
因此,不要因为8G服务器在系统中显示约7.xGiB,就直接认为内存异常。关键是确认:
available是否足够;查看进程时,常用的%MEM和RSS可以快速找到占用较大的进程:
ps -eo pid,ppid,comm,%mem,rss --sort=-rss | head -n 15
其中,RSS通常以KB显示,表示进程当前驻留在物理内存中的页面规模;%MEM是RSS占总内存的比例。
但RSS不适合简单相加。多个进程可能共享同一组动态库、共享内存或内存映射文件,如果把每个进程的RSS直接相加,可能重复计算共享页面。
更细致的判断应关注PSS。PSS会按共享进程数分摊共享页面,通常更适合估算多个进程合计对物理内存的实际压力。部分Linux系统可以使用smem查看:
smem -tk
如果没有安装smem,也可以针对某个进程读取内核提供的汇总信息:
PID=进程号
cat /proc/$PID/smaps_rollup | egrep '^(Pss|Private|Shared|Swap)'
smaps_rollup并非所有较老内核都提供。遇到路径不存在时,应先确认内核版本和系统能力,不要把RSS列表当成精确的PSS结果。
实际判断时,可以按下面的顺序处理:
如果一个应用有多个Worker进程,不能只观察主进程。主进程可能只占几百MB,但十几个Worker加起来可能占用数GB。数据库、运行时环境和任务队列也常常存在“平时不高、峰值明显上升”的特点。
可以把内存规划简化为一个便于操作的估算关系:
计划内存容量 ≈ 业务进程峰值 × 增长或突发系数 + 系统与内核占用 + 预留余量
这里的“业务进程峰值”应尽量使用同一高峰时间窗口内的PSS合计;“系统与内核占用”包括无法简单归入业务进程的部分;“预留余量”用于应对新连接、短时任务、日志处理、内存碎片和下一阶段增长。
文件缓存不一定要全部额外加到公式中,因为其中一部分可以回收。但如果业务明显依赖文件缓存来降低延迟,就不能把缓存完全视为无关占用,应通过高峰期表现判断是否需要保留缓存空间。
以下是普通服务环境中可以作为初步判断的经验线:
| 高峰期表现 | 初步判断 |
|---|---|
available长期保持在总内存的30%左右或以上,且没有持续交换活动 | 通常有较充足的缓冲空间,但仍需考虑增长 |
available约为总内存的15%到30%,偶尔出现短时下降 | 需要结合并发峰值、响应延迟和交换活动继续观察 |
available反复低于总内存的10%到15% | 余量偏紧,应评估减少进程、限制并发或增加内存 |
| 高峰期持续换入换出、出现OOM或服务延迟明显抖动 | 不能继续按当前容量运行,应优先处理内存压力 |
这些比例不是所有业务的硬性标准。对延迟敏感的数据库、容器密集型节点和有明显流量突发的应用,通常需要更大的余量;低并发、可接受短时降速的后台任务,余量要求可能不同。
Linux中可以用下面的命令观察短时间内的内存和交换活动:
vmstat 1 5
重点关注:
si:从交换空间换入内存的数据量;so:从内存换出到交换空间的数据量;free、buff、cache:内存状态的变化;si和so。服务器曾经使用过少量Swap,并不等于内存一定不够。系统可能把很久没有访问的页面换出,之后也没有再次读取。更值得关注的是高峰期持续换入换出,并同时伴随响应变慢、I/O等待升高或进程被终止。
下面用一组示例数据说明判断方法。假设一台标注为8G的Linux服务器,系统识别到约7.5GiB内存。在业务高峰期,观察到:
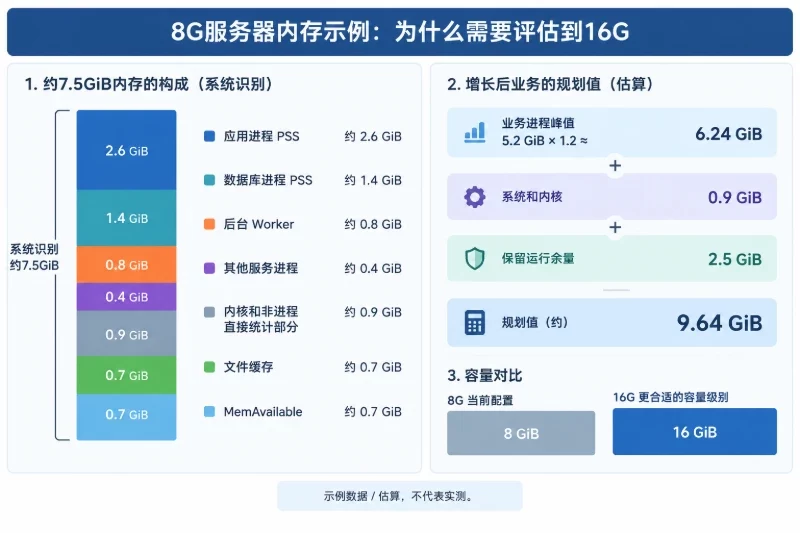
MemAvailable只剩约0.7GiB。主要业务进程合计约为5.2GiB。虽然系统还没有立刻崩溃,但可用余量约占总内存的十分之一,已经不适合把当前状态当成长期安全容量。若此时还伴随交换活动、连接数增长或任务高峰,8G就可能成为瓶颈。
再按20%的业务增长或短时突发进行估算:
这个结果并不意味着必须精确购买“9.64G”,而是说明8G缺少合理缓冲,16G会比继续维持8G更合适。若服务还包含大容量数据库缓存、更多容器或更高增长预期,则需要重新采样,不能只按这个例子套用。
容量选择应以高峰期观测结果为主,下面的范围只用于建立初步预期:
| 内存容量 | 更适合的条件 | 需要特别确认的事项 |
|---|---|---|
| 8G | 单一或少量服务,进程峰值较稳定,业务并发较低,长期余量充足 | 不要只看空闲时占用;确认高峰、更新任务和日志处理不会瞬间挤满内存 |
| 16G | 多个应用进程、较小数据库、若干后台任务或中等并发服务 | 统计Worker、连接池、运行时堆和缓存,避免只看Web主进程 |
| 32G | 多容器、较大的数据库缓存、较多并发、批处理或需要更大增长空间的服务 | 确认业务确实能利用容量,同时检查应用自身的内存上限和缓存配置 |
8G不是只能用于测试环境。如果业务进程在高峰期合计约3G到4G,系统和内核占用稳定,available仍有较大比例,且没有持续Swap活动,8G可以满足一类轻量服务。
但如果8G服务器同时运行Web服务、数据库、定时任务、监控和构建任务,即使CPU型号与另一台16G服务器完全相同,也不能因为CPU一样就认为内存配置应该一样。
16G通常适合多个常驻服务并行运行的中等负载场景。典型判断不是“CPU有多少核心”,而是业务高峰时:
available反复偏低;如果只是空闲时占用2G左右,却没有采集高峰数据,直接从8G跳到16G也未必能解决真实问题。
32G更适合内存占用具有明显规模效应的场景,例如多个容器同时运行、数据库需要较大缓冲区、任务会并行创建大量Worker,或者业务需要保留较大的数据集和文件缓存。
不过,32G也不是“配上就一定更快”。如果应用进程本身限制在4G,数据库缓存配置没有使用新增空间,或者真正瓶颈在CPU、磁盘和网络,增加内存只能增加余量,不能直接提升相应组件的性能。
Linux环境建议至少采集以下信息:
free -h
ps -eo pid,ppid,comm,%mem,rss --sort=-rss | head -n 15
vmstat 1 5
观察周期不要只停留在登录后的瞬间。应覆盖正常高峰、定时任务、批量导入、构建、备份或流量突增等实际场景。若服务通过容器运行,还要同时检查容器自身的内存限制,因为宿主机还有余量时,容器也可能先触发自己的限制。
对容器场景来说,至少要区分三种情况:
这三种情况的处理方式不同,不能只看宿主机总内存。
Windows中可以在任务管理器的“性能—内存”页面查看已用、可用和已提交内存,再通过“资源监视器”观察各进程的工作集、提交大小和硬错误活动。
判断时可关注:
Windows进程的Working Set也可能包含共享页面,因此多个进程的工作集相加同样可能重复计算。分析单个服务时,Private Bytes和一段时间内的增长趋势往往比一次性的工作集更有参考价值。
CPU低不代表内存充足。进程可能在等待内存、磁盘或网络,或者大量内存被数据库缓存和运行时堆占用。内存是否需要扩容,要看内存压力指标,不能用CPU空闲来替代。
主进程占用较小,不代表整个服务占用较小。应把同一应用的Worker、任务进程、连接池、Sidecar或配套组件一起纳入统计。
RSS适合快速定位大进程,但共享库和共享内存会造成重复计算。进行容量规划时,应使用PSS、Private Bytes或服务级别的内存统计,并明确统计口径。
Linux文件缓存会在需要时回收。缓存较大本身不一定是问题,但如果回收缓存后仍没有足够空间,或者回收过程导致I/O等待和延迟上升,就说明系统余量可能不足。
Swap使用量是历史状态,不能独立证明当前内存不足。应结合持续换入换出、响应时间、页面错误、OOM日志和高峰期available一起判断。
如果当前高峰刚好还能运行,但业务连接数、数据库数据量、容器数量或Worker数会继续增长,就应把增长系数纳入规划。容量选择应覆盖可预期的使用周期,而不是只满足今天的瞬间状态。
在以下情况下,采用统一内存配置可以减少管理复杂度:
但即使采用统一配置,也应先以负载最高的节点、故障转移后的承载量和预留策略为依据。统一配置是为了满足运维和可用性要求,不是因为CPU型号本身决定了内存容量。
如果只是两台服务器使用相同CPU,但一台运行单一网站,另一台运行数据库和多个后台任务,盲目配置相同内存反而可能让前者资源闲置、后者余量不足。
最终可以把判断压缩成一句话:先在业务高峰期看进程PSS或合理口径的进程占用,再看available、Swap活动和系统提交压力,最后加入增长与突发余量。只有当这些条件相近时,相同CPU配相同内存才有参考价值;否则,8G、16G和32G应按照实际工作负载分别评估。