

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


内地访问香港服务器出现卡顿,不应先假定是服务器配置或带宽不足。一次页面打开慢,可能来自本地网络抖动、DNS解析延迟、跨境路由拥塞、链路丢包、服务器资源排队,也可能是应用处理请求过慢。排查的第一步,是把“卡顿”拆成可测量的环节,确认问题发生在用户到服务器的哪一段。
推荐顺序是:先检查本地网络,再验证DNS,再用ping观察端到端时延和丢包,用traceroute或tracert查看路径变化,随后检查服务器负载,最后用应用层请求确认真实响应时间。若准备把普通带宽升级为CN2 GIA,应保留服务器、域名、应用、客户端和测试方法不变,只改变出口线路;否则同时修改DNS、服务器配置和应用参数,升级前后的差异就无法归因。
一次完整的网页或接口请求,大致包含以下阶段:
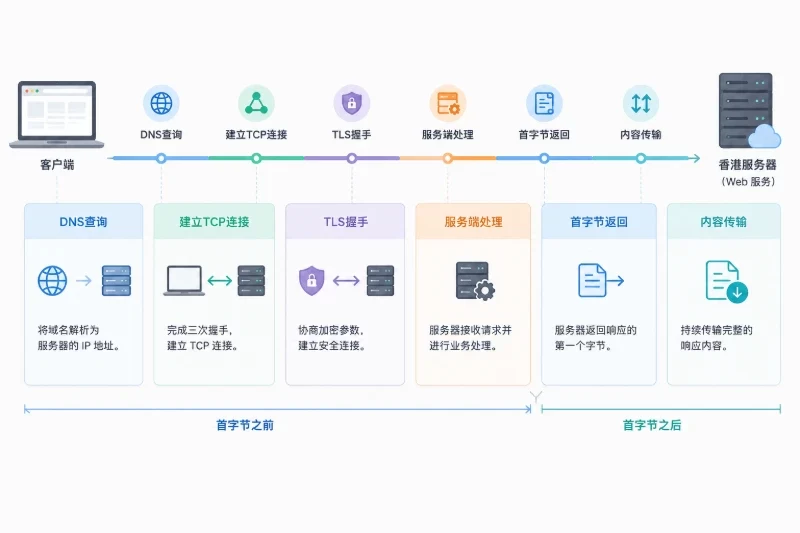
因此,“ping延迟高”只能说明ICMP探测的往返时间,不能直接证明应用响应慢;“页面打不开”也不一定是线路丢包,可能只是DNS解析失败或应用进程没有及时返回。
建议在排查表中至少记录以下指标:
| 检查对象 | 主要指标 | 能够回答的问题 |
|---|---|---|
| 本地网络 | 默认网关延迟、抖动、丢包 | 卡顿是否在离开本地网络前已经出现 |
| DNS | 多次查询耗时、解析结果 | 域名解析是否慢,是否解析到了不同地址 |
| 目标连通性 | Ping平均值、最大值、丢包率 | 客户端到服务器的端到端路径是否稳定 |
| 路由路径 | 每一跳地址和往返时间 | 哪一段路径可能出现拥塞或绕路 |
| 服务器 | CPU、内存、磁盘等待、连接数 | 服务器是否因资源排队导致响应变慢 |
| 应用响应 | DNS、连接、TLS、首字节、总耗时 | 慢在网络建立阶段,还是慢在应用处理阶段 |
测试时不要只记录一次结果。Ping至少收集20至30个样本,应用请求至少执行5至10次,并分别记录空闲时段和出现卡顿时段。下文的数值均为用于说明判断方法的参考或模拟数据,不代表某个具体线路、时间段或服务器的实测结果。
在切换普通带宽和CN2 GIA前,先固定以下条件:
如果升级线路后服务器IP发生变化,严格来说,变化的不只是线路,目标IP和路由也发生了变化。此时可以得出“升级后的新路径是否改善”,但不能把全部差异都归因于CN2 GIA本身,需要在记录中标注这一限制。
如果本地电脑到默认网关就存在高延迟或丢包,继续测试香港服务器没有意义。此时应先暂停本地上传、下载、云盘同步和视频业务,再重新测试。
以下命令适用于常见Linux客户端,仅进行查询和探测,不会修改网络配置:
ip route | awk '/default/ {print $3; exit}'
ping -c 30 -i 0.2 192.168.1.1
将192.168.1.1替换为上一条命令显示的默认网关地址。重点观察:
例如,默认网关平时为2至5毫秒,偶尔升到200毫秒以上,通常说明本地无线接入、局域网占用或上行队列存在问题。这里的数值只是常见参考,具体判断应以同一客户端的空闲基线为准。
先执行:
ipconfig
找到“默认网关”地址,再执行:
ping -n 30 192.168.1.1
如果默认网关持续稳定,但香港服务器仍然卡顿,问题更可能出现在DNS、跨境路由、目标服务器或应用层。反过来,如果默认网关本身就出现丢包,升级服务器线路不会解决本地网络问题。
本地层的验证结果可以按下面方式理解:
| 默认网关结果 | 香港服务器结果 | 优先判断 |
|---|---|---|
| 高延迟或丢包 | 任意 | 先处理本地网络,不判断服务器线路 |
| 稳定 | 高延迟或丢包 | 继续检查DNS、路由和目标侧 |
| 稳定 | Ping正常但页面慢 | 重点转向服务器负载和应用响应 |
| 稳定 | 仅高峰期变慢 | 需要做同时间段的线路对照测试 |
DNS问题常被误认为“香港服务器延迟高”。如果域名查询本身需要数百毫秒,或者不同解析器返回了不同IP,客户端甚至还没有连接到服务器,页面就已经产生了等待。
以下命令适用于安装了dig的Linux或macOS客户端:
dig example.com A
dig @223.5.5.5 example.com A
dig @114.114.114.114 example.com A
将example.com替换为实际业务域名。关注输出中的:
Query time:本次DNS查询耗时;ANSWER SECTION:实际返回的IP地址;如果系统没有dig,可以先使用:
getent ahosts example.com
这能确认系统当前解析到的地址,但不会像dig一样直接展示每个DNS服务器的查询耗时。
nslookup example.com
nslookup example.com 223.5.5.5
nslookup example.com 114.114.114.114
如果不同DNS服务器返回不同地址,应先记录差异,不要马上更换DNS并同时升级线路。因为更换DNS可能导致客户端访问另一组前端地址,线路升级前后的变量就不再单一。
可以单独进行本地缓存刷新,但这只影响当前客户端的DNS缓存,不会修改服务器配置:
ipconfig /flushdns
Linux使用systemd-resolved时,可以尝试:
resolvectl flush-caches
如果系统没有该命令,不要强行修改解析服务,直接通过多次查询记录现象即可。
Linux客户端执行:
ping -c 30 -i 0.2 198.51.100.10
Windows客户端执行:
ping -n 30 198.51.100.10
198.51.100.10是文档示例地址,实际使用时替换为香港服务器IP。
需要记录:
Ping结果不能单独证明以下事项:
许多网络设备会限制或降低ICMP响应优先级。如果某个中间节点显示丢包,但后续节点和最终服务器都没有继续丢包,通常更像是该节点对探测报文限速,而不是实际转发丢包。只有丢包从某一跳开始持续到最终目标,且应用层请求也同步失败,才更值得怀疑该路径区段。
假设某次测试得到以下模拟结果:
| 测试对象 | 平均延迟 | 最大延迟 | 丢包率 |
|---|---|---|---|
| 默认网关 | 3ms | 5ms | 0% |
| 香港服务器,空闲时段 | 42ms | 58ms | 0% |
| 香港服务器,高峰时段 | 45ms | 310ms | 3% |
这组结果说明本地网络基本稳定,但目标路径在高峰时段出现明显抖动或丢包。它还不能直接证明一定是普通带宽不足,因为服务器负载、应用请求量和目标侧防护策略也可能同时在高峰期变化,需要继续用服务器和应用指标排除替代解释。
如果平均延迟始终稳定,但最大延迟偶尔很高,通常要关注抖动和队列;如果平均值、最大值和丢包率都同步升高,线路拥塞的可能性会更高。
traceroute -n -q 3 -w 1 198.51.100.10
参数含义:
-n:不进行反向DNS解析,避免显示过程被DNS拖慢;-q 3:每一跳发送3个探测包;-w 1:每个探测包等待1秒;如果系统没有traceroute,但安装了tracepath,可以使用:
tracepath -n 198.51.100.10
tracert -d 198.51.100.10
-d表示不解析主机名,可以减少输出等待。
Traceroute的每一行通常包含多个探测结果。判断时不要只盯着某一跳的最高数字,因为每一跳显示的是“客户端到该跳”的累计往返时间,不是该跳单独增加的延迟。更可靠的观察方式是:
例如:
| 现象 | 更合理的解释 |
|---|---|
某中间跳出现*,后续跳和目标正常 | 该节点可能限制探测响应,不能直接判定链路丢包 |
| 某一跳开始延迟升高,后续各跳也持续升高 | 该跳之后的路径可能存在拥塞或绕路 |
| 路由跳数变化,但目标Ping和应用无变化 | 路径变化未必影响实际业务质量 |
| 路由看似正常,但应用首字节很慢 | 重点检查服务器和应用处理,不要只看路由 |
| Ping被过滤,但HTTPS请求正常 | ICMP不可用,不能据此判定业务中断 |
Traceroute能帮助观察路径和变化,不能提供运营商侧的完整链路证明,也不能代替应用层测试。升级线路后,如果路由确实切换到另一条路径,同时高峰期丢包和抖动下降,才具备较强的关联性。
网络指标正常而页面仍然卡顿时,应登录服务器查看资源使用情况。以下命令适用于常见Linux服务器,都是只读查询:
date -Is
uptime
nproc
vmstat 1 5
free -h
ss -s
重点关注:
uptime中的负载值是否长期高于CPU核心数;vmstat中的r是否持续较高,说明运行队列堆积;wa是否较高,说明进程可能在等待磁盘I/O;si和so是否持续出现,说明存在交换分区读写压力;free -h显示的可用内存是否持续不足;ss -s中的连接数是否在卡顿时段异常增加。load average不能脱离CPU核心数判断。例如,8核心服务器负载为4,和2核心服务器负载为4,含义并不相同。资源指标应与应用日志时间戳、Ping时间和请求耗时对齐,不能看到CPU瞬时达到90%就直接认定是根因。
如果服务器使用Nginx或其他Web服务,还应查看现有访问日志中是否记录了请求耗时。Nginx常见的request_time表示完整请求处理时间,upstream_response_time可以反映上游应用响应时间,但前提是日志格式已经配置了这些字段。不要仅凭访问日志中的状态码判断速度:返回200不代表响应及时,返回502也可能是上游应用超时而不是线路丢包。
可以建立一份时间对照表:
| 时间 | Ping平均值 | Ping最大值 | CPU/IO | 应用首字节 | 页面总耗时 |
|---|---|---|---|---|---|
| 10:00 | 43ms | 58ms | 正常 | 0.32s | 0.71s |
| 10:30 | 44ms | 61ms | CPU较高 | 2.10s | 2.46s |
| 11:00 | 45ms | 290ms | 正常 | 1.40s | 1.96s |
上例中,10:30更像服务器或应用处理排队;11:00则更像网络抖动,但仍需结合路由和丢包结果确认。
选择一个无副作用、只读的健康检查接口或测试页面,不要用会创建订单、修改数据或触发高成本任务的URL:
curl -sS -o /dev/null \
  --connect-timeout 5 \
  --max-time 20 \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s first_byte=%{time_starttransfer}s total=%{time_total}s code=%{http_code}\n' \
  https://example.com/health
将域名和路径替换为实际业务地址。建议连续执行5至10次,记录每次结果,不要只看一次请求。
各字段可以这样理解:
time_namelookup:DNS解析耗时;time_connect:建立TCP连接完成的时间点;time_appconnect:HTTPS TLS握手完成的时间点;time_starttransfer:收到首字节的时间点;time_total:整个请求结束的总耗时。可按下面方式拆分:
time_connect - time_namelookup;time_appconnect - time_connect;time_starttransfer - time_appconnect;time_total - time_starttransfer。如果怀疑DNS解析结果影响测试,可以使用--resolve,让Curl直接连接指定IP,同时仍然使用原域名作为HTTPS的SNI和HTTP Host:
curl -sS -o /dev/null \
  --resolve example.com:443:198.51.100.10 \
  --connect-timeout 5 \
  --max-time 20 \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s first_byte=%{time_starttransfer}s total=%{time_total}s code=%{http_code}\n' \
  https://example.com/health
该方式适用于证书和虚拟主机配置依赖域名的HTTPS服务。若证书、Host路由或访问控制不允许直接测试,应使用业务方提供的正式测试入口,不要为了验证而关闭证书校验。
应用层结果可以按以下方式判断:
| Curl表现 | 重点方向 |
|---|---|
| DNS耗时高,后续时间正常 | DNS或本地解析链路 |
| 连接耗时高,Ping也抖动 | 路由、丢包或出口拥塞 |
| TLS耗时高,连接正常 | TLS协商、证书链或服务端握手资源 |
| 首字节耗时高,Ping稳定 | 应用进程、数据库或后端依赖排队 |
| 首字节正常,总耗时高 | 返回内容大、下行拥塞或传输阶段受限 |
| Ping和Curl都正常,浏览器仍卡 | 页面内部接口、脚本执行或单个资源异常 |
带宽和延迟不是同一个概念:
因此,普通带宽升级为CN2 GIA后,可能改善高峰期排队和路径稳定性,但不应预先承诺一定降低所有请求的基础Ping,也不能解决服务器CPU不足、DNS错误或应用查询缓慢。
升级前建议完成以下记录:
如果测试过程中已经发现本地网关丢包、DNS返回错误地址或服务器负载异常,应先处理这些问题,再进行线路对照。否则,即使升级后现象暂时缓解,也无法证明是线路发挥作用。
切换到CN2 GIA时,尽量保持以下条件不变:
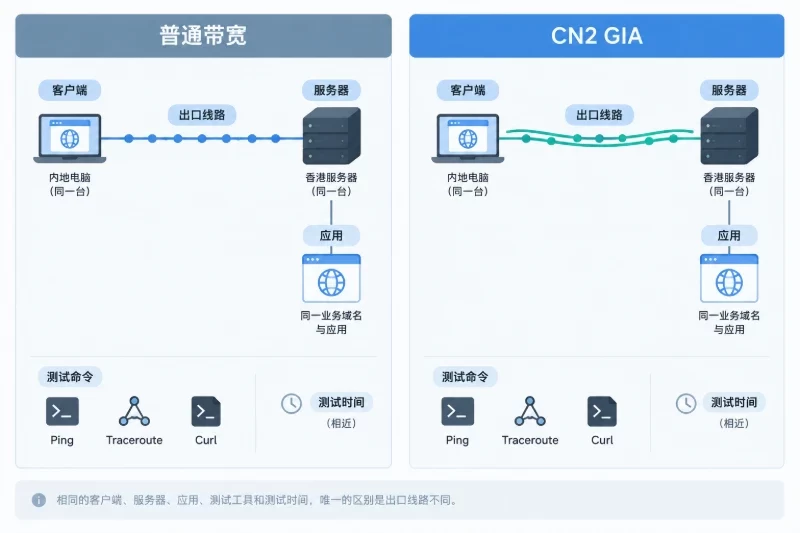
| 条件 | 升级前后要求 |
|---|---|
| 客户端 | 同一台内地客户端、同一接入网络 |
| 服务器 | 同一实例、同一系统和资源配置 |
| 应用 | 同一版本、同一接口和数据规模 |
| DNS | 不同时更换解析服务 |
| 测试命令 | Ping、Traceroute、Curl参数一致 |
| 测试时间 | 先做相近时间对照,再补充同一高峰时段复测 |
| 采样数量 | 前后保持一致 |
| 其他变更 | 不同时修改缓存、压缩、数据库和防护策略 |
如果升级过程更换了服务器IP,应同时保留旧IP的升级前数据,并对新IP单独建立基线。应用层可以使用curl --resolve固定域名和目标地址,但这只能减少DNS变量,不能把不同IP完全等同于同一条线路。
升级完成后,不要只打开一次网页判断效果。使用相同命令重复:
下面是一组用于说明判断过程的模拟对照数据:
| 指标 | 普通带宽,高峰时段 | 升级后,高峰时段 | 可观察变化 |
|---|---|---|---|
| 默认网关平均延迟 | 3ms | 3ms | 本地条件未变 |
| 目标Ping平均值 | 68ms | 46ms | 基础路径时延下降 |
| 目标Ping最大值 | 260ms | 63ms | 抖动减小 |
| 目标Ping丢包率 | 4% | 0% | 端到端稳定性改善 |
| Curl首字节 | 1.45s | 0.48s | 服务端前等待缩短 |
| Curl总耗时 | 1.92s | 0.76s | 页面整体变快 |
| 服务器CPU | 38% | 39% | 服务器负载基本一致 |
如果实际结果接近这个模式,且Traceroute也显示路径发生变化,可以较有把握地判断:原先的卡顿与普通出口在该时段的路径拥塞或队列有关,升级线路产生了改善。但这仍然是特定客户端、目标IP、时间段和业务请求下的结论,不代表所有内地网络和所有时段都会得到相同结果。
| 升级前后变化 | 判断边界 |
|---|---|
| Ping、丢包、Traceroute和应用耗时同时改善 | 线路或出口路径很可能是主要因素 |
| Ping改善,但首字节几乎不变 | 网络路径改善了,应用处理可能仍是瓶颈 |
| Ping不变,总下载时间改善 | 原先可能是传输容量或队列问题,基础路径距离未变 |
| Ping改善,但服务器CPU同时下降 | 不能只归因于线路,服务器负载变化是混杂变量 |
| Ping不变,应用仍慢,服务器负载高 | 优先处理应用、数据库或服务器资源 |
| 升级后DNS解析到不同IP | 先区分DNS变化和线路变化,不能直接归因 |
| 中间路由显示丢包,但最终请求正常 | 可能是中间节点限制ICMP响应 |
| 所有指标几乎不变 | 原线路可能不是瓶颈,或测试没有覆盖真正卡顿时段 |
单次Ping容易受瞬时队列、服务器ICMP限速和本地网络活动影响。至少应在正常时段和卡顿时段各收集一组样本,并与Curl结果对照。
中间节点不响应探测并不等于不转发业务。应观察后续节点和最终目标是否也出现相同问题,并用HTTPS请求验证业务是否受影响。
DNS变化可能带来新的目标IP和新的访问路径。若必须更换DNS,应把它作为独立变量,先完成DNS前后的对照,再进行线路测试。
Ping只测ICMP往返,不会触发应用代码、数据库查询和页面渲染。若Ping稳定而Curl首字节从300毫秒升至2秒,应该检查应用和服务器,而不是继续重复Ping。
短时间改善可能只是避开了高峰队列,也可能是缓存命中或应用负载下降。需要在相近时段重复测试,并至少覆盖一次实际卡顿窗口。
修复或升级后,建议按同一模板保存记录:
测试时间:
客户端网络:
服务器IP:
业务域名:
DNS解析结果:
线路状态:
默认网关Ping:
目标服务器Ping:
Traceroute文件:
Curl首字节/总耗时:
服务器CPU、内存、I/O:
是否处于卡顿时段:
一次完整的验证应同时满足以下条件:本地网关稳定,DNS结果可解释,目标Ping或应用层连接没有异常丢包,Traceroute路径变化与现象相互印证,服务器负载没有发生未记录的变化,Curl首字节和总耗时在相同条件下得到改善。
如果升级普通带宽为CN2 GIA后,只有Ping数字变化而业务请求没有改善,不能把它视为完整解决;如果应用请求明显改善但服务器负载也同步变化,则需要保留多个可能原因。最终判断应限定在已测试的客户端、目标IP、时间段、请求类型和采样数量内,并在后续高峰时段继续复测,避免把一次对照结果扩大为没有条件限制的线路承诺。


