香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


很多人误以为,只要高防香港服务器的带宽没有被打满,就说明CC攻击影响不大。实际情况可能相反:攻击者以大量低速、分散、看似正常的HTTP请求访问登录、搜索、商品详情或接口地址,四层连接数量和带宽都不突出,但应用线程、数据库连接和接口响应时间已经持续升高。仅靠IP封禁或TCP连接数,往往无法准确识别这类攻击。
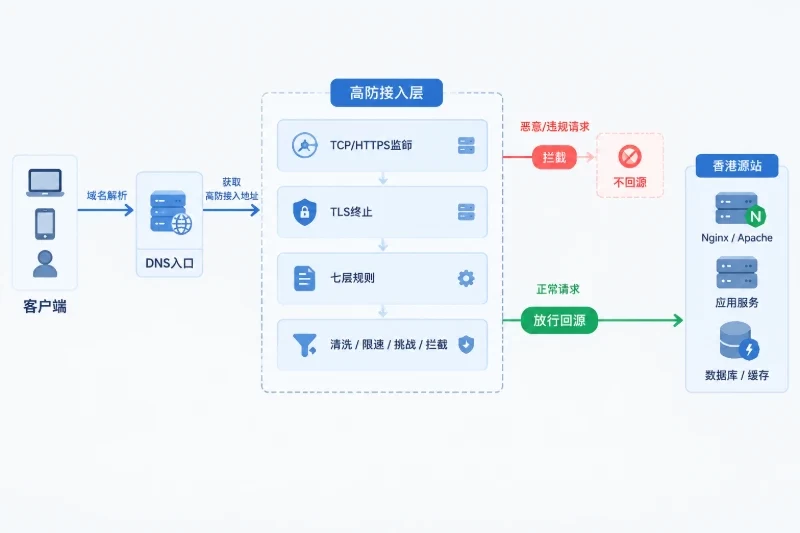
一套可落地的高防香港服务器对抗CC攻击解决方案:七层流量清洗与智能拦截配置方案,核心是让流量先经过具备HTTPS解析和HTTP请求分析能力的清洗节点,再根据请求频率、访问路径、会话状态、响应码、来源分布和接口成本进行综合判断。验证规则是否有效时,不能只看“拦截数增加”,还要同时确认源站请求量、合法用户成功率、响应延迟和误拦截情况是否改善。
四层防护主要观察IP、端口、连接数、连接速率、TCP状态和数据包特征。它适合处理连接洪泛、异常握手或明显的网络层流量,但无法直接回答以下问题:
七层清洗则会在HTTP或HTTPS代理层解析请求内容。两者的区别可以用下面的方式理解:
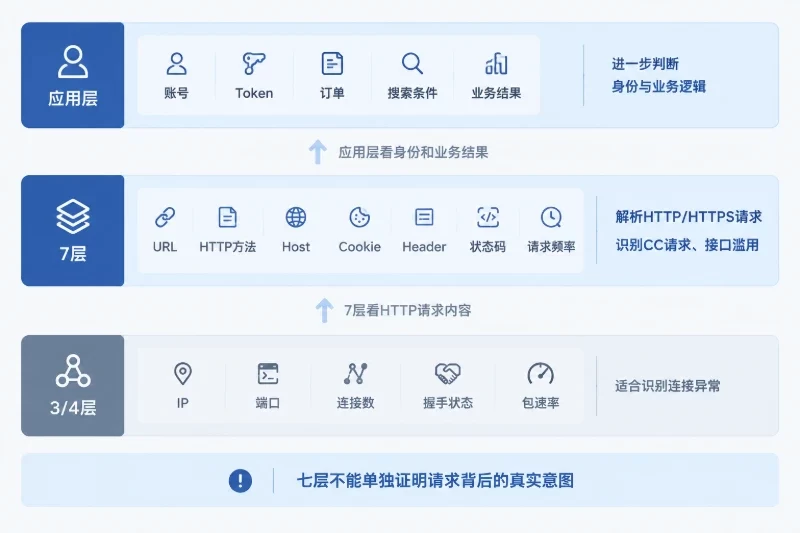
| 观察层级 | 可识别的主要信号 | 能解决的问题 | 不能单独证明的事情 |
|---|---|---|---|
| 三层、四层 | IP、端口、连接数、握手状态、包速率 | 连接异常、端口冲击、明显的网络流量洪峰 | 请求是否为真实用户、访问哪个业务接口 |
| 七层 | URL、方法、Host、Cookie、Header、状态码、请求频率 | CC请求、接口滥用、异常会话、路径集中访问 | 请求背后的真实意图,或带有效凭证的业务滥用 |
| 应用层 | 账号、Token、订单、搜索条件、业务结果 | 单账号滥用、接口配额、业务逻辑攻击 | 网络侧全部流量特征 |
CC攻击通常处于七层与应用层之间。它未必使用畸形数据包,而是构造大量能够被Web服务接受的请求。因此,七层清洗的关键不是判断“这个IP是不是坏人”,而是判断“这批请求是否以异常方式消耗了业务资源”。
服务器位于香港,并不自动代表具备七层CC识别能力。真正决定效果的是流量路径和清洗能力:
如果请求在清洗节点之后仍然可以直接到达源站,七层规则只能保护经过代理的那部分流量,无法覆盖绕过路径。若HTTPS始终端到端加密,清洗层也看不到URL、Cookie和请求体,只能依靠连接级信号或由后端应用提供决策信息,识别精度会受到限制。
请求进入清洗节点后,通常会经历以下处理:
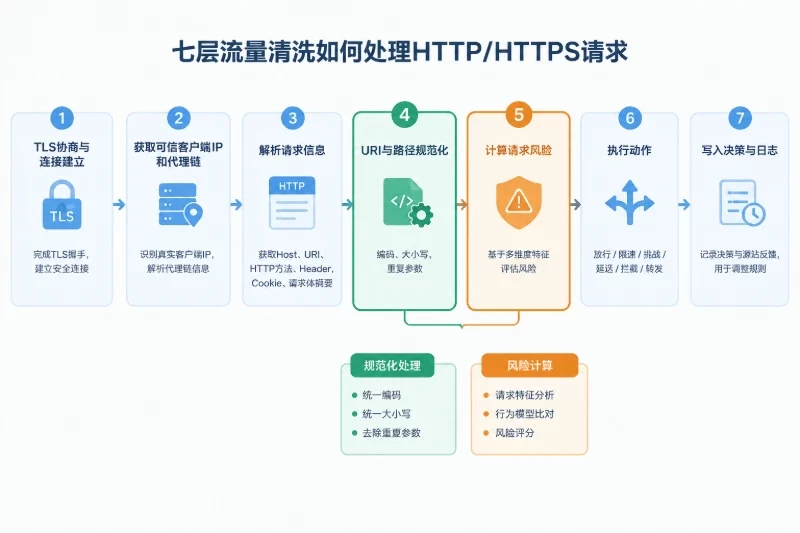
“规范化”非常重要。例如,攻击者可能通过不同的URL编码、无意义参数或大小写变化,制造大量看似不同的请求。如果清洗节点不做规范化,/search、/search?x=1和经过编码变形的请求可能被错误地分成多个对象,影响聚合判断。
智能规则不能只使用一个固定阈值。正常访问量在不同时间段、不同接口和不同业务活动下可能差异很大。
常见基线维度包括:
例如,登录接口在普通时段可能只有每秒几十次请求,但促销或集中登录时会短时升高。如果把“每秒超过50次”永久设置为封禁条件,真实业务高峰很容易被误判。更合理的方式是观察相对于近期基线的变化:
单个信号只能说明“值得观察”,多个信号同时出现,才更适合进入限速或拦截阶段。
基础指标是某个观察对象在时间窗口内的请求数:
单键请求速率 = 窗口内请求数 ÷ 窗口长度(秒)
“单键”可以是IP、IP加路径、会话ID、API Token、路径聚合或来源网络。不同键对应不同用途:
| 统计键 | 适合识别的情况 | 主要风险 |
|---|---|---|
| 单IP | 单一来源高速重复请求 | NAT环境下可能误伤多人 |
| IP+路径 | 某IP持续刷同一接口 | 分布式攻击容易绕过 |
| 会话ID | 单个会话异常调用 | 攻击者可频繁更换会话 |
| API Token或账号 | 有效凭证被滥用 | 需要应用层提供可信身份 |
| 路径总量 | 多来源集中攻击同一接口 | 需要保护正常业务高峰 |
| IP+路径+方法 | 区分GET和POST等行为 | 规则维度更复杂 |
因此,实际规则通常会组合使用。例如,先以“IP+路径”进行温和限速,再以“路径总量+异常状态码比例”识别分布式请求,最后对具有有效身份的正常客户端应用独立配额。
不同接口消耗的资源并不相同。访问静态健康检查页面,可能只占用很少资源;一次搜索、推荐、报表或复杂筛选请求,可能触发数据库查询和多次内部调用。
只按请求数统计,会出现两个问题:
可以使用“请求数乘以平均响应耗时”作为成本代理值进行比较。它不是精确的CPU消耗,但能帮助区分轻量请求和重型请求。例如:
以请求数乘平均耗时估算,接口A的代理成本为30,000毫秒,接口B为80,000毫秒。接口B请求更少,但可能对源站压力更大,因此应设置更严格的单客户端配额或更高优先级的保护规则。
CC攻击常见特征包括:
这些特征不能单独作为封禁依据。例如,首次访问的真实用户本来就可能没有Cookie,隐私设置也可能导致Cookie不可用。更稳妥的处理方式是将“无Cookie”作为风险加分项,与高频率、异常状态码或路径集中访问同时出现时,再提高处置等级。
如果攻击者使用大量来源地址,每个IP都低于单IP阈值,单IP限速就会失效。这时需要观察:
反过来,不能因为来源数量多就直接判定为攻击。大型企业网络、移动网络和校园网络可能共享出口地址,多个真实用户也可能在短时间内访问同一页面。
状态码能帮助判断请求是否形成了有效业务行为:
状态码需要结合接口和身份判断。比如API客户端大量返回401,可能是调用方配置错误;如果同时出现来源快速变化、参数高度重复和请求频率异常,攻击可能性才更高。
“智能拦截”不等于立即封禁。合理的动作通常是分层的:
| 风险状态 | 典型条件 | 建议动作 | 验证重点 |
|---|---|---|---|
| 低风险异常 | 速率略高于基线,业务结果正常 | 仅记录 | 观察是否为正常高峰 |
| 中风险异常 | 速率较高,伴随新会话或异常状态码 | 限速、延迟或返回429 | 合法请求成功率是否下降 |
| 高风险异常 | 多个特征同时出现,且源站指标恶化 | 浏览器挑战或二次校验 | 非浏览器API是否被误伤 |
| 明显攻击 | 持续高频、规则命中稳定、来源与行为高度一致 | 临时拦截 | 拦截后源站是否恢复 |
| 业务身份滥用 | 有效账号或Token持续超配额 | 按账号、Token或接口限额 | 是否影响同一身份的正常请求 |
浏览器挑战适合网页访问,但不应直接套用到机器对机器的API。API更适合返回明确的限速状态、要求调用方退避,或按Token设置配额。对登录、支付、下单等接口,还要考虑业务流程,不能只用通用的网页挑战代替身份和风控判断。
无论使用哪种高防控制台或清洗系统,规则至少应明确以下内容:
下面是一个用于说明规则结构的示意配置,不对应某个具体服务的可直接部署格式。实际字段应以所使用的清洗系统为准:
rules:
  - id: login-burst-observe
    scope:
      host: "example.com"
      path: "/login"
      methods:
        - "POST"
    key: "source_ip + path"
    window: "10s"
    conditions:
      request_rate: "> baseline * 3"
      invalid_response_ratio: "> 0.40"
    action: "observe"
    exception:
      client_tag:
        - "approved-api-client"
    duration: "15m"

  - id: api-distributed-rate-limit
    scope:
      path_prefix: "/api/search"
      methods:
        - "GET"
        - "POST"
    keys:
      - "source_ip + path"
      - "path_global"
    window: "60s"
    conditions:
      source_ip_rate: "> reference_threshold"
      global_path_rate: "> baseline * 4"
    action: "rate_limit"
    response_status: 429
    duration: "10m"
这里的baseline、reference_threshold和异常比例都只是规则表达示例,不能直接当作通用阈值。接口是否适合限速,需要结合正常峰值、接口成本、合法客户端数量和业务容忍度决定。
规则上线可采用以下顺序:
这种方式可以避免一次配置错误造成大面积业务中断,也方便判断到底是规则命中有效,还是源站自身流量自然回落。
测试前先确认以下事实:
如果清洗日志显示所有请求都来自同一个代理地址,不能马上进行IP规则测试。应先确认可信代理头的传递和解析方式。只有来自受信任代理链的客户端地址才可以用于限速键,否则攻击者可能伪造Header,或者所有真实用户被错误归为同一个来源。
至少选取一个业务稳定时段,记录以下指标:
| 指标 | 建议观察内容 |
|---|---|
| 边缘请求量 | 总请求数、每秒请求量、突发峰值 |
| 源站请求量 | 回源QPS、动态请求占比 |
| 来源分布 | 独立IP数、单IP请求量、来源集中度 |
| 接口分布 | 各路径请求量和HTTP方法比例 |
| 响应结果 | 2xx、3xx、4xx、5xx比例 |
| 性能指标 | 平均响应时间、P95/P99、连接等待 |
| 资源指标 | CPU、内存、连接池和数据库等待 |
| 规则结果 | 观察、限速、挑战、拦截数量 |
| 业务指标 | 登录成功率、搜索成功率、API调用成功率 |
基线不应只记录一个瞬时值。可用多个时间窗口对比,例如5分钟平均值、1分钟峰值和10秒突发值。这样既能观察持续攻击,也能识别短时脉冲。
在不改变访问结果的情况下,开启规则的观察或影子模式。重点看三类问题:
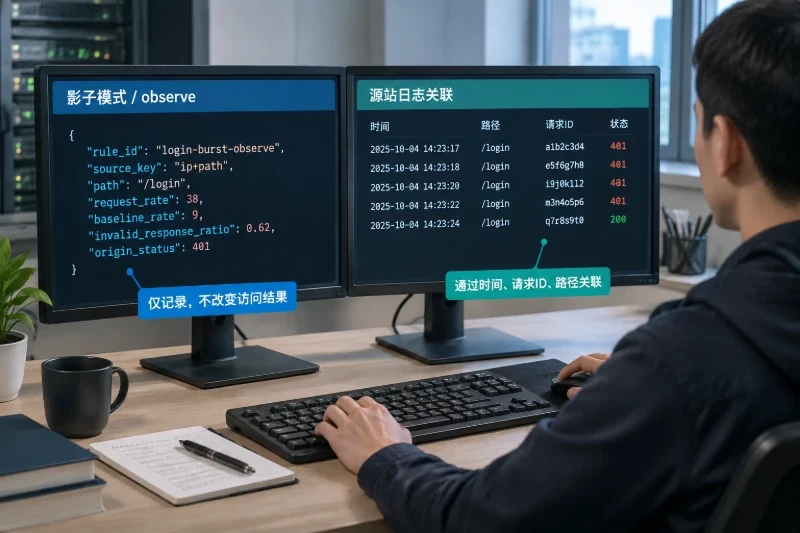
一条合理的观察日志至少应包含这些字段:
{
  "timestamp": "2026-01-15T10:20:30Z",
  "rule_id": "login-burst-observe",
  "source_key": "ip+path",
  "path": "/login",
  "request_rate": 38,
  "baseline_rate": 9,
  "invalid_response_ratio": 0.62,
  "action": "observe",
  "origin_status": 401,
  "decision_reason": [
    "rate_above_baseline",
    "high_invalid_response_ratio"
  ]
}
这里的数值仅用于演示判断过程。验证时要把命中日志与源站日志关联起来:如果清洗层认为请求已拦截,但源站仍然收到同等数量的请求,可能存在旁路、日志统计口径不同或规则仍处于观察模式。
测试应在获得授权的前提下进行,优先选择测试环境、灰度域名或可控接口,避免直接对生产业务制造不可控压力。测试内容不必追求极端流量,重点是覆盖不同的行为模式。
| 测试场景 | 预期判断 | 需要观察的结果 |
|---|---|---|
| 单个客户端短时间访问普通页面 | 不应立即被封禁 | 是否出现误限速 |
| 单个来源重复访问高成本接口 | 应进入限速或观察 | 源站回源量是否下降 |
| 多个来源集中访问同一路径 | 需要触发路径聚合规则 | 单IP低速时是否仍能识别 |
| 正常客户端携带有效会话 | 应保持正常访问 | 成功率和延迟是否变化 |
| API客户端短时合法突发 | 应按Token或客户端规则处理 | 是否被错误挑战 |
| 大量无效Cookie和401响应 | 风险等级应升高 | 规则是否只在组合条件满足时动作 |
| NAT下的多个真实用户 | 不应因为共享IP全部受限 | 单IP规则是否过于粗糙 |
如果系统支持规则版本和灰度比例,可以先让一小部分命中请求执行动作,其余请求仍然只记录。没有灰度能力时,则应先限制单个路径或短时间窗口,并保留立即停用当前规则的入口。
验证“拦截有效”至少要看三组数据,而不是只看清洗平台的封禁数量。
可以使用以下指标帮助量化结果:
源站削减率 = (规则前源站请求量 - 规则后源站请求量)÷ 规则前源站请求量
误拦截率 = 被规则拦截且后续确认合法的请求数 ÷ 被规则拦截请求总数
漏拦率 = 未被规则处理的攻击请求数 ÷ 已标记攻击请求总数
这些指标必须使用相同时间窗口和相近流量条件进行比较。若开启缓存前后口径不同,源站请求量会受缓存命中率影响,不能直接把下降全部归因于七层拦截。
例如,演示一组假设数据:
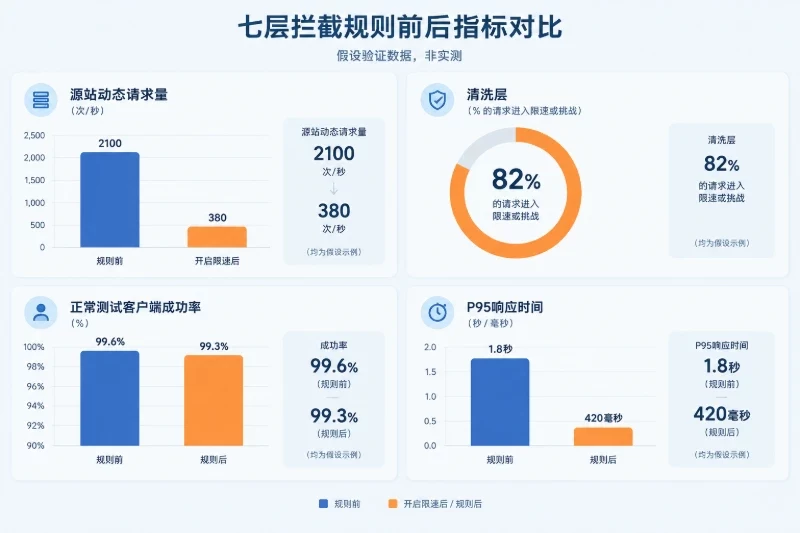
这组数据说明源站压力明显降低,且合法请求变化较小,但仍需继续检查被挑战的客户端是否包含真实API调用方。它不能直接证明某个具体服务器或清洗服务的实际性能,只能说明验证时应如何建立因果关系。
优先检查:
可能是攻击来源分散,或者客户端IP提取错误。此时应增加路径总量、来源数量、会话相似度和状态码比例等聚合维度,而不是简单把单IP阈值不断调低。
常见原因包括:
调整时应先缩小匹配路径或改用更细的统计键,再考虑提高阈值。直接全局放宽规则,可能导致攻击重新进入源站。
这通常说明规则触发太晚、动作只发生在源站之后,或者被保护的指标不是实际瓶颈。应检查源站错误时间、接口耗时、数据库等待和规则动作时间,确认清洗节点是否在源站资源耗尽前完成处理。
七层清洗必须能看到足够的请求信息。如果HTTPS在源站才解密,清洗层只能根据IP、连接和流量速率判断,无法按URL、Cookie或状态码进行细分。需要明确证书由哪里托管、请求在哪一层解密、清洗节点是否记录完整访问日志。
如果存在多级代理,真实客户端地址可能位于代理Header中。只有由可信代理写入、且源站不会直接接受外部伪造的Header,才能把它作为限速依据。否则:
只按IPv4地址设计规则,可能无法覆盖IPv6来源。只按IP封禁,也无法处理共享出口、移动网络和企业NAT。更稳妥的做法是同时保留IP维度和会话、Token、路径聚合维度,并分别观察两类地址的正常基线。
缓存命中可以降低源站压力,但不代表请求本身没有消耗清洗节点资源。相反,带随机参数的请求可能绕过缓存,持续回源。验证时应分别记录边缘请求量、缓存命中量和源站动态请求量,不能只看总带宽。
WebSocket、长轮询或流式接口的连接时间和消息频率与普通短请求不同。若直接套用普通HTTP的每分钟请求阈值,可能把长连接业务误判为异常。此类接口需要单独定义连接时长、消息速率、身份和空闲时间等条件。
七层流量清洗适合识别大量HTTP请求、接口重复调用、异常会话和路径集中访问,但它不是所有攻击的单一解决方式。
以下情况需要特别注意:
如果入口链路、连接表或TLS处理资源已经饱和,请求可能还没有进入HTTP解析阶段,七层规则自然无法及时生效。
攻击者使用有效账号、Token或正常业务流程时,仅靠IP和Header很难区分。还需要应用层的账号配额、接口权限和行为校验。
清洗层看不到路径和会话,只能使用较粗的连接级策略,误判和漏判概率都会上升。
不同接口、不同时间段的正常流量差异很大。一个阈值不能覆盖所有路径,更不能永久沿用而不复核。
爬虫、APP、内部服务和API调用方可能无法完成浏览器挑战。对这些请求应使用Token配额、明确的429响应或独立放行条件。
即使清洗规则判断准确,只要攻击者能够直接连接源站IP,防护效果就会被削弱。验证时必须把流量路径和源站入口一并检查。
一条智能拦截规则至少应满足以下条件:
因此,判断高防香港服务器的七层CC防护是否有效,不能只看“封了多少IP”或“清洗了多少流量”。更可靠的判断链路是:确认流量经过七层入口,建立正常基线,使用影子模式验证命中逻辑,再进行受控对照测试,最后同时比较清洗层、源站和合法业务指标。只有当攻击请求被识别、源站压力下降、合法请求保持可用,并且规则在边界场景下不产生大面积误拦截时,智能拦截配置才具备上线依据。