

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


香港服务器启用 Linux BBR 前,不能只检查内核里是否出现 bbr,还要确认实际业务目的端、跨境 TCP 路径、丢包与时延、MTU、出口带宽、队列规则以及应用协议是否满足测试条件。BBR主要作用于 TCP 拥塞控制,不会自动更换路由,也不能修复跨境链路中的持续丢包、错误 MTU、出口限速或目的端容量不足。
验收时应至少完成四组对照:从香港服务器到实际业务目的端的 IPv4/IPv6 路由检查,使用 ping 和 TCP traceroute 或 mtr 判断链路特征,使用真实业务端口进行基线传输测试,再在相同时间窗口和相同目的端上验证启用后的结果。只有当内核、权限和队列条件正常,且 BBR 新连接能够生效,同时吞吐、重传率和尾部时延没有明显恶化,才适合将配置持久化。
跨境传输效率不能用任意公网地址代替业务链路。应优先选择以下测试对象:
BBR只影响启用它的这台 Linux 主机发起的新 TCP 连接。若应用使用 UDP 或基于 QUIC 的传输,修改 net.ipv4.tcp_congestion_control 不会改变这类连接的拥塞控制。若业务前面还有其他转发层,服务器上的 BBR也不会改变客户端到前置节点之间的传输策略。
因此,记录测试目标时至少保留以下信息:
| 项目 | 需要记录的内容 |
|---|---|
| 目标主机 | 域名、解析到的 IPv4/IPv6 地址 |
| 目标端口 | 例如 443、80 或业务专用 TCP 端口 |
| 测试方向 | 香港服务器下载、上传,还是双向测试 |
| 测试时间 | 开始和结束时间,最好保留多个时间窗口 |
| 网络协议 | IPv4、IPv6、TCP;不要混用结果 |
| 测试文件或接口 | 文件大小、接口路径、是否经过缓存 |
| 服务器出口 | 网卡、源地址、路由表或策略路由 |
启用 BBR通常需要 root 或具备相应 sysctl、内核模块和网络队列操作权限。执行前检查当前身份和运行环境:
id
uname -a
systemd-detect-virt 2>/dev/null || true
ip -br link
ip -br addr
如果香港服务器运行在容器内,容器通常不能自行更换宿主机内核的拥塞控制模块;即使容器内能够读取部分 sysctl,也不代表配置会作用于宿主机网络命名空间。此时应由宿主机或云平台运维人员确认。
变更前保存现有状态,至少包括:
date -Is | tee "$HOME/bbr-check-time.txt"
sysctl net.ipv4.tcp_available_congestion_control \
       net.ipv4.tcp_allowed_congestion_control \
       net.ipv4.tcp_congestion_control \
       net.core.default_qdisc \
       | tee "$HOME/bbr-sysctl-before.txt"

ip route show table all | tee "$HOME/bbr-route-before.txt"
网卡名称不要直接假设为 eth0。应先从 ip route get 的结果中确认实际出口接口,再将下面示例中的
先查看可用拥塞控制算法:
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.ipv4.tcp_allowed_congestion_control
sysctl net.ipv4.tcp_congestion_control
正常情况下,第一条或第二条结果中应能看到 bbr,例如:
net.ipv4.tcp_available_congestion_control = reno cubic bbr
net.ipv4.tcp_allowed_congestion_control = reno cubic bbr
net.ipv4.tcp_congestion_control = cubic
这里的判断方法是:
available 中没有 bbr:当前内核或内核模块没有提供 BBR。available 中有 bbr,但 allowed 中没有:系统策略没有允许该算法。cubic:只是尚未切换,不代表 BBR不可用。bbr:仍要通过新建 TCP 连接和 ss -ti确认实际连接状态。部分发行版将 BBR编译为模块,可以先尝试:
sudo modprobe tcp_bbr
sysctl net.ipv4.tcp_available_congestion_control
如果 modprobe 返回模块不存在,不要随意下载不匹配的内核模块。应按服务器发行版和云平台的内核维护流程升级或更换内核,并重新进行兼容性检查。
BBR会依赖发送端的 pacing 行为。许多 Linux环境会配合 fq 队列使用,但具体可用队列仍取决于内核、发行版和云平台网络实现。检查当前配置:
sysctl net.core.default_qdisc

# 将  替换为实际出口网卡
tc qdisc show dev
常见结果示例:
net.core.default_qdisc = fq
qdisc fq 8001: root refcnt 2 limit 10000p buckets 1024
可按以下方式判断:
qdisc fq:通常具备较清晰的 BBR测试条件。default_qdisc = fq,但网卡仍显示其他队列:默认值不一定已经作用于现有网卡。noqueue、平台定制队列或无法读取:不要直接覆盖,应先确认虚拟化平台限制。fq_codel 等其他队列:不应仅凭队列名称判定 BBR失败,但需要把队列类型记录在基线中,避免前后测试条件不一致。直接替换生产网卡队列可能清空或改变当前发送队列,并影响已有连接。若确需调整,应在维护窗口执行,并先保存原类型、参数和平台回滚方式。示例命令只适用于已确认网卡支持并且允许短暂影响发送队列的环境:
sudo tc qdisc replace dev  root fq
tc qdisc show dev
这不是所有云服务器都适用的通用命令。若当前队列由宿主机托管、网卡为虚拟设备,或业务对瞬时丢包敏感,应先不改队列,只完成 BBR可用性和链路基线检查。
域名可能同时返回 IPv4、IPv6 或多个负载均衡地址。先分别解析并确认实际连接的地址:
getent ahostsv4
getent ahostsv6
再查看每个地址的路由:
ip route get
ip -6 route get
结果中重点关注:
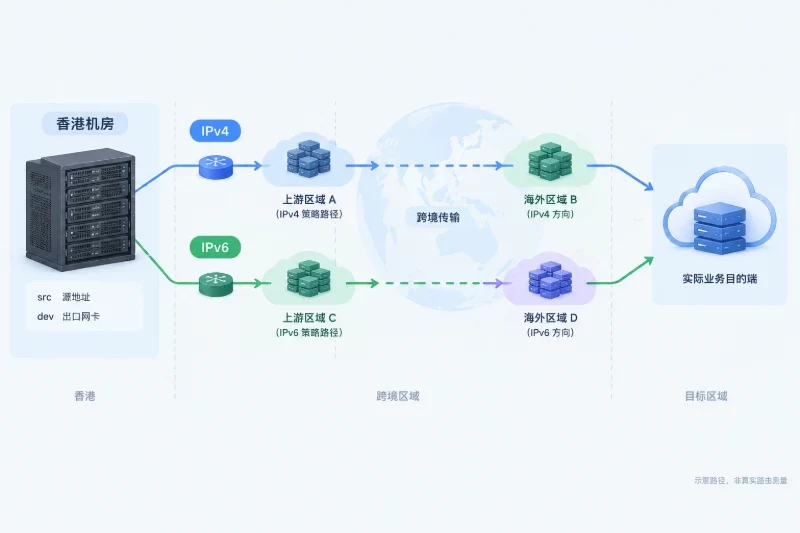
dev:实际出口网卡。src:使用的香港服务器源地址。如果应用解析到多个地址,应在测试记录中写明具体地址。不能把 IPv4 的良好结果直接推断为 IPv6也正常,也不能把一个负载均衡节点的结果推断为所有节点都相同。
ping适合观察 ICMP层面的往返时延、抖动和丢包,但它不能直接证明业务 TCP连接的传输质量。测试时应使用实际目标地址,并避免对不属于自己的公网地址长时间高频探测。
IPv4 示例:
ping -4 -c 100 -i 0.2 -W 2  \
  | tee "$HOME/bbr-ping-ipv4.txt"
IPv6 示例:
ping -6 -c 100 -i 0.2 -W 2  \
  | tee "$HOME/bbr-ping-ipv6.txt"
输出中的 packet loss、min/avg/max/mdev 可以用于初步判断:
max 远高于 avg,通常说明存在排队或突发抖动。参考上,若 100 个探测包出现 0% 丢包且时延分布集中,基础条件较稳定;如果持续超过约 1% 的目标端丢包,或出现连续多个探测包丢失,应先处理链路问题。这个数值只是工程上的参考分界,不能代替业务端 TCP测试。
ping 不能证明以下事项:
因此,ICMP结果只能作为链路初筛,不能作为最终验收依据。
跨境链路经常存在中间设备不响应探测包的情况。使用 TCP 探测时,尽量指定与业务相同的目的端口:
sudo traceroute -n -T -p 443 -q 3 -w 2  \
  | tee "$HOME/bbr-traceroute-tcp.txt"
不同发行版的 traceroute 参数可能略有差异,执行前可以查看:
traceroute --help
如果系统安装了 mtr,可以用报告模式保留多轮结果:
sudo mtr -r -n -c 100 -T -P 443  \
  | tee "$HOME/bbr-mtr-tcp.txt"
查看 TCP traceroute 或 mtr 时,重点不是中间每一跳的单个延迟,而是以下关系:
*,但后续跳和最终目标正常:通常只能说明该跳不回应探测,不能证明业务丢包。traceroute能帮助定位路径变化和可能的时延突增,但不能测出稳定的业务吞吐,也不能单独证明某个中间运营商或设备造成了数据丢失。
错误的路径 MTU可能导致 TCP分段、重传或连接建立后吞吐异常。先使用 tracepath 查看路径发现的 MTU:
tracepath -n | tee "$HOME/bbr-tracepath-ipv4.txt"
如果是 IPv6,可使用:
tracepath6 -n | tee "$HOME/bbr-tracepath-ipv6.txt"
在确认出口链路 MTU为 1500 且使用 IPv4时,可以进行不分片探测:
ping -4 -M do -s 1472 -c 4
这里的 1472 是按 1500 减去 IPv4 头部 20 字节和 ICMP头部 8 字节得到的示例值,不适合直接套用到所有网络。如果失败,可逐步降低载荷,例如测试 1400,再按 8 或 16 字节递增,找出稳定通过的范围。IPv6的头部和探测参数不同,应以 tracepath6 和实际 TCP连接为准。
如果 MTU探测失败,不要立即启用 BBR并把吞吐问题归因于拥塞控制。应先检查:
pmtu 是否低于预期。ICMP可达不代表 TCP端口可用。用实际业务接口做低流量测试:
curl -4 -sS -o /dev/null \
  --connect-timeout 5 \
  --max-time 30 \
  -w 'remote=%{remote_ip} connect=%{time_connect}s start=%{time_starttransfer}s total=%{time_total}s speed=%{speed_download}B/s\n' \
  https:///
如果服务使用 IPv6,应单独测试:
curl -6 -sS -o /dev/null \
  --connect-timeout 5 \
  --max-time 30 \
  -w 'remote=%{remote_ip} connect=%{time_connect}s start=%{time_starttransfer}s total=%{time_total}s speed=%{speed_download}B/s\n' \
  https:///
这个测试可以确认域名解析、TCP握手、TLS建立和应用首字节时间,但健康检查响应通常很小,不能代表大文件传输效率。若端口连接失败,应先确认出口防火墙、目的端访问控制、服务监听状态和返回路径,不要通过切换 BBR来解决端口不可达。
基线必须和启用 BBR后的测试使用相同的目标地址、端口、文件、并发数和时间窗口。建议至少记录:
检查当前 TCP连接详情:
ss -tin dst
示例输出可能类似:
ESTAB 0 0 192.0.2.10:45678 198.51.100.20:443
 cubic wscale:7,7 rto:204 rtt:82.4/6.1 ato:40 mss:1448
 cwnd:32 bytes_sent:524288 bytes_acked:520192 bytes_retrans:4096
以上只是格式示例,不代表实际执行结果。重点关注 cubic 或 bbr、rtt、cwnd、bytes_retrans、pmtu 和 delivery_rate 等字段。不同内核版本显示字段可能不同,不应因缺少某个字段就判断连接失败。
如果有自有测试端点,可以使用 iperf3进行单 TCP流测试。测试端点需由企业自行管理,不要对不属于自己的服务发起大流量测试:
# 在受控的远端测试端点执行
iperf3 -s

# 在香港服务器执行,先使用单连接、短时测试
iperf3 -c  -t 30 -P 1 \
  --logfile "$HOME/bbr-iperf3-before.txt"

# 测试反向传输方向
iperf3 -c  -t 30 -P 1 -R \
  --logfile "$HOME/bbr-iperf3-before-reverse.txt"
-P 1更接近单条 TCP业务流。多并发测试可能掩盖单连接拥塞控制问题,也可能造成较大出口流量和费用。生产环境应限制测试时长,必要时安排业务低峰期。
在已保存状态且有维护窗口的情况下,可以先不持久化配置,只让后续新建的 TCP连接使用 BBR:
sudo modprobe tcp_bbr
sudo sysctl -w net.ipv4.tcp_congestion_control=bbr
sysctl net.ipv4.tcp_congestion_control
预期结果:
net.ipv4.tcp_congestion_control = bbr
如果 sysctl -w 报错,常见原因包括:
bbr不在允许列表中。修改默认拥塞控制不会强制改变已经建立的 TCP连接。应关闭或等待旧连接结束,再重新发起业务请求,然后执行:
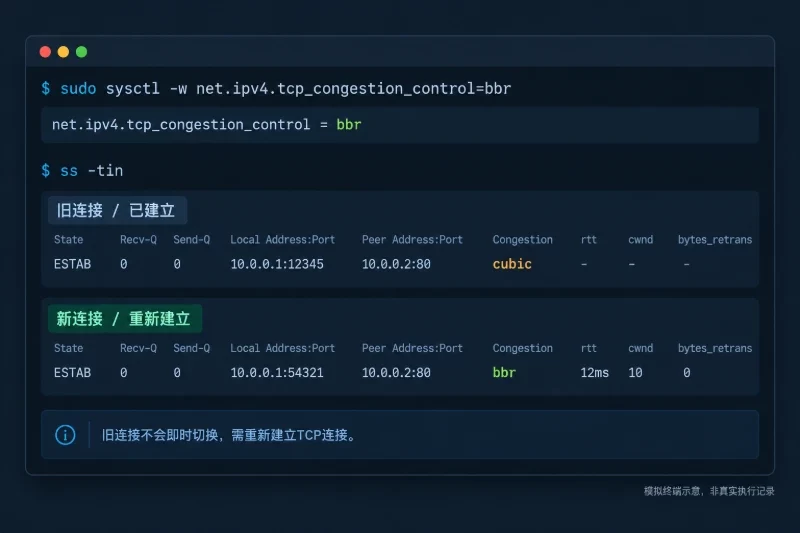
ss -tin dst
新连接中应观察到类似:
bbr wscale:7,7 rto:204 rtt:80.2/5.4 ...
如果系统参数已经是 bbr,但新连接仍显示 cubic,应检查应用是否通过 socket 选项指定了算法、连接是否其实复用了旧的长连接,以及 ss查看的是否为正确目标和网络命名空间。
启用后不要只执行一次下载就下结论。至少重复三轮,最好覆盖一个较稳定时段和一个业务高峰时段。每轮均使用:
结果可按下表记录:
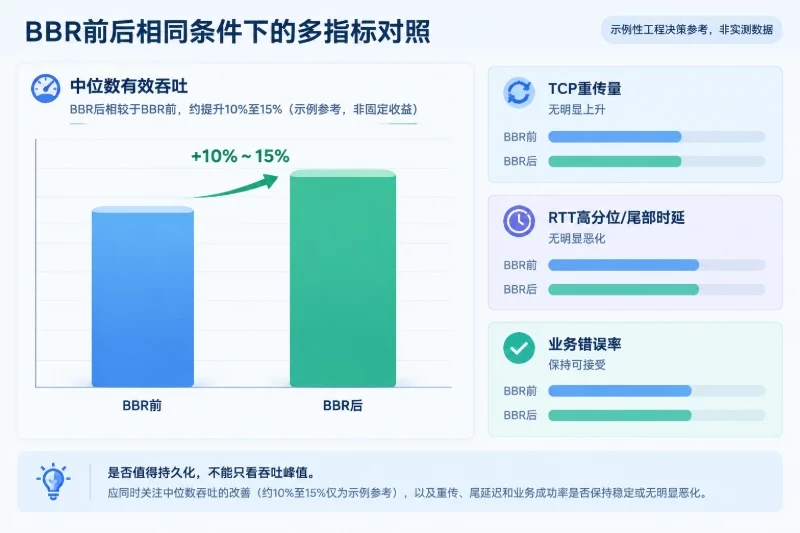
| 指标 | BBR前 | BBR后 | 判断方式 |
|---|---|---|---|
| 单连接有效吞吐 | 记录值 | 记录值 | 看中位数,不看单次峰值 |
| TCP重传量 | 记录值 | 记录值 | 不应出现持续明显上升 |
| RTT平均值 | 记录值 | 记录值 | 观察整体变化 |
| RTT高分位或最大值 | 记录值 | 记录值 | 关注排队和突发抖动 |
| 连接建立时间 | 记录值 | 记录值 | 不应因配置明显变差 |
| pmtu | 记录值 | 记录值 | 前后应保持一致 |
| 业务错误率 | 记录值 | 记录值 | 不能以吞吐换取失败率 |
可以把“中位数吞吐提升约 10%至15%且重传和尾延迟没有明显恶化”作为一个示例性的工程决策参考,但这不是 BBR的固定收益标准。若原链路没有明显拥塞,或瓶颈在目的端限速、服务器磁盘、应用线程或出口带宽,BBR可能几乎没有提升。
适合继续观察的情况包括:
bbr在新 TCP连接中确实生效。不宜直接持久化的情况包括:
ss中仍为 cubic,无法确认 BBR真正作用于业务连接。确认临时测试结果后,再考虑写入 /etc/sysctl.d/。不要覆盖已有的系统调优文件;建议使用独立文件并保存备份:
CONF=/etc/sysctl.d/99-bbr.conf

if [ -e "$CONF" ]; then
  sudo cp -a "$CONF" "$CONF.bak.$(date +%Y%m%d%H%M%S)"
fi

sudo tee "$CONF" >/dev/null <<'EOF'
net.core.default_qdisc=fq
net.ipv4.tcp_congestion_control=bbr
EOF
这段配置的影响范围是系统默认队列和新建 TCP连接,不会把已经建立的连接即时转换为 BBR。net.core.default_qdisc=fq也不一定会重新替换现有网卡的队列,因此仍要用 tc qdisc show dev 复核。
只加载已经确认存在的模块:
sudo modprobe tcp_bbr
sudo sysctl -p "$CONF"

sysctl net.core.default_qdisc
sysctl net.ipv4.tcp_congestion_control
tc qdisc show dev
如果重启后模块没有自动加载,且确认该模块来自当前内核,可以在经过变更审批后建立模块加载文件:
echo tcp_bbr | sudo tee /etc/modules-load.d/tcp_bbr.conf
如果 modprobe tcp_bbr本身失败,不应继续写入模块加载文件。此时应先处理内核兼容性,再进行持久化。
| 现象 | 更可能的原因 | 处理方式 |
|---|---|---|
available中没有 bbr | 内核未编译或模块不匹配 | 按发行版和平台流程更换内核,不强行加载外部模块 |
参数显示 bbr,连接显示 cubic | 连接是旧连接、应用覆盖算法或查看了错误命名空间 | 新建连接并用 ss -tin核对目标 |
| ping有丢包,业务 TCP正常 | ICMP限速或探测路径不同 | 使用业务端口的 TCP探测和传输结果判断 |
traceroute中多跳出现 * | 中间设备不响应探测 | 观察最终目标和后续跳,不按单跳直接判定故障 |
| 最终目标持续丢包 | 真实链路、目标侧或返回路径异常 | 暂停 BBR验收,先处理丢包和路径问题 |
| IPv4正常、IPv6异常 | 两个地址族使用不同路由或上游 | 分开验收,不用IPv4结果替代IPv6结论 |
tracepath显示的 MTU较低 | 路径存在 MTU限制或中间网络封装 | 调整应用和 TCP路径配置,先验证大包与重传 |
| BBR后吞吐不变 | 瓶颈不在 TCP拥塞控制,或链路未拥塞 | 检查目的端、出口限速、磁盘和应用处理能力 |
| BBR后 RTT尾部和重传上升 | 队列规则不匹配、链路拥塞或路径不稳定 | 立即回到基线,对比 qdisc、pmtu和目标端状态 |
| 容器内无法修改参数 | 宿主机控制内核和网络命名空间 | 由宿主机管理员执行,容器内只做连接验证 |
特别要注意,跨境路径的 RTT本身可能较高,高 RTT并不自动意味着 BBR不适用。真正需要关注的是在相同目标、相同时间和相同流量条件下,BBR前后的吞吐、重传、排队时延和业务成功率是否出现一致变化。
上线前可按以下顺序逐项留证:
bbr,并保留 sysctl输出。ping、TCP traceroute或 mtr、tracepath结果。ss -ti中显示为 bbr。如果 BBR后出现重传增加、业务超时、连接失败或尾延迟明显升高,应优先恢复拥塞控制,再处理队列配置。先确认系统允许使用的算法:
sysctl net.ipv4.tcp_available_congestion_control
如果输出中包含 cubic,可将新连接恢复为 cubic:
sudo sysctl -w net.ipv4.tcp_congestion_control=cubic
sysctl net.ipv4.tcp_congestion_control
然后恢复持久化文件。若备份文件只包含本次 BBR配置,可使用事先保存的备份覆盖;如果该文件原本还包含其他参数,应使用编辑器只删除本次新增的两行,避免误删其他系统调优项:
# 仅在确认备份文件对应本次变更前状态时执行
sudo cp -a /etc/sysctl.d/99-bbr.conf.bak. \
  /etc/sysctl.d/99-bbr.conf

sudo sysctl -p /etc/sysctl.d/99-bbr.conf
如果曾经替换过网卡队列,应按照变更前记录恢复原队列类型和参数。没有保存原参数时,不要凭猜测执行覆盖命令,应由平台管理员根据网卡和云主机配置恢复。
回滚后重新建立 TCP连接,再检查:
ss -tin dst
tc qdisc show dev
sysctl net.ipv4.tcp_congestion_control
最终应确认新连接回到原拥塞控制算法,业务端口恢复正常,重传和时延回到 BBR前的基线范围。只有完成“变更前证据、变更后证据、回滚后证据”三组留存,Linux BBR拥塞控制在香港服务器上的跨境传输效率优化才具备可复核的实施基础。


