

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


单看“日志文件里有记录”,不能推出“告警链路一定会触发”。在香港服务器 Rocky Linux 系统上,审计日志、systemd journal、指标采集、日志规则、告警评估和通知发送是多段独立链路;其中任意一段的过滤条件、时间窗口、标签或转发状态不一致,都可能出现“有日志、无告警”。
定位这类问题的入口,是先把业务现象、日志事件、CPU、内存、I/O、网络、响应时间和错误率放进同一个时间窗口,再逐段验证事件是否产生、是否被采集、是否命中规则、是否进入 firing 状态以及是否成功通知。auditd 负责记录内核审计事件,本身不是完整的告警引擎;journald 负责保存服务和系统日志,也不会自动理解业务异常。只有把这些信号正确关联,才能判断是“规则没匹配”,还是“告警已经产生但通知失败”。
一条完整的审计链路通常包含以下层次:
| 层次 | 典型组件或对象 | 主要职责 | 常见断点 |
|---|---|---|---|
| 事件产生 | 内核审计、服务进程、应用、Nginx | 产生文件变更、登录、进程执行、请求和错误事件 | 审计规则没有覆盖目标行为 |
| 本机记录 | auditd、/var/log/audit/audit.log、systemd-journald | 将事件写入本地 | 日志目录未持久化、空间不足、速率限制 |
| 日志采集 | 日志代理、审计插件、远程转发 | 读取并发送日志 | 权限、SELinux、轮转、网络或标签问题 |
| 指标采集 | node_exporter、应用指标端点 | 采集资源和业务指标 | 抓取失败、实例标签变化、采样间隔过长 |
| 规则评估 | 日志查询规则、Prometheus 规则、告警管理器 | 判断是否达到触发条件 | 查询语法、阈值、for 延迟、聚合维度错误 |
| 通知发送 | 邮件、Webhook、值班系统等 | 将告警交付给运维人员 | 路由、静默、抑制、发送失败 |
因此,排查时不能只执行:
sudo grep "关键词" /var/log/audit/audit.log
还要继续确认以下问题:
firing,还是只停留在 pending?在修改配置前,先确认系统版本和相关软件是否存在:
cat /etc/rocky-release
uname -r
rpm -q audit audit-libs systemd chrony rsyslog
systemctl is-active auditd
systemctl is-active systemd-journald
如果某个软件包不存在,不要直接套用其他发行版的路径或服务名。先确认包名、服务状态和实际日志位置:
systemctl list-unit-files | grep -E 'audit|rsyslog|chrony'
sudo find /var/log -maxdepth 2 -type f \( -name '*audit*' -o -name '*secure*' -o -name '*messages*' \) -ls
时间一致性是关联分析的前提。建议服务器和日志平台统一使用 UTC,或者至少明确使用 Asia/Hong_Kong,不要在故障期间随意修改时区。先执行:
timedatectl
date -Is
date -u -Is
chronyc tracking
chronyc sources -v
重点查看:
System clock synchronized 是否为 yes;chronyc tracking 中的系统时间偏差是否持续增大;如果时间没有同步,日志中的“前后顺序”可能是错的。比如审计事件显示在 10:00:03,业务错误显示在 09:59:58,并不一定代表业务错误先发生,也可能只是两台机器的时钟偏差。
建议每次排障都记录四个时间点:
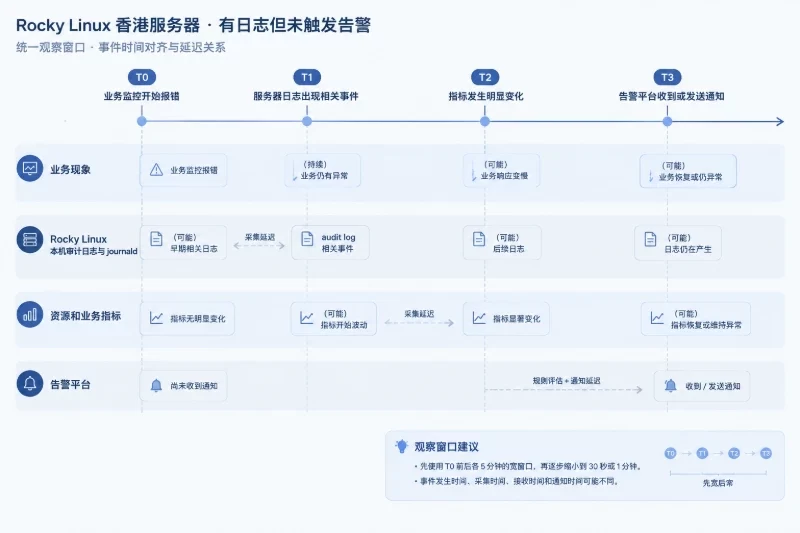
T0:业务监控开始报错的时间;T1:服务器日志中出现相关事件的时间;T2:指标发生明显变化的时间;T3:告警平台收到或发送通知的时间。查询时先使用较宽窗口,例如 T0 前后各 5 分钟,再逐步缩小到 30 秒或 1 分钟。不要一开始只查某一个时间点,否则容易漏掉采集延迟和规则评估周期。
关联键优先级通常如下:
msg=audit(epoch:serial)、UID、AUID、PID;审计日志中的多个记录可能属于同一个审计事件。例如一个用户执行命令,可能同时产生 SYSCALL、EXECVE、PATH 和 PROCTITLE 等记录。不能简单按日志行数判断事件数量,否则可能把一次行为误算成多次告警。
部分系统配置下,journald 可能只保存在内存目录,重启后无法查询历史日志。可以先查看当前状态:
journalctl --disk-usage
findmnt /var/log
sudo ls -ld /var/log/journal
如果需要让系统日志持久化,可以创建独立的 drop-in 配置。以下容量和保留时间只是示例,应结合磁盘余量调整:
sudo mkdir -p /etc/systemd/journald.conf.d
sudo tee /etc/systemd/journald.conf.d/10-persistent.conf > /dev/null <<'EOF'
[Journal]
Storage=persistent
SystemMaxUse=1G
MaxRetentionSec=14day
EOF
应用前先备份配置,并在维护窗口内刷新:
sudo cp -a /etc/systemd/journald.conf \
  /etc/systemd/journald.conf.bak.$(date +%F-%H%M%S)

sudo systemctl restart systemd-journald
sudo journalctl --flush
sudo journalctl --disk-usage
验证服务日志是否可查询:
sudo journalctl --since "10 minutes ago" -o short-iso-precise
sudo journalctl -u auditd --since "10 minutes ago" -o short-iso-precise
这项修改会影响本机日志写入方式,但不会自动解决远程日志告警问题。若重启 systemd-journald 后出现写入异常,应先删除新增的 drop-in 文件并恢复原配置:
sudo rm -f /etc/systemd/journald.conf.d/10-persistent.conf
sudo systemctl restart systemd-journald
先查看审计服务、规则和丢失计数:
sudo systemctl status auditd --no-pager
sudo auditctl -s
sudo auditctl -l
auditctl -s 中需要重点关注:
enabled:审计是否启用;pid:审计进程是否正常;backlog:当前待处理事件数量;lost:是否已经丢失审计事件;backlog_limit:待处理队列上限。如果 lost 持续增加,先处理磁盘、CPU、审计规则过宽或队列积压问题,不要急着修改告警阈值。告警系统无法恢复已经丢失的源事件。
查询近期审计事件:
sudo ausearch -ts recent -i
sudo ausearch -m USER_LOGIN,USER_START -ts recent -i
sudo ausearch -k ssh_config -ts today -i
如果 ausearch 能查到事件,而远程日志平台查不到,问题通常位于采集或转发环节;如果本机也没有,才需要检查审计规则是否覆盖了目标行为。
Rocky Linux 通常通过 /etc/audit/rules.d/*.rules 管理持久化规则。先查看现有规则,避免与已有规则重复:
sudo ls -l /etc/audit/rules.d
sudo auditctl -l
下面是一组用于示例环境的规则,分别记录普通用户执行程序、SSH 配置变化和特权配置变化:
sudo tee /etc/audit/rules.d/50-observe-chain.rules > /dev/null <<'EOF'
-a always,exit -F arch=b64 -S execve -F auid>=1000 -F auid!=unset -k user_exec
-w /etc/ssh/sshd_config -p wa -k ssh_config
-w /etc/sudoers -p wa -k privilege_config
-w /etc/sudoers.d -p wa -k privilege_config
EOF
这组规则只适合作为参考,原因包括:
execve 事件量可能很大,短时间内会增加日志和采集压力;b64 时,不一定覆盖系统中实际运行的其他架构程序;加载前先检查规则语法:
sudo augenrules --check
sudo augenrules --load
sudo auditctl -l
sudo auditctl -s
不要在生产服务器上直接执行 auditctl -D 清空全部规则,尤其不要在远程连接下操作。它可能造成完整的审计空档,也可能删除原有安全规则。如果需要回滚,只删除自己创建的规则文件,恢复备份后重新加载,并再次核对:
sudo cp -a /etc/audit/rules.d/50-observe-chain.rules \
  /etc/audit/rules.d/50-observe-chain.rules.bak.$(date +%F-%H%M%S)

sudo rm -f /etc/audit/rules.d/50-observe-chain.rules
sudo augenrules --load
sudo auditctl -l
本地存在日志,不代表告警平台能够读取它。常见的传输方式有:
/var/log/audit/audit.log;auditd 的审计插件将事件转给 syslog,再由 rsyslog 转发;如果使用审计插件,先确认当前系统是否安装并启用了对应插件,不要依据其他系统的路径直接创建配置:
sudo find /etc/audit -maxdepth 3 -type f -print
sudo grep -R "builtin_syslog\|active" /etc/audit/plugins.d 2>/dev/null
某些 Rocky Linux 安装环境中会提供类似下面的插件配置:
active = yes
direction = out
path = builtin_syslog
type = builtin
args = LOG_INFO
format = string
只有在本机已存在对应插件、并确认审计版本支持时,才按当前系统的文件结构启用。修改前备份文件,修改后检查审计服务日志和 syslog 是否出现事件。远程转发应使用经过认证和加密的传输方式,目标地址、证书和接收端配置需要按实际日志平台填写,不能把示例地址直接用于生产。
转发验证不要只看“配置文件没有报错”,而要使用唯一标识进行端到端测试:
logger -t chain-test "token=audit-chain-$(date +%s) host=$(hostname -s)"
sudo journalctl -t chain-test --since "2 minutes ago" -o short-iso-precise
然后在日志平台中搜索同一个 token,分别记录:
如果本机有记录、采集端没有,检查采集器进程、文件权限、SELinux 拒绝、日志轮转和网络连接;如果采集端有记录但规则没有命中,重点检查解析字段、标签和查询语法。
业务侧通常能提供最明确的 T0,例如:
然后同时查看以下指标:
| 指标 | 建议观察内容 | 对判断的帮助 |
|---|---|---|
| CPU | 使用率、iowait、load、运行队列 | 区分计算饱和与等待 I/O |
| 内存 | MemAvailable、swap、major page fault | 判断内存压力和回收影响 |
| 磁盘 I/O | await、util、读写吞吐、队列深度 | 判断日志写入或业务存储是否阻塞 |
| 网络 | 收发速率、丢包、错误、连接状态 | 区分应用错误和传输异常 |
| 应用 | p50/p95/p99、5xx、超时、队列 | 判断用户影响和服务内部状态 |
| 日志 | 事件数量、字段、采集延迟、丢失数 | 判断事件是否真实到达规则层 |
例如使用 node_exporter 时,可以用下面的 PromQL 作为方向性查询。指标名称和标签要以实际采集结果为准:
1 - avg by (instance) (
  rate(node_cpu_seconds_total{mode="idle"}[5m])
)
node_memory_MemAvailable_bytes
/
node_memory_MemTotal_bytes
rate(node_disk_io_time_seconds_total[5m])
rate(node_network_receive_bytes_total[5m]) * 8 / 1000000
最后一个表达式将每秒字节数乘以 8 转成 bit,再除以 1,000,000,结果近似为十进制 Mbps。不要把 MB/s 直接当成 Mbps,也不要混用 GB、GiB 和十进制数据量。
如果本机未安装 iostat,可以先确认 sysstat 包是否存在。安装软件包会改变系统软件环境,应先确认仓库可用并安排变更窗口:
rpm -q sysstat
command -v iostat
采集现场数据时:
iostat -xz 1 5
vmstat 1 5
ss -s
ss -tan state syn-recv
这些命令用于观察,不会主动制造负载。不要为了验证告警而直接执行大规模磁盘写入、删除日志或人为压满内存。
下面是一组模拟数据,用于说明判断方式,不代表某台服务器的实测结果:
| 时间 | 5xx | p95 | CPU | iowait | 磁盘 await | 审计日志 |
|---|---|---|---|---|---|---|
| 10:00:00 | 0.3% | 180 ms | 52% | 2% | 6 ms | 正常 |
| 10:01:00 | 1.1% | 320 ms | 61% | 9% | 24 ms | 出现配置变更事件 |
| 10:02:00 | 5.8% | 860 ms | 69% | 27% | 78 ms | 事件量增加 |
| 10:03:00 | 7.2% | 1,050 ms | 71% | 31% | 96 ms | 采集正常 |
如果只看 CPU,69% 并不一定达到常见的 80% 或 90% 阈值,可能会误判“CPU 没问题”。但将 iowait、磁盘等待、响应时间和错误率放入同一时间轴后,更合理的候选是存储等待或日志写入压力导致请求排队。此时应继续查看磁盘队列、具体设备、进程 I/O 和应用超时,而不是立即扩容 CPU。
反过来,如果出现如下组合:
sudo 或配置文件访问;那么这条日志只能证明某个审计事件发生,不能证明它造成了业务故障。应将它作为独立安全事件处理,而不是强行与业务告警绑定。
先查规则是否存在:
sudo auditctl -l | grep -E 'ssh_config|privilege_config|user_exec'
再用明确的审计键查询:
sudo ausearch -k ssh_config -ts today -i
sudo ausearch -k privilege_config -ts today -i
如果文件中有相关文字,但 ausearch 查不到对应 key,说明可能是:
此时不能通过降低告警阈值解决,应该先修正事件源和规则匹配。
审计原始记录可能包含:
type=SYSCALL msg=audit(1710000000.123:456): arch=c000003e syscall=59 success=yes ...
type=EXECVE msg=audit(1710000000.123:456): argc=2 a0="sudo" a1="..."
日志平台解析后,字段可能变成 type、audit.serial、exe、uid 或自定义标签。规则如果查询了不存在的字段,就会出现“原始日志可见、查询无结果”。
排查时先用唯一 token 或完整事件 ID搜索原文,再查看平台实际解析结果。不要想当然地使用 message、event_type、host 等字段名。
for 条件导致延迟监控规则通常不是日志一到达就立刻通知。一次告警的延迟可能来自:
for: 5m 等持续时间条件;例如表达式在 10:00:10 首次满足,但规则要求连续满足 5 分钟,最早也要到 10:05 左右进入 firing。如果 10:03 恢复正常,告警可能始终不会触发。
因此,排查时要同时查看表达式当前值、规则状态和历史状态,区分:
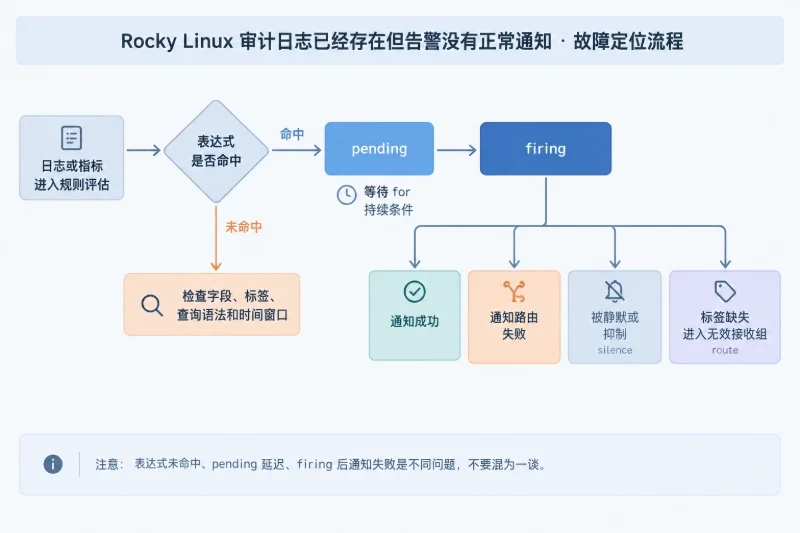
pending;firing,但通知路由失败;在 Rocky Linux 服务器上,重点检查:
sudo journalctl -u auditd --since "30 minutes ago" --no-pager
sudo auditctl -s
sudo journalctl --verify
sudo journalctl --disk-usage
df -h /var/log
df -i /var/log
如果 lost 增加、日志目录空间不足、采集器频繁重启,规则不触发可能是因为规则根本没有收到事件。
日志转发到外部平台时,还要检查香港服务器到采集端的连接状态。网络延迟本身通常只会造成告警延后,但连接中断、队列溢出或发送端不持久化时,可能造成事件丢失。要优先查看采集器自身日志和本地缓冲,而不是只检查业务端口。
如果平台查询已经能看到事件,且规则状态为 firing,问题就不在 Rocky Linux 本机。继续检查:
告警规则应保留“源事件告警”和“关联告警”两类。不要让日志采集失败直接压制所有指标告警,否则日志系统出问题时,业务故障也可能同时失去通知。
高价值、低频率的审计事件适合单独告警,例如:
sudoers 或 sudoers.d 发生变化;CPU、内存、磁盘、网络和业务错误则使用独立指标告警。两者可以在展示层和事件分析层关联,但不宜互相作为唯一触发条件。
一个更稳妥的结构是:
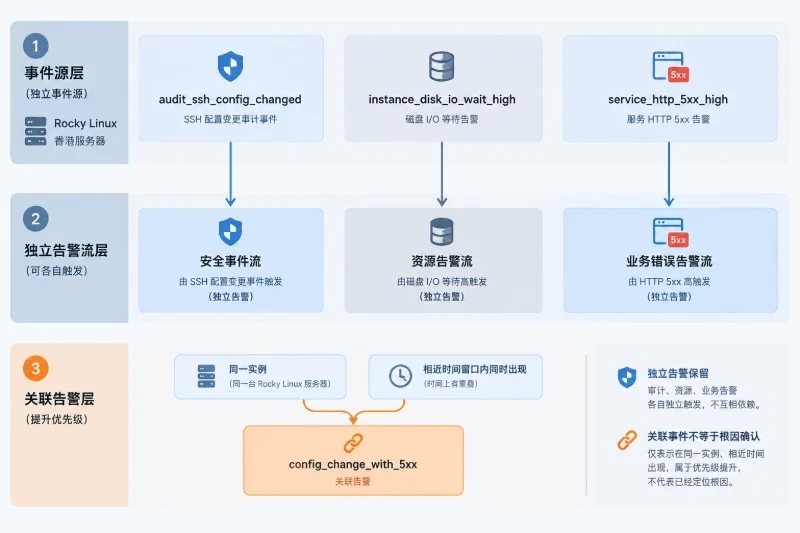
audit_ssh_config_changed:审计事件到达即进入安全事件流;instance_disk_io_wait_high:I/O 等待连续超过设定时间;service_http_5xx_high:业务错误率连续超过设定时间;config_change_with_5xx:同一实例、相近时间窗口内两类事件同时出现时,提升优先级。这样,即使日志采集暂时中断,业务指标仍能独立发出故障告警;即使业务暂时没有异常,配置变更也不会因为没有性能指标而被忽略。
“配置变更后出现 5xx”只能说明时间上接近,不能单独证明因果关系。形成较强判断至少需要同时满足:
如果只能满足时间接近,应在告警内容中使用“关联事件”或“疑似相关”,不要直接写成“根因已确认”。
复测分为三层,不建议直接制造高负载:
第一层:本地日志复测
token="chain-test-$(date +%s)"
logger -t chain-test "token=${token} host=$(hostname -s)"
sudo journalctl -t chain-test --since "2 minutes ago" -o short-iso-precise
确认日志本地生成、查询和时间戳正常。
第二层:审计规则复测
如果需要验证自定义审计规则,可选择事先准备的测试文件,不要直接修改生产配置:
sudo install -m 0600 /dev/null /tmp/audit-chain-test
sudo auditctl -w /tmp/audit-chain-test -p wa -k chain_test
sudo touch /tmp/audit-chain-test
sudo ausearch -k chain_test -ts recent -i
测试结束后删除临时规则和文件:
sudo auditctl -W /tmp/audit-chain-test -p wa -k chain_test
sudo rm -f /tmp/audit-chain-test
上述操作需要 root 权限,会改变临时审计规则并创建、删除测试文件,只应在确认路径安全、不会与现有规则冲突的前提下执行。如果 auditctl -W 未按预期删除规则,应先用 auditctl -l 核对实际规则,再通过持久化规则文件统一清理,避免留下重复规则。
第三层:告警链路复测
在告警平台中使用测试标签、测试规则或平台提供的测试入口,依次确认:
如果平台没有测试入口,优先使用唯一日志 token 验证,不要通过删除日志、关闭审计服务或压满磁盘来制造告警。
这通常表示审计事件与业务请求没有因果关系,或者该行为本身属于正常运维操作。需要结合 UID、AUID、命令、进程、目标文件和业务请求 ID继续判断,不能仅凭日志关键词升级为业务故障。
应重点查看 iowait、磁盘 await、网络连接队列、上游响应时间和应用线程池。CPU 使用率低可能是线程在等待磁盘、网络或锁,并不代表服务器没有资源瓶颈。
指标系统和日志系统是两条独立链路。先确认业务指标规则和日志规则是否使用同一个实例标签;如果指标已进入 firing,而日志查询为空,不能据此认为业务没有异常。
可能是单次配置变更、人工操作、探测请求或低频安全事件。此类告警仍然有价值,但应设置不同的优先级和通知策略,不要与用户可感知的业务中断使用同一严重等级。
日志量增加既可能代表攻击或异常,也可能是审计规则过宽、服务进入重试循环、日志级别被临时调高或采集重复。应同时检查 auditctl -s 的 lost、磁盘写入、应用错误率和采集器吞吐,不能把日志条数直接等同于风险等级。
建议为每次故障或配置变更建立一张固定观察表,在同一时间轴记录:
| 时间窗口 | 日志事件 | CPU/内存 | I/O/队列 | 网络 | 响应时间/错误率 | 告警状态 |
|---|---|---|---|---|---|---|
| T0 前 5 分钟 | 基线事件量 | 基线水平 | 基线等待 | 基线连接 | 基线延迟 | inactive |
| T0 附近 | 审计 key、服务错误、请求 ID | 使用率、iowait、可用内存 | await、util、队列 | 丢包、连接数、错误 | p95、5xx、超时 | pending 或 firing |
| T0 后 5 分钟 | 采集延迟、重复或丢失 | 是否恢复 | 是否仍积压 | 是否恢复 | 是否恢复 | 通知及恢复时间 |
最有价值的组合通常不是某一个阈值,而是“同一实例 + 同一时间窗口 + 同一业务现象”下的多项证据:审计事件确认发生了什么,日志确认服务看到了什么,指标说明资源是否承压,链路或请求 ID说明影响经过哪里,业务错误率说明用户是否真的受到影响,告警状态则说明哪一段自动化链路没有继续向前传递。这样才能把“系统日志有记录却未触发告警”从表面现象拆解成可验证、可复测的具体故障点。


