

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


入门级站点读写变慢时,不能只看“磁盘利用率是否达到100%”,也不能用一次测速结果直接下结论。对配480GB SATA SSD的香港服务器,更可靠的判断方式是把页面响应时间、磁盘等待时间、I/O队列、读写负载放在同一个时间窗口内观察,并同时排除CPU、内存和网络因素。如果慢请求出现时,磁盘 await 和队列长度同步升高,磁盘忙碌度持续接近上限,且这种现象可以重复出现,磁盘大概率就是瓶颈。
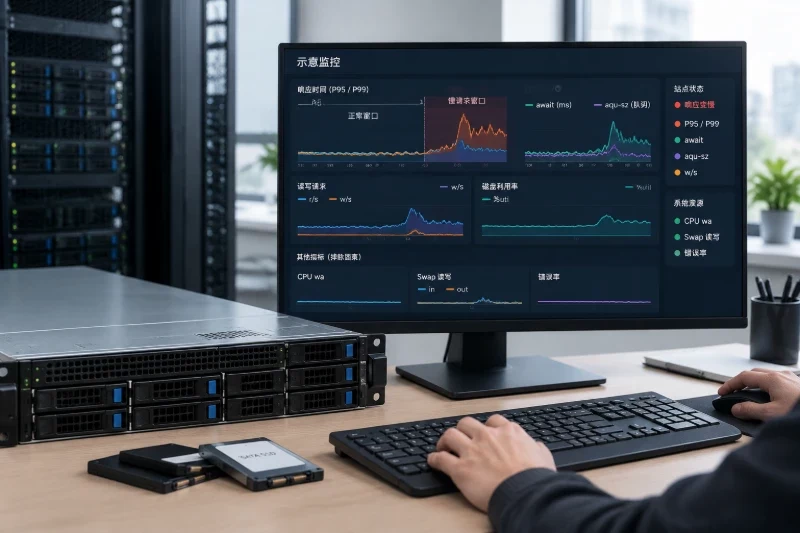
480GB代表的是容量,不代表固定的读写性能。常规站点中的小文件读取、数据库随机读写、日志追加和缓存回写,通常比连续读写更能反映真实体验。因此,判断这类服务器是否够用,应优先关注请求延迟和I/O等待,而不是只比较某个连续读写速度数字。
访问者看到的页面变慢,可能发生在多个环节:
可以把一次请求的总耗时粗略理解为:
请求耗时 ≈ 应用处理时间 + 等待数据的时间 + 网络传输时间
磁盘只是其中一部分。网页平均响应时间升高,并不能单独证明磁盘存在瓶颈;同样,磁盘吞吐量不高,也不能证明磁盘没有问题。很多站点的瓶颈来自大量4KB或8KB随机读写,此时总吞吐量可能只有几MB/s,但请求已经在I/O队列中等待。
判断时建议优先看以下三组信号:
await、队列长度、读写IOPS、读写吞吐量、磁盘忙碌度;其中,P95和P99比平均值更重要。平均值可能只有200毫秒,但如果少数请求需要3秒,用户仍然会明显感到站点卡顿。
不要只在站点已经变慢时临时执行一次命令。更有效的方式是建立两个可比较的时间窗口:
每个窗口至少记录5到15分钟。若问题具有明显的高峰特征,可以进一步记录30分钟或按小时汇总。重点不是采集越多数据越好,而是确保各指标的时间范围一致。
建议至少保留以下信息:
| 观察对象 | 需要记录的内容 | 用途 |
|---|---|---|
| 站点请求 | 平均值、P95、P99、超时数、5xx错误数 | 确认用户体验是否真的恶化 |
| 磁盘设备 | r/s、w/s、rkB/s、wkB/s、await、队列长度、%util | 判断是否出现I/O排队 |
| CPU | user、system、iowait、load或运行队列 | 区分计算繁忙与等待磁盘 |
| 内存 | 可用内存、swap读写、回收压力 | 排除内存不足引起的额外I/O |
| 空间 | 文件系统使用率、inode使用率 | 排除空间或inode耗尽 |
| 错误 | 应用超时、内核I/O错误、文件系统报错 | 判断是否存在异常而非单纯性能不足 |
如果只能先采集一组数据,优先保证“请求延迟 + 磁盘 await/队列 + CPU iowait”三者处于同一时间段。
站点是否真的受影响,要以实际请求表现为入口。可以重点观察:
如果只有后台保存、数据库更新或日志写入变慢,而静态页面基本正常,写入等待可能是重要线索。如果静态文件读取、动态页面加载和后台保存同时变慢,则需要进一步观察是否存在整体I/O排队、内存压力或底层设备异常。
不要只看平均响应时间。例如:
| 指标 | 正常窗口示例 | 异常窗口示例 |
|---|---|---|
| 平均响应时间 | 120 ms | 260 ms |
| P95响应时间 | 220 ms | 920 ms |
| P99响应时间 | 480 ms | 2.8 s |
| 5xx错误率 | 0.1% | 0.2% |
| 磁盘写入请求 | 较少 | 集中增加 |
这组数据只能说明异常窗口的尾部延迟明显恶化,不能单独说明原因。还要看同一时间磁盘是否出现等待增加。
await 和队列判断I/O是否排队在Linux服务器上,iostat 是观察块设备I/O的常用工具。若系统已安装 sysstat,可以执行:
date
findmnt -no SOURCE,FSTYPE,TARGET /
lsblk -o NAME,TYPE,SIZE,FSTYPE,MOUNTPOINTS
iostat -xz 1 10
这些命令只读取状态,不会修改文件。findmnt和lsblk用于确认实际文件系统对应的设备,不要仅凭设备名称推断底层介质。
重点关注以下字段:
r/s:每秒读请求数;w/s:每秒写请求数;rkB/s:每秒读取数据量;wkB/s:每秒写入数据量;await:I/O请求从提交到完成的平均等待时间,通常包含排队和设备处理时间;aqu-sz:平均I/O队列长度;%util:设备处于处理I/O状态的时间比例。await比单纯吞吐量更接近用户感受对常规站点而言,短时间的连续读写速度并不能直接代表页面响应。一个典型的异常变化可能是:
await 为2到8毫秒;aqu-sz 从接近0升高到持续大于1;这类联动比“磁盘吞吐量达到多少MB/s”更有判断价值。
不过,不能把某个数字当成所有服务器的硬阈值。虚拟化环境、文件系统、I/O调度方式、读写比例和并发量都会影响结果。可以把以下范围作为复核信号,而不是最终结论:
| 指标变化 | 参考含义 |
|---|---|
await持续低于约10毫秒,队列接近0 | 轻负载下通常没有明显I/O排队 |
await持续达到20至30毫秒以上 | 应结合请求延迟和队列继续检查 |
await升高但吞吐量很低 | 可能是小块随机I/O、同步写入或底层排队 |
aqu-sz从接近0持续升高 | 说明请求到达速度暂时超过处理速度 |
%util达到80%至90%以上且await同步升高 | 磁盘承压的可信度较高 |
%util接近100%但await和请求延迟没有变化 | 不能仅凭此项认定站点被磁盘拖慢 |
%util接近100%并不总是等于故障。对于某些设备或较高并发场景,设备可能长期处于忙碌状态,但请求仍能快速完成。只有当忙碌度、等待时间、队列和应用延迟同时恶化时,判断才更可靠。
观察 r/s、w/s 和对应的吞吐量,可以进一步判断问题类型:
w/s明显增加,同时await升高,常见于日志、数据库提交、缓存回写或批量保存;r/s明显增加,同时队列变长,可能与缓存命中率下降、数据集变大或随机读取增加有关;rkB/s、wkB/s不高,但await很高,通常不像连续带宽不足,更像大量小块I/O排队;await稳定、页面延迟没有变化,可能只是正常的连续读写,不一定是当前瓶颈。因此,不能看到“每秒只有几十MB读写”就判断480GB SATA SSD性能不够。对于随机读写,低吞吐量也可能对应较高的请求等待。
磁盘指标必须放在CPU和内存的上下文中看。可以同时执行:
vmstat 1 10
free -m
vmstat中的重点字段包括:
r:等待运行的任务数量;si、so:交换区读入和写出;bi、bo:块设备读入和写出;us、sy:用户态和内核态CPU使用;wa:等待I/O的CPU时间比例。常见的几种组合如下。
await和aqu-sz持续升高;%util明显变高;wa随之增加;us和sy没有达到饱和;这时磁盘I/O排队与站点变慢存在较强关联。
us或sy长期接近CPU处理能力上限;r持续高于可用处理能力;await和队列基本正常;wa并不高。这种情况下,即使磁盘有读写活动,也未必是拖慢请求的主要因素。
si、so出现持续变化;await随之升高,但根因是内存不足引起的换页。如果先处理磁盘而不处理内存压力,问题可能很快重复出现。此时应把交换读写、内存回收和磁盘I/O放在同一时间线上判断。
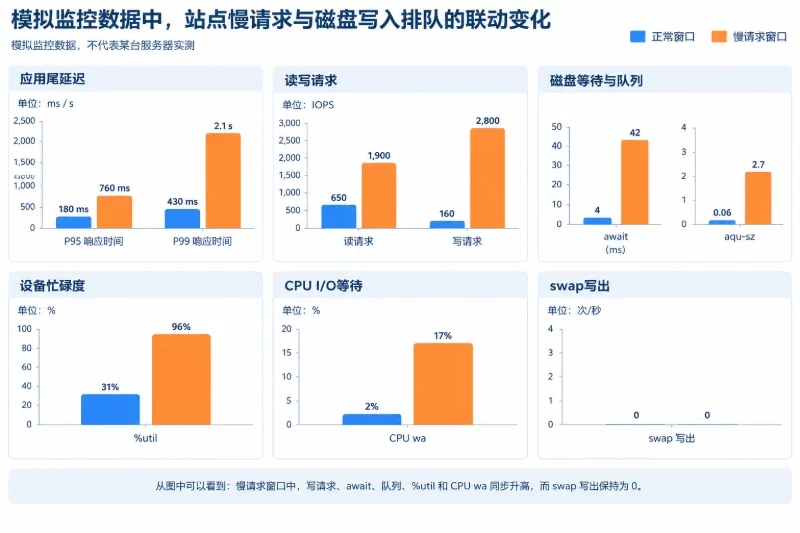
下面是一组用于说明方法的模拟监控数据,不代表某台具体服务器的实测结果:
| 指标 | 正常窗口 | 慢请求窗口 |
|---|---|---|
| P95响应时间 | 180 ms | 760 ms |
| P99响应时间 | 430 ms | 2.1 s |
| 读请求 | 650 IOPS | 1,900 IOPS |
| 写请求 | 160 IOPS | 2,800 IOPS |
await | 4 ms | 42 ms |
aqu-sz | 0.06 | 2.7 |
%util | 31% | 96% |
CPU wa | 2% | 17% |
| swap写出 | 0 | 0 |
| 5xx错误率 | 0.1% | 0.1% |
这组数据中,异常窗口的写请求显著增加,磁盘等待、队列、忙碌度和CPU I/O等待同时上升,应用尾延迟也在同一时间恶化。由于没有明显swap写出,CPU计算也没有显示出饱和,磁盘写入排队很可能是主要瓶颈。
但如果数据变成下面这样:
| 指标 | 正常窗口 | 慢请求窗口 |
|---|---|---|
| P95响应时间 | 180 ms | 760 ms |
await | 4 ms | 5 ms |
aqu-sz | 0.06 | 0.08 |
%util | 31% | 35% |
CPU us | 42% | 94% |
CPU wa | 2% | 3% |
此时站点确实变慢,但磁盘指标几乎没有同步变化,CPU更值得优先检查。若网络连接错误或上游响应时间同时增加,则还应从网络和外部依赖方向核对,而不是直接更换磁盘。
480GB是标称容量,系统中显示的可用空间会受到GB与GiB换算、分区、文件系统保留空间和已有数据的影响。容量不足本身不等于当前I/O瓶颈,但会导致写入失败、日志异常、数据库提交失败,甚至间接形成更高延迟。
检查空间和inode:
df -hT
df -i
建议重点关注:
80%至85%只能作为提前复核的参考线,不是所有文件系统都适用的硬性性能阈值。对于经常写入数据库、日志或缓存的站点,应尽量保留持续写入所需的空间余量。接近满盘时,SSD内部垃圾回收和写入放大也可能使持续写入表现变差,但具体影响取决于设备和工作负载,不能仅凭容量百分比精确推算。
如发现内核或文件系统错误,可在不修改系统的前提下查看最近记录:
journalctl -k -n 100 --no-pager
如果系统没有该命令,也可以在具备权限时查看:
dmesg -T | grep -Ei 'I/O error|read-only|filesystem|reset|error'
出现I/O error、文件系统被切换为只读、设备重置等信息时,问题就不再只是“常规性能不足”。应先保留日志、检查备份可恢复性,并避免继续进行高强度写入;不要通过反复测速掩盖潜在的设备或文件系统故障。
生产监控可以判断“业务变慢时磁盘是否承压”,但不能完全说明设备在不同队列深度下的能力。如果必须进一步测试,应将其安排在维护窗口,并满足以下条件:
例如,在已安装 fio 的Linux系统中,可以对独立的临时文件进行短时间混合读写测试:
fio --name=site-disk-check \
  --filename=/var/tmp/site-disk-check.bin \
  --size=1G \
  --rw=randrw \
  --rwmixread=70 \
  --bs=4k \
  --iodepth=1 \
  --direct=1 \
  --runtime=60 \
  --time_based \
  --group_reporting
这个示例使用1GB测试文件、4KB随机混合读写和较低队列深度,目的是观察延迟,而不是制造最大吞吐量。测试期间应同步观察:
iostat中的await和%util是否异常升高。测试完成后,确认路径完全是测试文件且没有其他程序使用,再删除该文件。删除命令具有不可逆风险,不能把路径改成根目录、数据库目录或业务目录:
rm -f -- /var/tmp/site-disk-check.bin
如果不确定系统是否支持该命令、测试文件是否确实创建在目标路径,先用下面的命令核对:
ls -lh /var/tmp/site-disk-check.bin
基准测试结果不能直接等同于站点实际性能。测试文件可能受到文件系统、缓存、并发量和测试参数影响;而且测试时业务通常处于低负载状态。因此,测试结果应与真实慢请求期间的监控数据结合使用。
可以用下面的条件化标准做初步归类:
| 观察结果 | 更合理的判断 |
|---|---|
请求P95/P99升高,await、队列和%util同步升高,重复出现 | 磁盘很可能是主要瓶颈 |
| 磁盘等待升高,但应用响应没有明显变化 | 磁盘正在承压,但暂时不是用户体验瓶颈 |
| 请求变慢,磁盘指标稳定,CPU使用率明显升高 | 优先检查CPU或进程排队 |
| 请求变慢,磁盘和swap读写同时升高 | 先排查内存压力,再判断磁盘影响 |
%util接近100%,但await、队列和请求延迟稳定 | 不能单凭忙碌度认定磁盘不足 |
吞吐量不高、await很高、队列持续增加 | 更像小块随机I/O或同步写入排队 |
| 磁盘指标正常,但网络错误、连接等待或外部响应变慢 | 不应把问题归因于本地磁盘 |
| 文件系统接近满盘并伴随写入失败 | 属于容量或文件系统风险,应先处理空间和数据安全 |
对于入门级站点,通常不需要追求一个抽象的“最高读写速度”。更实际的标准是:在正常业务读写量下,磁盘等待是否稳定,站点P95/P99是否可接受,写入高峰期间是否出现持续排队,以及异常是否能够在多个时间窗口中复现。
这类配置适合通过请求延迟和I/O联动来判断,但仍有几个边界需要注意:
480GB只说明存储空间量级,不能根据容量直接推算随机读写能力。
动态站点更常见的是小块随机读取、同步写入和混合读写,连续读写测速只能作为补充。
几秒钟内的写入成绩可能较好,持续写入后才出现等待增加,因此应观察至少几十秒,并与生产监控结合。
await和%util反映的是系统可见的块设备行为,不一定能完整展示底层宿主机情况。若业务延迟与这些指标无法对应,应同时观察应用、CPU、内存和网络。
站点访问量较低时,即使磁盘性能一般,也可能没有明显排队。此时不能用“没有达到100%利用率”证明长期增长后仍然足够。
图片、日志、数据库、缓存和备份对磁盘的访问方式不同。站点从以读取为主变成频繁写入后,原来的基线可能不再适用。
最实用的记录组合是:请求P95/P99和错误率、磁盘await与aqu-sz、r/s和w/s、%util、CPU wa、内存swap读写、文件系统使用率。在同一个异常时间窗口内,如果请求尾延迟、磁盘等待和队列同时升高,并且CPU计算、内存交换和网络错误没有更强的解释,才能较有把握地判断480GB SATA SSD正在成为站点瓶颈;如果这些指标不同步,就应继续保留替代原因,避免仅凭一次测速或单个百分比作出更换磁盘的决定。


