

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


搭载1.92TB NVMe U.2 SSD的香港服务器,如果用于订单、账户、库存、支付记录等高频事务型数据库,未掌握完整压测数据时,建议以 16个物理核心、128GB内存 作为均衡起点;业务规模较小可从 8至12核、64GB 起步,热数据较大、读写混合或并发事务明显增加时,再考虑 24核、256GB。CPU决定并发事务、排序和日志处理能力,内存决定数据库能否把热点数据和索引留在缓存中,1.92TB NVMe U.2 SSD则主要承担随机读写和持久化写入,三者不能只看其中一个参数。
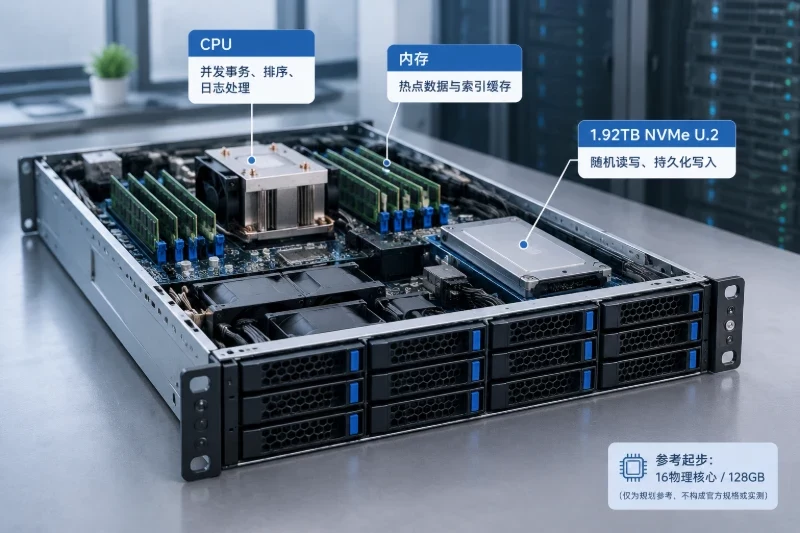
这个建议建立在几个前提上:服务器上的主要负载是数据库而不是大量应用服务;1.92TB容量中会预留日志、索引、临时文件和增长空间;数据库启用正常的数据持久化机制;部署前有可恢复的备份或快照;应用能够提供典型业务流量或历史SQL样本。香港服务器的网络响应时间只影响端到端请求耗时,不能代替数据库本身的CPU、内存和磁盘指标,验收时应将网络延迟与数据库执行延迟分开观察。
数据库硬件配置不能由“1.92TB”这个容量单独推导出来。容量说明能放下多少数据,不能说明每天有多少事务、多少数据需要频繁访问,也不能说明写入是否集中在某个时间段。
以常见的事务型业务为例,一次用户请求可能依次执行:
这类业务通常表现为小块随机读写、短事务较多、部分SQL对单核响应时间敏感。即使NVMe U.2 SSD能够提供较低的存储访问延迟,如果CPU单核繁忙、内存不足导致频繁回收缓存,应用仍然会出现响应变慢。
部署前至少记录以下数据,最好覆盖一个完整业务高峰:
需要区分三个容易混淆的量:
例如,应用可能有300个连接,但同一时刻只有40个活跃事务。这时直接把服务器升级到几十核,通常不如控制连接池、缩短事务和改善索引有效。
下面的配置是规划用的参考档位,不代表某个具体在售服务器的承载保证。实际选择时,还要核验CPU是独享物理核心还是共享vCPU,以及服务器内存是否为独享资源。
| 业务特征 | CPU参考配置 | 内存参考配置 | 适合的起步场景 |
|---|---|---|---|
| 中小型事务库,热点数据较少,活跃事务约20至60个 | 8至12个物理核心 | 64GB | 读写比例较稳定,SQL较短,数据增长可控 |
| 一般高IOPS事务库,活跃事务约50至150个 | 16个物理核心 | 128GB | 订单、账户、库存等混合读写业务 |
| 读写混合且热点数据较大,存在报表或批量任务 | 16至24个物理核心 | 128至256GB | 高峰期事务与批量查询并存 |
| 热点数据、索引和临时计算占用明显,内存回收频繁 | 24个物理核心左右 | 256GB | 需要较大缓存,且SQL并发较高 |
如果没有任何压测数据,建议优先选择 16个物理核心和128GB内存,而不是直接把预算集中到更多CPU核心上。对大多数事务型数据库而言,128GB可以为缓存、操作系统、数据库连接和临时计算留下较合理的空间;只有当热点数据已经明显超过这一规模,或监控显示内存持续紧张时,256GB才更有价值。
CPU配置需要同时看核心数和单核性能:
如果服务商提供的是vCPU,不要直接将“16 vCPU”当作“16个物理核心”。部署前应查看CPU拓扑和型号:
lscpu
nproc
重点关注 CPU(s)、Core(s) per socket、Socket(s)、型号名称以及是否存在明显的CPU共享说明。数据库延迟敏感业务更适合优先确认核心是否独享,再比较核心数量。
数据库使用内存时,至少要分成四部分:
以128GB专用数据库服务器为例,可以用下面的范围作为初始规划:
| 内存用途 | 128GB参考预留 | 说明 |
|---|---|---|
| 操作系统、监控和基础服务 | 12至16GB | 不建议压缩到只剩很小余量 |
| 数据库缓存或缓冲池 | 64至96GB | 具体比例取决于数据库引擎和数据访问方式 |
| 连接、排序、临时操作 | 16至24GB | 连接越多、复杂SQL越多,消耗越不稳定 |
| 故障和业务波动余量 | 8至16GB | 用于高峰、维护、缓存抖动和短时突发 |
这不是把内存简单分配后就能获得固定性能。数据库缓存值过大,可能挤压操作系统和连接工作区;缓存值过小,则会增加磁盘读取。尤其要注意,某些数据库的排序内存或会话内存是“每个操作”分配,不能把一个看似很小的参数乘以连接数后忽略总量。
1.92TB是存储容量,不等于数据库可以长期使用到100%。格式化后系统显示容量会因十进制与二进制换算、文件系统元数据等因素减少,通常只能看到约1.7TiB量级的可用空间,实际以服务器上的磁盘检查结果为准。
建议将以下内容一起纳入容量预算:
对于高IOPS数据库,不建议把磁盘使用率长期推到90%以上。可以把 70%至75% 作为开始制定扩容或清理计划的容量线,至少保留约20%至30%的可用空间。若数据每天持续增长,还要按未来6至12个月的增长量倒推可用空间,而不是只看当前数据大小。
在正式初始化数据库前,先确认系统看到的资源与购买配置一致。以下命令只读,不会修改数据:
lscpu
free -h
lsblk -o NAME,MODEL,SIZE,ROTA,TYPE,FSTYPE,MOUNTPOINTS
df -hT
findmnt
检查重点包括:
ROTA是否显示为非旋转设备;如果需要查看NVMe设备信息,可使用:
nvme list
sudo nvme smart-log /dev/nvme0
其中/dev/nvme0只是示例,必须根据nvme list输出确认设备名称。健康信息检查不会替代数据库压测,但可以提前发现温度、寿命、介质错误或设备状态异常。
不要直接对正在使用的数据库块设备执行写入测试,也不要把fio的目标写成裸设备。正式测试前应完成备份,并确认测试目录所在文件系统就是数据库计划使用的NVMe文件系统。
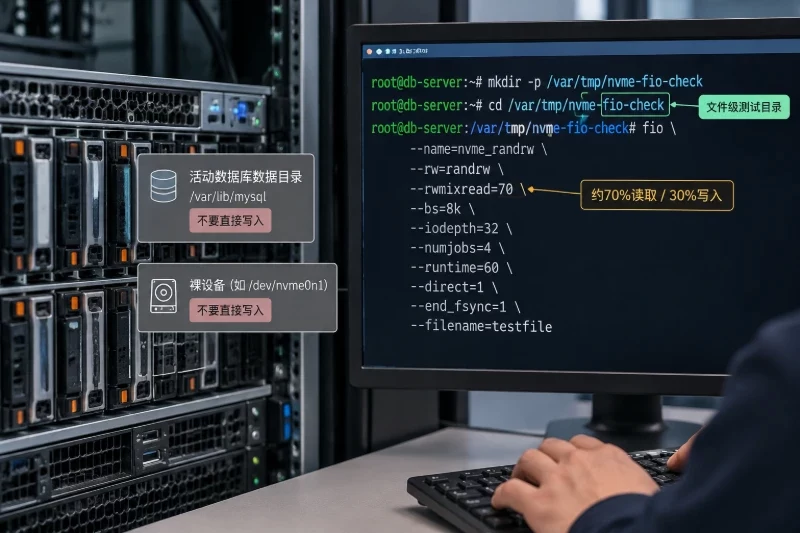
可以创建一个独立的测试目录,在业务低峰期执行文件级测试:
sudo mkdir -p /var/tmp/nvme-fio-check
sudo fio \
  --name=db-randrw-check \
  --directory=/var/tmp/nvme-fio-check \
  --size=8G \
  --rw=randrw \
  --rwmixread=70 \
  --bs=8k \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=32 \
  --numjobs=4 \
  --runtime=60 \
  --time_based \
  --group_reporting \
  --end_fsync=1
这个示例模拟约70%读取、30%写入的随机访问,8k只是常见数据库页大小附近的参考测试值,不代表所有数据库都使用相同块大小。若业务以写入为主,应重新测试更高写入比例;如果数据库主要执行较大范围扫描,也要增加顺序读写测试。
需要重点记录:
fio占满;测试完成后,确认目录中只有测试文件,并确认没有数据库或其他进程使用该目录,再删除测试文件。不要对数据库正式数据目录执行清理命令,也不要手动删除活动日志、重做日志或归档日志。
执行代表性负载前,先观察空载和测试期间的系统状态:
vmstat 1 10
iostat -x 1 10
free -h
如果系统没有iostat,不要仅凭命令失败判断磁盘有问题,应先确认系统是否安装了对应的监控工具。观察时重点看:
vmstat中的运行队列、上下文切换和swap活动;iostat -x中的设备利用率、平均等待时间和队列长度;free -h中的可用内存,而不是只看used数值;以128GB内存、数据库为主要服务的节点为例,建议先将“数据库可控缓存”和“操作系统可利用的文件缓存”合计规划在约60%至75%的内存范围内,再根据数据库引擎的内存模型细分。
不同数据库的参数名称不同:
| 资源用途 | 常见参数类型 | 配置原则 |
|---|---|---|
| 数据页缓存 | 缓冲池、共享缓存 | 先满足热点数据,再保留系统余量 |
| 排序与临时操作 | 工作内存、临时表内存 | 按活跃操作数估算,不按总内存盲目放大 |
| 数据库连接 | 最大连接数、线程数 | 连接池控制总量,避免每个连接都拥有过大的工作区 |
| 日志持久化 | redo、WAL、binlog相关参数 | 保持正常持久化,不以关闭安全机制换取短时性能 |
| 并行执行 | worker、并行线程数 | 从较低值开始,避免OLTP业务被批量查询抢占CPU |
如果使用128GB内存,可以先采用以下思路:
读密集型业务可以适当提高缓存比例,但前提是系统仍有足够可用内存;写密集型业务则要同时观察日志刷盘、检查点、锁等待和磁盘延迟,不能只增加缓存。
高IOPS数据库常见的错误配置是把最大连接数设得过大。连接数过高会带来更多内存消耗、上下文切换和锁竞争,可能让NVMe设备还没有达到瓶颈,CPU就已经被连接管理拖慢。
可以先按以下方式规划:
例如,若峰值时实际活跃事务约80个,不宜仅因为服务器有16核就把数据库连接数直接扩大到上千。应先确认连接等待、锁等待和SQL执行时间,再决定是增加CPU、内存,还是优化连接管理。
数据库目录确认在NVMe文件系统后,还要检查业务是否存在以下情况:
NVMe只能降低有效I/O请求的服务时间,不能消除无效SQL、全表扫描、锁竞争和过大的事务。对于写入型数据库,必须保持正常的日志持久化机制;如果为了追求测试中的更高IOPS而关闭安全写入选项,断电或进程异常时可能造成数据丢失或恢复失败。
单独执行fio只能说明文件系统和设备的表现,不能证明数据库业务一定达到同样的性能。验收时应使用脱敏后的业务数据、结构相近的索引和接近真实的SQL比例,至少覆盖:
可以同时观察以下指标:
iostat -x 1
vmstat 1
free -h
pidstat -u -r -d 1
数据库自身还应记录慢查询、锁等待、事务提交延迟、缓存命中率、日志刷盘延迟和检查点情况。
下表中的数值是常用的起步判断范围,最终应以业务SLO和实际SQL为准,不是NVMe U.2 SSD的固定性能承诺。
| 指标 | 可作为起步判断的范围 | 需要关注的现象 |
|---|---|---|
| CPU平均利用率 | 高峰持续低于70%至75% | 接近满载且SQL执行时间同步上升 |
| 单核利用率 | 不长期达到90%以上 | 单核满载但总CPU不高,可能是单线程瓶颈 |
| 可用内存 | 高峰仍保留10%至15%以上 | 频繁回收、swap增长、缓存反复失效 |
| Swap活动 | 正常高峰期应接近于零 | 持续读写说明内存或会话配置不合适 |
| 磁盘延迟 | P95、P99满足业务响应目标 | 平均延迟正常但尾延迟突然升高 |
| 数据库缓存命中率 | 结合业务类型观察,OLTP明显偏低时排查 | 热点数据未进入缓存或索引设计不合理 |
| 锁等待 | 高峰期不持续堆积 | 事务过长、更新顺序不一致或索引不足 |
| 磁盘剩余空间 | 尽量保留20%至30% | 日志、临时文件和索引维护空间不足 |
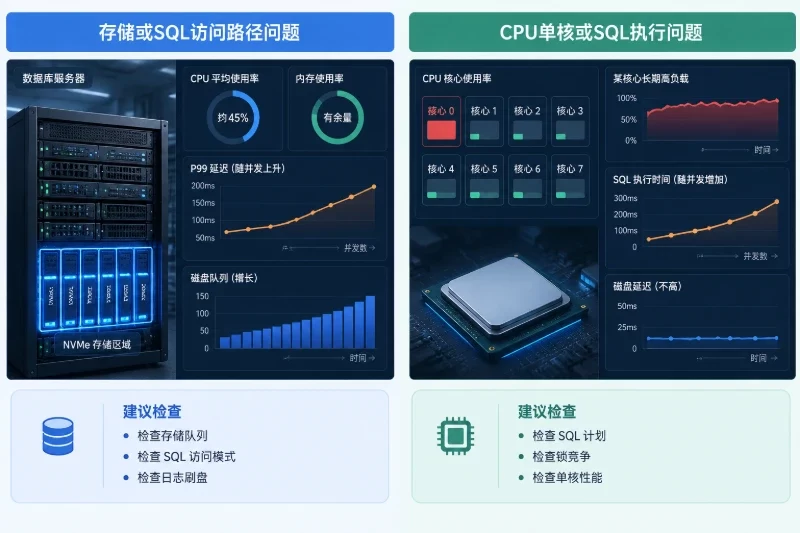
如果16核、128GB配置下,CPU平均只有45%,内存仍有充足余量,但数据库P99延迟随并发上升并伴随磁盘队列增长,问题更接近存储队列、SQL访问模式或日志刷盘,而不是CPU不足。反过来,如果磁盘延迟并不高,但某个CPU核心长期满载、SQL执行时间随并发增加,则应先检查SQL计划、锁竞争和单核性能。
数据库参数调整不要一次修改一大组。建议按“缓存参数、连接参数、并行参数、日志参数”的顺序分组,每次只改一组,并保留变更前的配置文件。
在修改前应完成:
修改后先执行配置检查,再进行小规模查询和写入验证,最后逐步放大并发。不要在没有确认配置路径、服务名称和数据库版本的情况下直接复制网上的命令。
如果数据库启动失败或延迟明显恶化,按以下顺序回退:
以Linux服务检查为例,服务名称需要按照实际数据库实例替换:
sudo systemctl status postgresql --no-pager
sudo journalctl -u postgresql -n 100 --no-pager
如果实际运行的不是该服务,先通过系统服务列表确认名称。配置回滚的目标是恢复参数和服务状态;数据回滚则必须依靠事务、备份或数据库自身的恢复机制,两者不能混用。
先确认业务请求是否真的落到测试过的NVMe目录,再检查SQL是否存在全表扫描、锁等待和长事务。随后观察数据库日志刷盘、临时文件和连接数。如果fio很快而数据库慢,通常说明瓶颈不在裸设备顺序能力,而在SQL、事务、缓存或并发控制。
查看单核利用率、数据库进程CPU时间和锁等待。如果只有一个或少数核心繁忙,可能是单线程查询、排序、加密或日志处理;如果CPU不忙但大量会话处于等待状态,则应区分I/O等待、锁等待和连接等待,不要直接加核心。
检查热点数据和索引是否已经超过缓存可承载范围,确认缓存参数没有被连接工作区挤压,并检查是否存在大批量扫描。数据库缓存命中率下降时,增加内存可能有效;但如果SQL每次都读取大范围数据,单纯加内存也无法完全解决问题。
先确认增长来源是数据、索引、事务日志还是临时文件。不要直接删除活动日志或数据库目录中的未知文件。完成备份并确认数据库支持的归档、清理或保留策略后,再进行受控处理。若增长趋势无法改变,应按未来容量需求提前调整部署规模,而不是等磁盘满后再处理。
升级应由持续指标触发,而不是因为服务器配置看起来“越大越好”。
因此,1.92TB NVMe U.2香港服务器的通用起步方案可以归纳为:普通高IOPS事务业务选择16个物理核心、128GB内存;规模较小且热点数据有限时选择8至12核、64GB;当热点数据、活跃事务和批量任务同时增长时,再向24核、256GB调整。部署后用CPU单核利用率、可用内存、数据库缓存、磁盘尾延迟、锁等待和容量增长共同验证,达到哪一项瓶颈就针对哪一项升级,避免只增加CPU或只堆内存。


