

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


把业务服务器放到香港,页面就一定会更快,是跨地域部署中常见的误解。香港低延迟服务器有条件地能够改善跨地域电商访问:当主要用户到香港的网络路径更短、更稳定,应用服务与核心数据依赖距离较近,并且高峰期丢包和拥塞可控时,连接建立、接口响应和页面首屏通常会受益。相反,如果瓶颈来自用户侧运营商互联、回程路径、远端数据库、支付接口或应用本身,单纯更换服务器位置可能效果有限,甚至出现平均延迟下降但高峰访问变慢的情况。
因此,不能只看一次 ping 或供应商给出的“低延迟”描述。更可靠的核验方式是:先从真实用户网络测试到候选服务器的路径,再用实际业务域名测量 DNS、TCP、TLS、首字节和完整响应时间,最后复现商品查询、购物车和结算预览等关键操作。只有路由质量和业务指标同时改善,香港节点才适合作为跨地域电商的部署方案。
ping 主要反映网络层面的往返时间,即数据包从测试端到服务器再返回所需的时间。一个请求的实际耗时还包括多个环节:
可以用下面的关系理解:
业务响应时间 ≈ 网络连接耗时 + TLS 耗时 + 应用处理时间 + 依赖调用耗时 + 响应传输耗时
例如,用户到香港服务器的网络往返时间从 80 毫秒下降到 45 毫秒,看起来改善了 35 毫秒。如果接口内部还需要依次调用三个远端服务,每次调用约 150 毫秒,那么页面总耗时仍可能超过 500 毫秒。此时,网络节点更换带来的收益会被业务调用链抵消。
跨地域电商更应关注以下指标,而不是只看平均值:
| 指标 | 代表含义 | 需要关注的现象 |
|---|---|---|
| 平均 RTT | 一段时间内的平均往返时延 | 适合观察整体水平,但容易掩盖尖峰 |
| P95/P99 RTT | 95%或99%请求能达到的延迟水平 | 反映高峰或少数用户的尾部体验 |
| 丢包率 | 数据包未能正常返回的比例 | 会引发重传,导致接口延迟突然升高 |
| 抖动 | 延迟在不同采样之间的变化 | 影响连接稳定性和实时交互 |
| TCP 连接时间 | 建立业务连接所需时间 | 可判断路径或端口连接是否异常 |
| TTFB | 收到首字节所需时间 | 同时受网络、排队和应用处理影响 |
| 完整响应时间 | 请求完成所需时间 | 更接近接口或页面的真实感受 |
| 错误率 | 请求失败、超时或状态码异常比例 | 判断线路是否可用的重要指标 |
假设两个候选节点的测试结果如下:
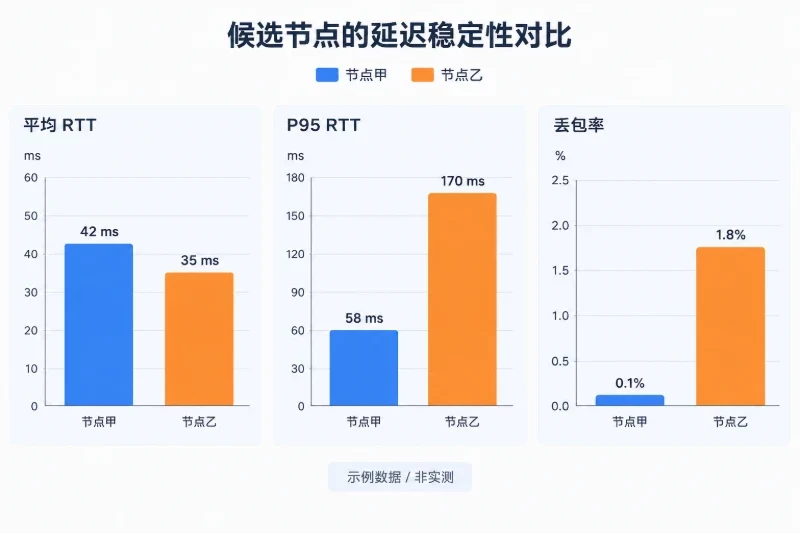
节点乙的平均值更低,但高峰波动和丢包明显更大。对于商品搜索、购物车更新和订单提交等操作,节点甲通常更容易保持稳定。企业采购时,应优先比较 P95、P99、超时率和业务接口耗时,而不是追求一次测试中的最低平均值。
跨地域电商访问大致经过以下链路:
香港节点主要能够影响第 1 至第 3 步,以及应用服务本身所在位置带来的网络距离。它不能自动消除第 5、6 步中的远程依赖,也不能替代应用优化。
如果应用服务、缓存和主数据库位于同一部署位置,用户请求到达香港后,大量读取操作可以在较短链路内完成,网络收益更容易体现在接口响应上。反之,如果应用在香港、数据库仍位于较远位置,且每个页面请求都要进行多次串行查询,那么用户到香港的路径改善可能被应用到数据库的往返时间抵消。
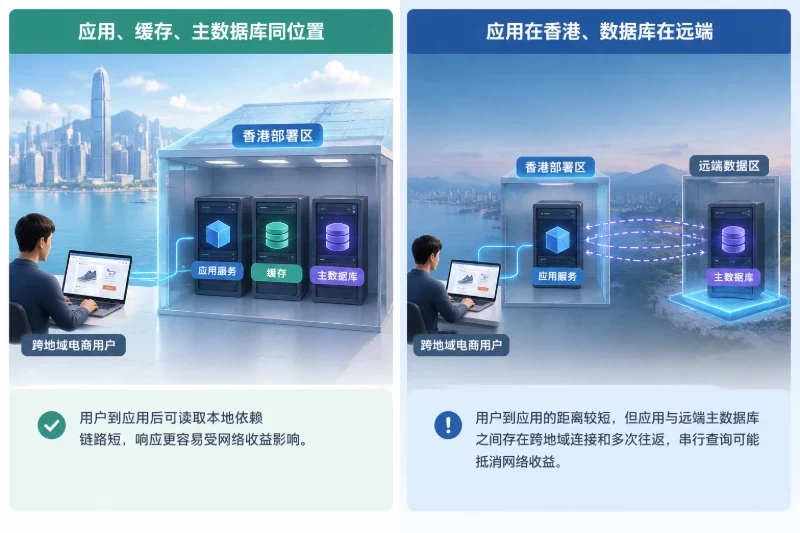
服务器机房与用户距离较近,并不等于实际网络路径一定较短。跨地域访问的实际路径由多种因素共同决定:
因此,“香港”可以作为候选部署位置,但不能单独作为性能结论。真正需要验证的是:目标用户网络到该服务器的实际路径是否稳定,业务请求是否通过该路径完成,以及高峰时段是否仍然保持可接受的 P95 和错误率。
不同业务请求对跨地域网络的敏感程度不同。
商品详情页如果主要读取缓存数据,应用只需完成少量查询,服务器位置变化可能较快地反映到 TTFB 上。购物车和订单预览通常需要读取用户状态、商品价格、库存和优惠信息,调用链更长,任何一个远端依赖出现延迟,都会影响最终结果。
可以把一次业务请求分为两类:
例如,三个依赖分别需要 100 毫秒,如果能够并行调用,网络部分可能接近 100 毫秒;如果必须串行调用,则可能接近 300 毫秒,还要加上连接和应用处理时间。此时,仅降低用户到应用服务器的几十毫秒,收益就会被串行调用消耗。
同一个香港服务器,对不同接入网络的表现可能不同。办公网络、家庭宽带和移动网络可能采用不同的出口和互联路径。即使一条路径在白天表现良好,业务高峰期也可能出现 RTT 抬升、丢包增加或 TCP 重传。
如果采购测试只在服务器机房内进行,或者只从一台办公电脑测试,结果不能代表全部目标用户。企业应优先使用真实用户所在的网络环境进行测试,并区分主要访问入口,而不是只测试服务器到某个公共地址的延迟。
traceroute 通常展示的是测试端发往服务器的路径,而 ping 反映的是去程和回程的综合结果。两者都不能单独证明服务器返回用户的完整路径质量。
这会造成一种现象:去程看起来跳数较少,但返回数据经过拥塞链路,实际 RTT 和接口耗时仍然偏高。因此,路径判断应结合目标服务器的 RTT、TCP 443 连接时间、HTTPS TTFB 和高峰数据。只看中间节点数量,不能得出业务一定更快的结论。
traceroute 中出现 *,可能是中间路由设备不回应探测报文,也可能是对 ICMP 或 UDP 探测进行了限速。只要后续跳数和最终目标仍然可以正常返回,单个中间节点的星号不能直接判定线路故障。
相反,如果某一跳开始延迟明显升高,并且后续每一跳直到最终服务器都保持较高水平,同时目标地址也出现丢包或延迟升高,才更值得怀疑路径中存在拥塞或质量问题。
将应用放到香港后,以下情况可能削弱收益:
这类问题的共同特点是:ping 结果可能不错,但 HTTPS 的 TTFB 或业务接口耗时仍然较高。此时需要查看应用分段耗时,而不是继续寻找更低的网络 RTT。
服务器可能对 ping 限速,甚至完全不回应 ICMP,但仍能正常处理 HTTPS 请求。反过来,服务器能够回应 ping,也不代表 TCP 443 连接、TLS 握手或应用接口一定正常。
因此,ping 适合观察网络趋势,traceroute 适合观察路径变化,真正的业务可用性还需要通过实际域名和业务协议测试。
候选节点之间的比较必须保持条件一致,否则数字没有可比性。建议固定以下内容:
至少应准备一个现有节点作为基线,再测试香港候选节点。没有基线时,即使候选节点的数值看起来不错,也很难判断改善幅度是否足以抵消迁移、数据同步和运维成本。
Linux 环境下可以使用以下示例命令,测试 100 个 ICMP 数据包:
ping -c 100 -i 0.2 -W 2 shop.example.com
Windows 环境可以使用:
ping -n 100 shop.example.com
重点记录:
例如,某次输出平均 40 毫秒并不代表长期稳定。如果 100 个样本中有 10 个超过 300 毫秒,用户体验仍可能出现明显卡顿。应保存多轮结果,计算 P95 或至少统计超过业务目标的样本比例。
ping 的局限也要明确:
Linux 示例:
traceroute -n -q 5 -w 2 shop.example.com
Windows 示例:
tracert -d shop.example.com
如果测试环境支持按业务端口探测,也可以尝试使用 TCP 443 的方式,使路径观察更接近实际 HTTPS 流量:
traceroute -n -T -p 443 -q 5 shop.example.com
TCP 探测可能需要更高权限,且不同系统版本对参数支持不同。执行前应先用 traceroute --help 或系统手册确认,不要把不兼容的参数直接用于生产环境。
阅读结果时,可以按照以下逻辑判断:
| traceroute 现象 | 更合理的解释 |
|---|---|
某一跳出现 *,后续跳数和最终目标正常 | 该中间节点可能不响应探测,不足以证明业务丢包 |
| 某一跳延迟升高,但后续跳数恢复正常 | 可能只是中间节点对探测报文限速 |
| 从某一跳开始,后续直到目标都明显升高 | 需要重点关注该段路径或互联位置 |
| 最终目标大量超时,但中间节点正常 | 可能是目标侧策略、端口或服务器负载问题 |
| 去程路径稳定,但 HTTPS 仍慢 | 需要检查回程、TLS、应用处理和远端依赖 |
不要把“跳数少”直接等同于“速度快”。不同网络节点的处理方式不同,跳数本身没有统一的性能含义。
对于电商业务,建议直接测量业务域名的 HTTPS 分段耗时。Linux 或 macOS 环境下,可以使用:
curl -o /dev/null -sS \
  -w 'dns=%{time_namelookup}\nconnect=%{time_connect}\ntls=%{time_appconnect}\nttfb=%{time_starttransfer}\ntotal=%{time_total}\nhttp_code=%{http_code}\nremote_ip=%{remote_ip}\n' \
  https://shop.example.com/
这些字段可以这样理解:
| curl 字段 | 观察重点 |
|---|---|
time_namelookup | DNS 解析耗时 |
time_connect | TCP 连接完成时间 |
time_appconnect | TLS 握手完成时间 |
time_starttransfer | 收到首字节的时间,包含服务器处理 |
time_total | 整个响应完成时间 |
http_code | HTTP 响应是否正常 |
remote_ip | 本次实际连接到的地址 |
如果要在同一域名下比较两个候选地址,应保持 Host 和 TLS SNI 不变。例如,候选地址为文档示例中的 203.0.113.10 时:
curl -o /dev/null -sS \
  --resolve shop.example.com:443:203.0.113.10 \
  -w 'dns=%{time_namelookup}\nconnect=%{time_connect}\ntls=%{time_appconnect}\nttfb=%{time_starttransfer}\ntotal=%{time_total}\nhttp_code=%{http_code}\nremote_ip=%{remote_ip}\n' \
  https://shop.example.com/
实际使用时,应将示例地址替换为候选服务器的真实测试地址,并确认该地址确实承载相同的测试站点。不要直接对生产订单、支付或库存变更接口进行重复请求,应使用只读页面、健康检查接口或专用测试接口。
从分段结果可以快速定位问题:
connect 增长明显:重点看 TCP 路径、端口连通性和丢包;只测首页不够。建议至少覆盖以下只读或低风险场景:
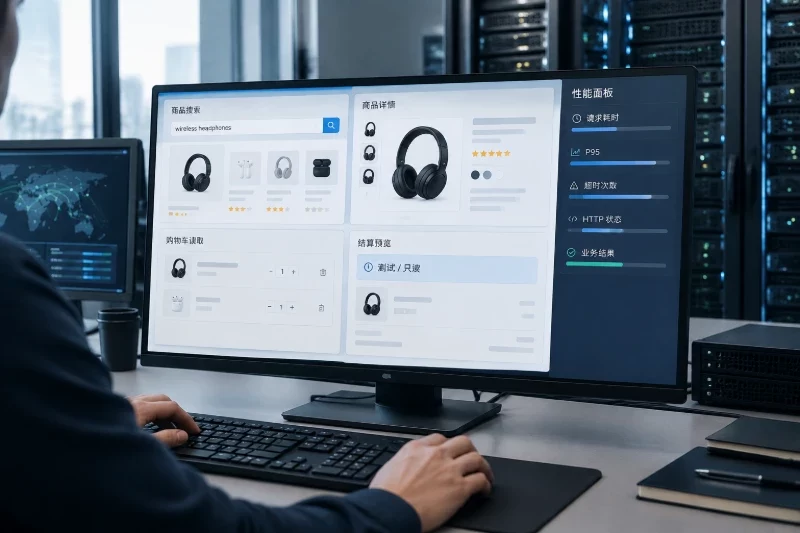
每个场景都记录请求耗时、状态码、超时次数和业务结果。对于需要登录的场景,应使用专门的测试账号和测试数据,避免将验证流量混入真实订单统计。
可将一次测试周期内的结果整理成以下形式:
| 测试场景 | 平均耗时 | P95耗时 | 超时率 | 业务结果 |
|---|---|---|---|---|
| 商品搜索 | 260ms | 420ms | 0.1% | 正常返回 |
| 商品详情 | 310ms | 560ms | 0.2% | 图片和价格正常 |
| 购物车读取 | 430ms | 890ms | 0.8% | 偶发重试 |
| 结算预览 | 760ms | 1.8s | 1.5% | 高峰时明显变慢 |
上表只是演示记录方式,不是通用性能标准。企业应结合自身页面复杂度、用户容忍度和业务峰值设定验收线。对电商而言,结算预览的 P95 和错误率往往比首页平均耗时更有决策价值。
可以通过以下几种结果组合进行判断:
| 路由测试 | HTTPS 测试 | 业务接口 | 可能结论 |
|---|---|---|---|
| 明显改善 | 连接和 TTFB 同步改善 | 关键操作也改善 | 香港节点具备实际收益 |
| 明显改善 | 连接改善但 TTFB 不变 | 业务耗时几乎不变 | 应用或远端依赖是主要瓶颈 |
| 没有改善 | HTTPS 仍高波动 | 业务超时增加 | 用户到香港的路径不适合该访问群体 |
| 平均值改善 | P95、P99变差 | 高峰体验变差 | 路径稳定性不足,不宜只看平均值 |
| ping 正常 | TCP 或 TLS 异常 | 访问失败 | ICMP 结果不能代表业务端口可用 |
| 路由变化小 | total 变慢 | 响应内容较大 | 需要检查传输量、应用返回和重传 |
这类对照比“香港平均延迟是多少”更适合采购判断,因为它能说明延迟改善是否真正传递到用户操作。
一次测试只能反映某个时间点。更稳妥的方式是安排多个时间窗口,并保存原始结果:
如果条件允许,至少从三类真实接入环境发起测试:企业办公网络、家庭宽带和移动网络。不同网络都改善,说明方案的适用面较好;只有某一类网络改善,则应将香港节点定位为特定用户群体的优化方案,而不是所有用户的统一入口。
测试期间还要记录 DNS 返回地址和实际连接地址。若多次测试得到的地址不同,必须确认是否存在解析调度或缓存差异,否则候选节点之间的结果可能并非来自同一个服务地址。
供应商或内部网络团队应明确以下信息:
如果只给出“某地到香港几十毫秒”的单点数据,却没有时间、测试端、样本量和业务协议,不能据此推断真实电商体验。
香港服务器的成本判断不能只看租用费用。还应纳入:
如果只是将应用移到香港,但数据库、库存或订单依赖仍需频繁跨地域访问,可能同时增加传输成本和业务延迟。更合理的方案是先梳理请求链,找出最频繁、最影响用户体验的跨地域调用,再决定哪些服务需要靠近应用部署。
验收不应只写“服务器可连通”或“平均 ping 达标”,而应包括:
这样可以避免出现“网络测试合格,但上线后购物车和结算仍然缓慢”的情况。
香港低延迟服务器通常不适合作为以下问题的唯一解决手段:
尤其需要注意“平均延迟下降但业务没有改善”的情况。这通常不是测试无效,而是说明网络只占总耗时的一部分。此时应根据 DNS、连接、TLS、TTFB 和依赖调用分段结果继续定位,而不是继续以地理位置作为主要优化方向。
如果目标用户到香港服务器的 RTT、P95 和丢包率均优于现有节点,同时 HTTPS 的连接时间、TTFB、关键接口 P95 和超时率也同步下降,可以认为香港低延迟服务器对该跨地域电商场景具有实际价值。
如果只有 ping 变快,业务接口没有变化,应优先检查数据库和远端依赖;如果平均值变快但 P95 变差,应关注高峰拥塞和路径稳定性;如果 traceroute 看起来正常但 HTTPS 失败,则应检查 TCP 443、TLS、服务器负载和应用响应。通过多用户网络、多时间窗口、路由工具和真实业务操作进行交叉验证,才能判断这是一项可复现的网络收益,还是某个测试时刻的偶然结果。


