

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


服务器选用 SATA SSD 和 NVMe SSD,差距是否明显,不能只看硬盘标称的顺序读写速度。对数据库、虚拟机、容器和大量小文件服务,NVMe 通常更容易体现出低延迟、高 IOPS 和高并发优势;对系统盘、静态文件、备份或受网络带宽限制的业务,升级后可能只有局部改善。真正能回答“换成 NVMe 后提升多少”的,是在相同环境下比较同一业务负载的吞吐、IOPS、延迟和尾延迟。
测试时应至少覆盖 4K 随机读写、顺序读写、不同队列深度、读写混合比例以及同步写入。只跑一次最高 IOPS,无法说明实际应用会快多少;也不能把 NVMe 的理论带宽直接等同于服务器业务性能。
SATA SSD 与 NVMe SSD 的差别,本质上不只是闪存颗粒不同,还包括连接协议、队列能力、控制器和主机接口路径。SATA 设备通常受 SATA 6 Gb/s 链路限制,顺序读写在实际环境中常见于约 500~550 MB/s 的范围;NVMe 通过 PCIe 通道传输,顺序带宽和并发 I/O 能力可以高出许多。
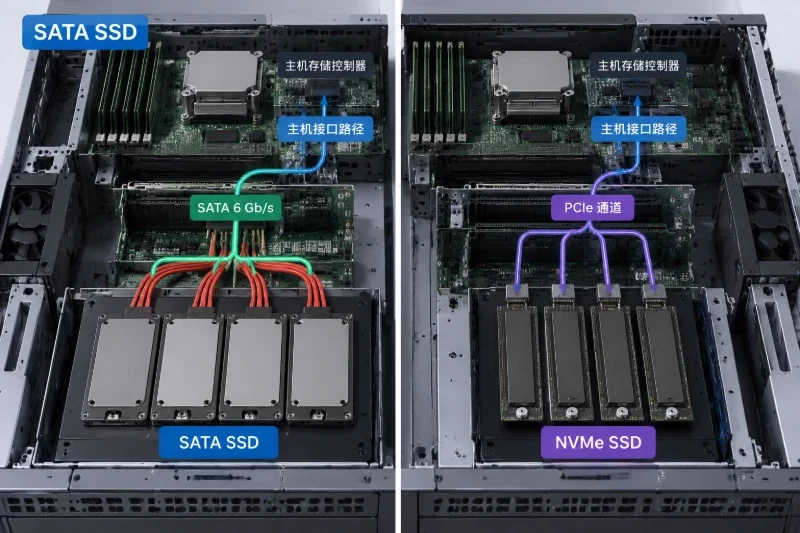
但这只是设备层面的潜力。应用最终能否获得提升,还取决于以下因素:
fsync 或持久化确认;因此,测试应尽量采用“同一台服务器、更换存储设备、保持其他条件不变”的方式。至少固定以下变量:
| 对照项目 | 应保持一致的内容 |
|---|---|
| 服务器环境 | CPU、内存、BIOS 电源策略、内核和操作系统版本 |
| 软件栈 | 文件系统、挂载参数、数据库版本、应用版本 |
| 测试数据 | 文件大小、数据内容、块大小、读写比例 |
| 并发参数 | numjobs、iodepth、线程数和连接数 |
| SSD 状态 | 容量规格、使用率、预热状态、温度和持续写入时间 |
| 测试时间 | 尽量在相近的业务低峰期,避免后台任务干扰 |
如果 SATA SSD 和 NVMe SSD 分别安装在不同服务器上,测试结果只能说明两套整体环境的差异,不能直接归因于存储设备。
吞吐量通常以 MB/s 或 GB/s 表示,用来衡量单位时间内传输的数据量。顺序读写、备份、日志归档、大文件处理等场景比较依赖这个指标。
例如,测试得到 520 MB/s 和 3,000 MB/s,理论上将 100 GB 文件完整读完所需时间分别约为:
实际时间还会受到文件系统、CPU、校验、应用处理和网络传输影响。这个结果不能直接推导出网页响应时间或数据库事务性能。
IOPS 表示每秒完成的 I/O 操作次数。4K 随机读写通常用来观察数据库、虚拟机和小文件服务的存储响应能力。
同样是 400 MB/s:
所以不能只比较 IOPS 数值,还要同时记录块大小、读写类型和队列深度。没有这些条件,“几十万 IOPS”几乎没有可比性。
IOPS 与延迟、并发数之间可以用一个简单关系理解:
IOPS ≈ 并发 I/O 数 ÷ 平均延迟(秒)
例如队列深度为 32,平均延迟为 0.5 毫秒,也就是 0.0005 秒,则理论 IOPS 约为:
32 ÷ 0.0005 = 64,000 IOPS
当队列深度继续增加时,IOPS 可能上升,但延迟也会快速增加。对交互式业务来说,单纯追求更高 IOPS 可能会牺牲响应时间。
平均延迟只能描述总体水平,建议同时关注以下分位值:
数据库提交、虚拟机磁盘访问和在线服务通常更关注 P95、P99,而不是最高 IOPS。NVMe 的优势经常首先体现在低队列深度和尾延迟上:即使平均吞吐没有达到标称值,突发请求的排队时间也可能更短。
队列深度(QD)表示等待设备处理的 I/O 数量,numjobs 表示并行任务数量。测试时至少应覆盖:
很多 SSD 在 QD1 时的性能差距,与 QD32 的差距完全不同。如果业务长期只有几个并发请求,拿厂商或工具在高队列下的最高成绩进行对比,参考价值有限。
使用 NVMe 后,I/O 完成速度更快,但每秒处理的请求数量也可能增加,CPU 中断、系统调用和文件系统处理开销不一定同步下降。因此应同时记录:
iostat 中的 await、aqu-sz 和 %util;如果 NVMe 的 IOPS 提升了数倍,但 CPU 已经跑满,业务吞吐可能不会按存储性能同比增长。此时限制因素已经从硬盘转移到 CPU 或应用层。
先确认设备、挂载点和传输类型,避免把测试文件写到错误的磁盘上:
lsblk -o NAME,MODEL,SIZE,ROTA,TRAN,FSTYPE,MOUNTPOINTS
df -hT /data
NVMe 设备还可以查看控制器信息:
nvme list
如果系统没有 nvme 命令,不要据此判断设备不是 NVMe;可以结合 lsblk 的 TRAN 字段和实际挂载路径确认。测试前还应确认 PCIe 链路没有降级、SSD 没有处于明显温度降速状态,并记录设备当前使用率。
测试文件应放在专用目录,不能直接把 /dev/sda、/dev/nvme0n1 等原始设备作为目标。原始设备测试会覆盖分区或文件系统中的数据,除非已经完成备份、快照和维护窗口确认,否则不应执行。
下面是一个 4K 随机读示例。/data/fio-test 必须是待测 SSD 上的专用目录,20G 只是示例值,应根据可用空间和业务条件调整:
mkdir -p /data/fio-test

fio --name=randread-q1 \
  --filename=/data/fio-test/test.bin \
  --size=20G \
  --rw=randread \
  --bs=4k \
  --direct=1 \
  --ioengine=libaio \
  --iodepth=1 \
  --numjobs=1 \
  --runtime=60 \
  --ramp_time=10 \
  --time_based \
  --group_reporting \
  --percentile_list=50:90:95:99:99.9
为了避免读到未实际写入的数据,正式随机读测试前应先用相同大小的测试文件完成一次填充。测试文件会占用空间并产生写入磨损,生产环境应使用业务低峰期或独立测试盘,不能与真实数据并发运行。
在相同测试文件和目录上,可以改变以下参数形成对照组:
| 测试项目 | rw | bs | 建议观察点 |
|---|---|---|---|
| 顺序读 | read | 1M | 带宽、CPU 占用 |
| 顺序写 | write | 1M | 持续写入速度、降速情况 |
| 随机读 | randread | 4k | QD1、QD4、QD32 的 IOPS 和 P99 |
| 随机写 | randwrite | 4k | 写入延迟、尾延迟、设备稳定性 |
| 混合随机 | randrw | 4k 或业务块大小 | 读写比例变化后的综合表现 |
| 数据库类写入 | write 或 randwrite | 4k/8k | fsync 或 fdatasync 下的提交延迟 |
混合读写可以使用类似参数:
fio --name=randrw-70read \
  --filename=/data/fio-test/test.bin \
  --size=20G \
  --rw=randrw \
  --rwmixread=70 \
  --bs=4k \
  --direct=1 \
  --ioengine=libaio \
  --iodepth=32 \
  --numjobs=4 \
  --runtime=300 \
  --ramp_time=30 \
  --time_based \
  --group_reporting \
  --percentile_list=50:90:95:99:99.9
这个命令中的 70 表示读请求约占 70%,剩余约 30% 为写请求。实际比例应尽量接近业务监控中观察到的读写比例,而不是固定采用某个“标准值”。
如果业务依赖提交确认,必须单独测试同步写入。direct=1 主要用于减少操作系统页缓存影响,并不等于每次写入都已经持久化。数据库日志、订单提交等场景,应按照实际使用的 fsync、fdatasync 或存储持久化策略测试,否则得到的写入延迟可能过于乐观。
fio 运行期间,另一个终端可以观察块设备状态:
iostat -xm 1
重点记录:
r/s、w/s:每秒读写请求数;rMB/s、wMB/s:读写带宽;await:请求从提交到完成的平均等待时间;aqu-sz:平均队列长度;%util:设备忙碌程度。fio 结果中的 bw、IOPS、平均延迟和各分位延迟应与 iostat 的数据放在一起看。比如 fio 显示 IOPS 很高,但 await 和 P99 已经明显上升,说明设备正在排队,不能简单判断为“性能更好”。
每组测试建议预热 10~30 秒后再记录,连续运行至少 60 秒;需要观察持续写入或温度影响时,建议延长到 5~15 分钟。每项至少重复 3 次,报告中使用中位数,并保留最大、最小值和 P95/P99。第一次运行常受文件分配、缓存和后台初始化影响,不宜直接作为最终结果。
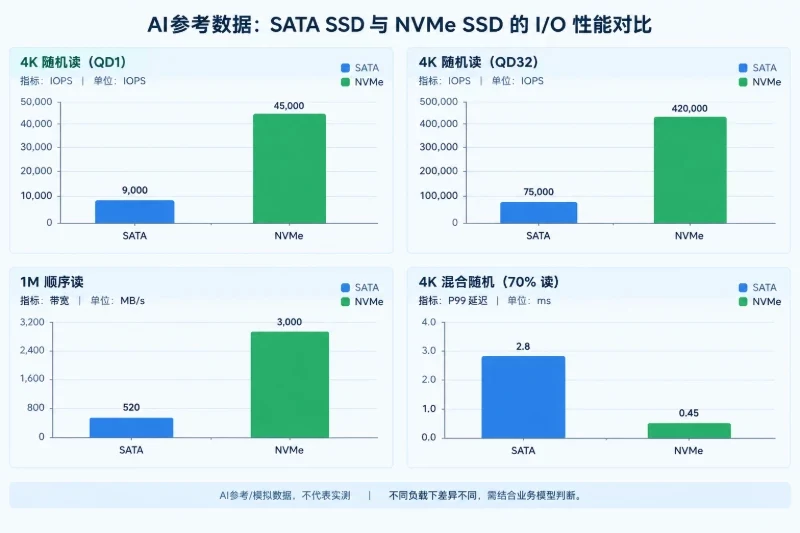
下面是一组用于解释方法的模拟对照数据,不代表某台服务器、某个品牌或某次实际测量结果:
| 场景 | SATA SSD | NVMe SSD | 主要含义 |
|---|---|---|---|
| 4K 随机读,QD1 | 约 9,000 IOPS,0.11 ms | 约 45,000 IOPS,0.022 ms | 低并发请求的响应差异明显 |
| 4K 随机读,QD32 | 约 75,000 IOPS,0.43 ms | 约 420,000 IOPS,0.076 ms | 高并发下 NVMe 的队列处理能力更强 |
| 顺序读,1M | 约 520 MB/s | 约 3,000 MB/s | 大文件读取带宽差距较大 |
| 混合随机,4K,70%读 | 约 55,000 IOPS,P99 2.8 ms | 约 260,000 IOPS,P99 0.45 ms | NVMe 的尾延迟更低 |
| 设备满载时 CPU | 约 18% | 约 36% | 更高 IOPS 可能带来更多系统处理开销 |
从这组示例可以看出,NVMe 可能同时在 IOPS、带宽和尾延迟上占优,但业务收益仍需结合请求模型判断:
重点不应是顺序读取峰值,而是:
如果数据库缓冲池已经将大量热点数据放在内存中,换 NVMe 后磁盘性能提升可能不会完全反映到查询响应时间。应同时记录事务数、查询延迟、缓存命中率和 I/O wait。
这类负载往往同时产生大量小块随机请求,且多个实例会争用同一个存储队列。应重点比较:
如果测试只在单任务、顺序读条件下进行,容易低估 NVMe 在多实例场景中的价值。
系统启动和常规管理操作通常是低并发、混合小文件访问,升级到 NVMe 可能改善启动、更新和索引操作,但未必带来与顺序带宽差距相同的提升。
静态文件和备份则要看数据是否能持续顺序读取,以及网络出口是否足够快。如果网络只能承载几百 MB/s,NVMe 的更高本地带宽可能无法传递给远端客户端。
可以把决策边界归纳为三类:
成本判断也不能只看接口速度。应将设备容量、剩余空间、持续写入能力、服务器兼容性、散热条件和业务停机成本纳入同一比较。若使用率长期接近满盘,先释放容量或调整数据布局,再进行对照测试,否则测到的可能是空间不足和垃圾回收的影响,而不是 SATA 与 NVMe 的接口差距。
更换存储设备后,建议在以下条件下复测:
容量判断可以从实际峰值反推。若业务峰值约为 50,000 IOPS,而 SATA 在相同块大小和读写比例下已经接近其稳定区间,且 P99 持续升高,那么升级 NVMe 可能有明确价值;若业务峰值只有几千 IOPS,设备利用率低、网络或 CPU 已先达到上限,则更换存储设备的收益可能有限。
最终应以“业务指标是否改善”作为验收依据:数据库看事务延迟和 P99,文件服务看实际传输时间,虚拟机看多实例并发时的磁盘延迟。只有设备层的 IOPS、吞吐和延迟变化能够传递到这些指标上,SATA SSD 换成 NVMe SSD 才算真正解决了性能瓶颈。


