

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


要判断香港、新加坡、韩国服务器怎么选,先看访问用户集中在哪里,再看应用是否依赖固定数据库、实时交互和跨境线路。通常,内地及香港用户占多数时优先评估香港;东南亚用户占多数时优先评估新加坡;韩国及邻近东北亚用户占多数时优先评估韩国。若用户分布较平均,则不能只看地理距离,还要结合实际网络测试、数据写入位置和业务峰值做决定。
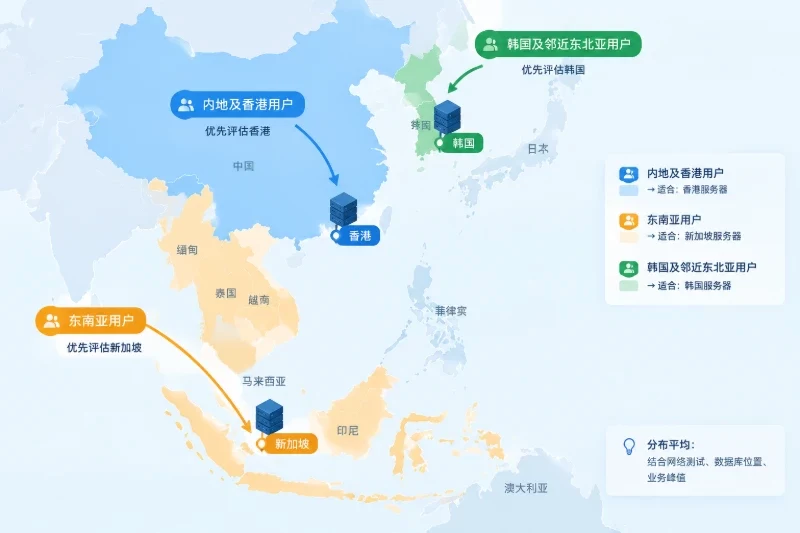
地域只是第一层条件,线路质量决定了“同一地区服务器”在不同运营商、不同时间段的真实表现。下面按照“用户来源 → 业务类型 → 网络验证 → 上线与回滚”的顺序,说明香港、新加坡、韩国服务器怎么选,以及如何把选择结果验证到可执行。
部署前不要直接用公司办公网络测试一次就下结论。至少需要整理以下信息:
如果还没有统计数据,可以先用一个短周期访问日志或业务分析结果作初步判断。例如,内地及香港流量约占 65%,东南亚约占 20%,韩国及邻近东北亚约占 15%,香港通常是第一候选;如果东南亚流量达到 60% 以上,新加坡更值得优先测试;如果韩国本地用户占绝大多数,韩国节点的实际访问路径通常更有优势。
不过,动态业务还要多看一层:用户请求最终是否需要访问数据库。
下表是选择方向,不代表任何位置在所有网络和时段都占优。
| 服务器位置 | 更适合的用户来源 | 主要优势 | 需要重点验证 |
|---|---|---|---|
| 香港 | 内地及香港用户占多数,或业务需要兼顾两者 | 地理距离较近,适合面向华南及香港的访问 | 高峰时段跨境延迟、丢包、不同运营商的线路差异 |
| 新加坡 | 新加坡及东南亚用户占多数,或业务面向多个东南亚市场 | 对东南亚多地访问较容易形成相对均衡的路径 | 内地及香港用户的访问延迟、动态请求回源时间 |
| 韩国 | 韩国用户占多数,或用户集中在邻近东北亚地区 | 面向韩国本地用户时通常更容易获得较短路径 | 东南亚和内地用户的跨区域延迟、峰值时段抖动 |
香港适合作为内地及香港访问者占主要比例时的第一候选,尤其是企业官网、内容站、面向华南用户的 API 和管理系统。
但“距离近”不等于所有线路都稳定。需要重点观察:
如果香港节点静态页面很快,但 API 的首字节时间明显偏高,问题可能不在服务器位置,而在应用和数据库之间的连接、查询或跨境路径。此时仅更换服务器城市,未必能解决核心问题。
新加坡更适合新加坡及东南亚访问量较高的站点,例如区域型官网、SaaS 控制台、跨境电商后台和面向多个东南亚市场的 API。
选择新加坡时,不要只用新加坡本地网络测试。应至少分别从主要用户所在网络测试,因为用户分布在多个国家或地区时,可能出现以下情况:
如果业务主要是缓存命中率较高的内容站,新加坡的位置优势通常更容易体现;如果业务是强事务型系统,则应先确定数据库主节点位置,再判断应用节点是否需要靠近数据库。
韩国适合用户主要在韩国本地、业务对韩国访问体验有明确要求的场景,例如韩国本地用户使用的官网、API、互动应用或企业服务。
需要注意的是,韩国服务器并不天然适合所有亚洲用户。若主要访问者在东南亚或内地,韩国节点可能在地理距离、路由跳数和高峰抖动方面不占优。因此,韩国候选至少要测试:
如果韩国用户带来的业务收入、活跃度或实时交互需求明显高于其他地区,即使平均访问量不是最高,也可以把韩国作为主节点,再为其他来源的静态内容单独优化缓存和资源分发。
可以按以下顺序缩小范围,而不是先比较套餐名称。
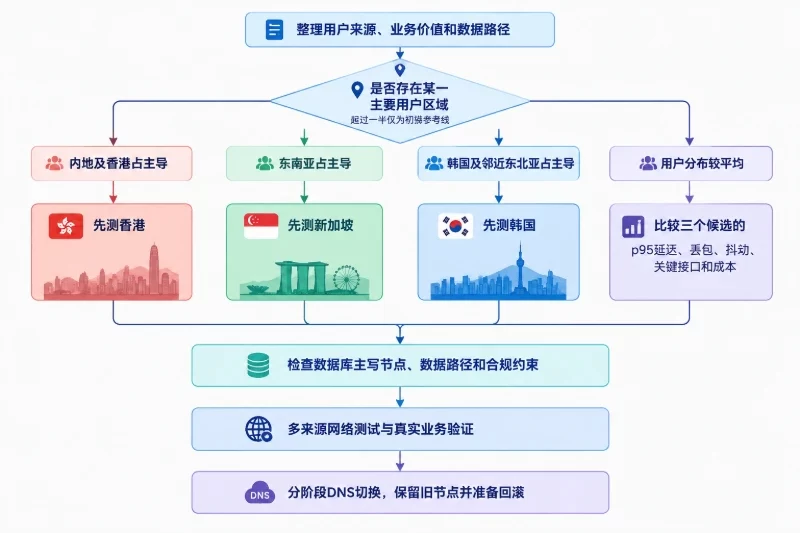
如果某一用户区域占比超过一半,先选择该区域对应的位置做候选:
这里的“一半”只是便于初筛的参考线,不是统一标准。若某地区虽然流量占比低,但承载核心客户或高价值交易,也应提高其权重。
当三个方向的访问量相近时,不要简单取中间位置,而应使用加权判断:
如果静态访问占 80% 以上,缓存命中率可以降低服务器位置对页面体验的影响;如果动态请求占比高,用户到应用、应用到数据库的两段路径都要纳入判断。
如果数据库只有一个主写节点,应用节点通常应优先靠近数据库,而不是只追求用户侧 Ping 最低。
例如:
这类业务应分别测量“用户到应用”和“应用到数据库”的时间。若不能迁移数据库,可以优先把应用部署到数据库附近,再通过缓存、读副本或异步任务减少用户请求对远端写入的直接等待。
测试前准备以下条件:
/healthz;不要只在候选服务器内部运行 Ping。服务器到服务器的结果,不能代表用户到服务器的方向。
以下命令适用于常见 Linux 测试环境。示例中的 IP 仅表示填写位置,不能作为实际节点地址。
TARGET=app.example.com
CANDIDATE_IP=203.0.113.10

echo "== ICMP RTT and loss =="
ping -c 20 -i 0.2 "$CANDIDATE_IP"

echo "== Route path =="
if command -v traceroute >/dev/null 2>&1; then
    traceroute -n -q 3 -w 1 "$CANDIDATE_IP"
else
    echo "traceroute is not installed; run the same test from a host that provides it."
fi

echo "== HTTPS timing =="
curl --resolve "${TARGET}:443:${CANDIDATE_IP}" \
  -o /dev/null -sS \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s ttfb=%{time_starttransfer}s total=%{time_total}s http=%{http_code}\n' \
  "https://${TARGET}/healthz"
三种结果的含义不同:
* 可能是设备不响应探测,不应单独视为业务丢包。建议每个来源网络在不同时段重复测试。单次结果只能用于发现异常,不能作为最终部署依据。
如果使用 Nginx 作为现有入口,可以为每个候选节点配置相同的站点规则。以下示例假定应用监听本机 127.0.0.1:8080,并使用 Ubuntu 系统上的 Nginx;如果实际入口软件或端口不同,应按现有环境调整。
server {
    listen 80;
    server_name app.example.com;

    location = /healthz {
        default_type text/plain;
        add_header Cache-Control "no-store";
        return 200 "ok\n";
    }

    location / {
        proxy_pass http://127.0.0.1:8080;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
    }
}
修改配置前,先备份原文件。配置检查通过后再 reload,避免直接重启造成不必要的中断:
sudo cp /etc/nginx/sites-available/app.conf \
        /etc/nginx/sites-available/app.conf.bak-$(date +%F-%H%M%S)

sudoedit /etc/nginx/sites-available/app.conf
sudo nginx -t
sudo systemctl reload nginx
curl -i http://app.example.com/healthz
这组操作的影响范围是当前 Nginx 配置和对应站点,不涉及数据库结构变化。若 nginx -t 失败,不要 reload;恢复备份文件后重新检查即可。若 reload 后业务异常,可将备份文件恢复到原路径,再执行 nginx -t 和 reload。
健康检查只能证明入口和基础进程可用,还需要验证真实业务:
切换前可以把 DNS TTL 调整到较短的值,例如 300 秒,但这不会消除所有缓存。不同递归 DNS、浏览器和本地网络可能仍在一段时间内保留旧记录。
切换顺序建议如下:
可以用以下命令检查 DNS 是否已经在不同解析器生效:
dig +short app.example.com
dig app.example.com
curl -I --connect-timeout 5 https://app.example.com/healthz
如果 dig 已返回新地址,但用户仍访问旧节点,通常是递归 DNS 或本地缓存尚未更新;如果解析结果正确但请求仍失败,则应检查 TLS、Nginx 的 server_name、应用端口和安全策略。
先按访问来源选择位置,再看缓存命中率。如果大部分内容可缓存,香港、新加坡、韩国之间的差异可能主要体现于首次访问、缓存未命中和后台接口,而不是所有静态页面。
这类业务的测试重点是:
数据库位置优先级提高。香港、新加坡、韩国都可以作为应用位置,但必须把登录、库存、订单、支付回调等动态流程逐项测试。
如果用户地区和数据库位置冲突,可以比较两种方案:
最终以完整业务流程的 p95 时间和错误率为准,而不是只比较首页 Ping。
实时业务应同时看:
如果韩国用户的实时交互占主要业务价值,韩国通常应优先进入测试;如果用户分散在东南亚多个方向,则新加坡可以作为候选,但仍需用主要用户网络进行实测。
三个位置进行价格比较时,应使用相同口径,至少核对:
可以先用业务流量做粗略估算。假设每天出站流量为 100 GB,按十进制换算:
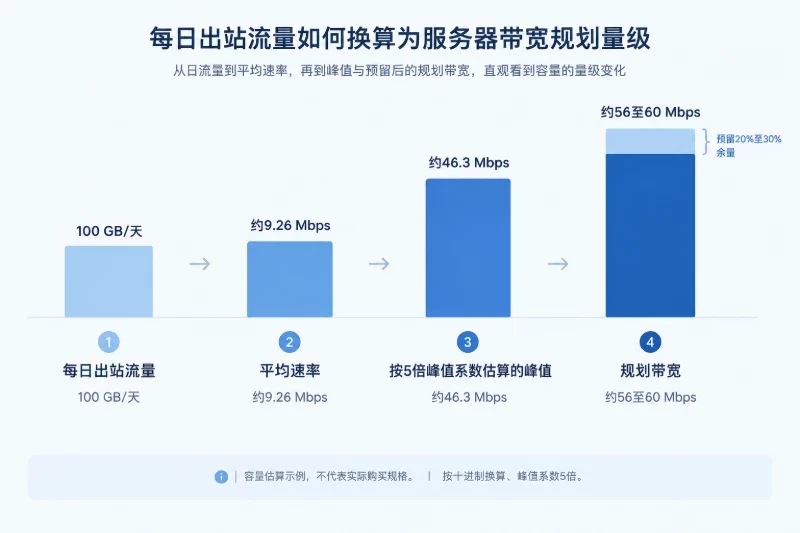
这只是容量估算,不代表实际购买规格。突发下载、接口响应大小、并发连接和峰值持续时间都会改变结果。带宽够用但线路丢包,业务仍可能超时;延迟较低但出口容量不足,也会在高峰时变慢。
上线后需要区分“位置或线路问题”和“应用本身问题”,避免一出现慢请求就更换服务器。
| 现象 | 更可能的原因 | 处理方向 |
|---|---|---|
| Ping 延迟高,curl 也高 | 路径或候选位置不合适 | 从多个来源重测,比较其他位置 |
Traceroute 有 *,但 HTTPS 正常 | 中间设备限制探测响应 | 以 TCP/HTTPS 结果为主,不单凭 * 回滚 |
| Ping 正常,TTFB 很高 | 应用、数据库或上游接口慢 | 检查应用日志、数据库连接和查询耗时 |
| 静态页面正常,写入接口超时 | 数据库距离、事务或连接池问题 | 单独测量写请求链路,不急于更换节点 |
| DNS 已改,部分用户仍到旧节点 | DNS 缓存尚未过期 | 保留旧节点,等待缓存周期并持续监控 |
| 切换后 5xx 和重连明显增加 | 配置、证书、端口或应用环境不一致 | 先停止扩大流量,恢复原记录 |
回滚应提前定义触发条件。例如,新节点连续 10 分钟错误率明显高于旧节点,或关键接口 p95 延迟达到基线的 1.5 倍以上,就先停止继续切换。具体阈值要根据业务平时的波动范围调整。
DNS 回滚的动作是把正式域名恢复到旧节点记录,并继续保留新节点,直到确认问题原因。若只是 Nginx 配置错误,则恢复备份配置:
sudo cp /etc/nginx/sites-available/app.conf.bak-YYYY-MM-DD-HHMMSS \
        /etc/nginx/sites-available/app.conf

sudo nginx -t
sudo systemctl reload nginx
恢复前要确认备份文件确实对应当前线上版本,避免把更早的配置覆盖到现网。数据库和应用发布包也应保留切换前版本,回滚范围只覆盖发生变化的部分。
最终可以按这条路径落地:内地及香港用户占主导,先验证香港;东南亚用户占主导,先验证新加坡;韩国用户或实时交互占主导,先验证韩国。用户分布平均时,以加权访问质量和业务价值判断;数据库单点写入明显时,优先考虑应用与数据库的距离;静态内容占比高时,重点看缓存未命中和回源;任何位置在正式切换前,都必须完成多来源网络测试、真实业务验证和可执行的 DNS 回滚。


