

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


单看CPU利用率,往往无法判断Debian上的Tomcat为什么变慢。CPU只有40%时,线程可能已经全部阻塞在数据库连接池;CPU达到90%时,也可能是频繁GC或业务计算,而不是Tomcat线程数太少。有效的Debian Tomcat性能调优策略,应把响应时间、吞吐量、错误率、JVM、线程池、磁盘、网络和数据库指标放在同一个测试时间窗口内观察。
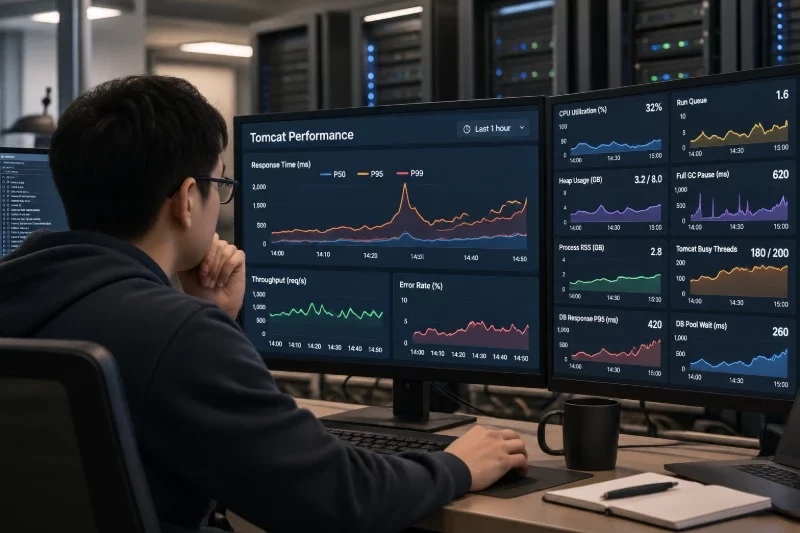
实际操作可以按以下顺序进行:先固定测试环境和请求模型,再记录基线;随后检查JVM内存与GC、Tomcat线程池和请求队列;最后通过CPU、内存、I/O、网络、应用代码和数据库指标的联动关系定位瓶颈。每次只调整一组相关参数,并在相同负载、相同数据集和相同预热条件下复测,才能知道优化是否真的有效。
测试前需要记录以下信息:
Debian软件包安装的Tomcat,服务名可能是tomcat9、tomcat10或其他名称;手工安装时则可能使用自定义的CATALINA_BASE。不要直接套用某个固定路径,先确认实际进程和服务配置:
java -version
systemctl list-units --type=service | grep -E 'tomcat|java'
systemctl cat tomcat10 2>/dev/null | sed -n '1,120p'
ps -ef | grep '[o]rg.apache.catalina.startup.Bootstrap'
找到Java进程PID后,后续命令中的PID替换为实际值。部分JVM诊断命令要求使用Tomcat服务账号执行,或者需要相应的读取权限。
压测请求必须尽量接近真实业务,单独访问一个静态健康检查接口,只能验证网络和容器是否可用,不能代表完整业务性能。至少需要固定以下条件:
-Xmx,或只改变maxThreads。如果使用wrk,可以在测试环境中对具有代表性的接口进行示例测试:
wrk -t4 -c50 -d5m --latency http://127.0.0.1:8080/your-endpoint
这里的接口、线程数和并发数只是示例,不应直接用于生产环境。写入型接口还需要考虑重复提交、数据回滚和测试数据污染。压测机不宜与Tomcat共用同一台主机,否则压测程序本身的CPU和网络消耗会干扰结果。
可以在压测前后分别采集系统状态:
vmstat 1 10
pidstat -p "$PID" -u -r -d 1 10
iostat -xz 1 10
ss -s
ps -o pid,ppid,%cpu,%mem,rss,vsz,etime,cmd -p "$PID"
如果系统没有pidstat或iostat,先确认是否安装了对应的系统监控工具,避免在业务高峰期临时安装或修改环境。
建议将基线整理成类似下面的记录:
| 指标 | 空闲状态 | 稳态压测 | 峰值阶段 | 需要关注的变化 |
|---|---|---|---|---|
| 吞吐量 | 0 | 420请求/秒 | 430请求/秒 | 是否随并发继续增长 |
| P95响应时间 | 120ms | 380ms | 2.1s | 长尾是否突然扩大 |
| HTTP错误率 | 0 | 0.1% | 3.5% | 是否与队列或超时同时出现 |
| 进程CPU | 5% | 48% | 52% | 是否接近CPU饱和 |
| Tomcat忙线程 | 8/200 | 145/200 | 200/200 | 是否触达上限 |
| Full GC暂停 | 0 | 40ms | 650ms | 是否与长尾时间重合 |
| 数据库P95耗时 | 20ms | 180ms | 1.7s | 是否主导请求耗时 |
表中的数据是用于说明分析方法的示例,不代表某台实际服务器的监控结果。真正有价值的是同一时间窗口内的变化关系。
Java进程占用的内存不等于Java堆。总进程内存通常还包括:
因此,-Xmx设置得越大不一定越好。若主机有8GB内存,给Java堆设置接近8GB,可能导致操作系统、文件缓存、线程栈和其他服务没有足够空间,最终出现交换或系统级内存压力。
判断JVM是否需要调优时,应同时观察堆使用率、Full GC、进程RSS和系统交换:
jstat -gcutil "$PID" 5000 12
pidstat -p "$PID" -r 1 10
free -h
vmstat 1 10
jstat -gcutil中的E和O分别反映年轻代和老年代使用比例,YGC、FGC和对应时间可以帮助判断GC频率。以下现象通常有不同含义:
-Xmx。si/so交换活动,进程RSS接近主机可用内存:优先解决系统内存压力,增加Java堆可能让问题更严重。可以把堆大小调整作为小步实验。例如当前峰值期间老年代在Full GC后仍保持较低水平,但年轻代回收频繁、暂停时间明显增加,可以适度增加堆空间;如果Full GC后老年代仍然接近满,则增加堆只能延后故障,不能解决对象长期存活或泄漏问题。
启动参数要与Java版本匹配。先查看:
java -version
jcmd "$PID" VM.flags
jcmd "$PID" VM.command_line
Java 11及以上可以参考以下形式配置G1和GC日志:
CATALINA_OPTS="${CATALINA_OPTS} -Xms2g -Xmx2g"
CATALINA_OPTS="${CATALINA_OPTS} -XX:+UseG1GC"
CATALINA_OPTS="${CATALINA_OPTS} -Xlog:gc*,safepoint:file=/var/log/tomcat/gc.log:time,uptime,level,tags"
这里的2g只是示例值,不是适用于所有主机的推荐值。日志目录必须已存在,并且Tomcat服务账号具有写入权限;否则JVM可能因无法打开日志文件而启动失败。Java 8使用的GC日志参数与Java 11的统一日志参数不同,不能未经核对直接混用。
修改前应备份现有启动配置,记录旧参数,确认修改影响的Tomcat实例。重启会中断当前连接,应安排在维护窗口或可接受的业务时段。若启动失败,恢复备份配置并重启服务即可回滚。
Tomcat常见的连接器参数包括:
maxThreads:处理同步请求的最大工作线程数;minSpareThreads:预留的空闲线程数;maxConnections:连接器允许管理的最大连接数;acceptCount:工作线程暂时无法处理时,操作系统监听队列可等待的连接数;connectionTimeout:连接等待超时时间。这些参数解决的不是同一个问题。maxConnections较大,并不意味着Tomcat能同时高效处理同样数量的请求;真正执行同步业务的线程仍受maxThreads限制。
应从JMX、监控系统或线程池指标中观察currentThreadsBusy、currentThreadCount、maxThreads和连接数。也可以通过线程栈了解工作线程是在计算、锁等待、数据库调用还是网络调用:
top -H -p "$PID"
jstack "$PID" > /tmp/tomcat-thread-$PID.txt
在线上高流量期间,jstack可能产生一定开销,建议在低风险时段执行,并连续间隔几秒采集两到三次,用于识别长期不变的阻塞栈。
如果忙线程长期接近上限,同时Tomcat队列增加,但CPU仍有余量、数据库连接池也没有耗尽,可以把maxThreads小幅提高,例如每次增加10%到20%,然后复测。
如果忙线程达到上限时,数据库P95已经从180ms上升到1.7秒,那么增加Tomcat线程通常只会让更多请求同时等待数据库,可能造成数据库连接耗尽和超时扩散。此时应先查SQL耗时、锁等待、连接池等待和数据库CPU,而不是继续扩大Tomcat线程池。
同样,如果Tomcat线程只有50/200,但请求仍然很慢,说明瓶颈很可能不在Tomcat工作线程上,可能是:
现有连接器配置可以按实际版本核对后小幅调整,示例形式如下:
不要在server.xml中重复添加一个监听同端口的Connector,而应修改现有配置。修改后要检查XML格式、端口占用和服务状态,并确认回滚文件可用。
单一指标只能提供线索,不能直接证明原因。下面的判断需要放在同一时间窗口中完成。
| 可能瓶颈 | 同时出现的指标组合 | 更可靠的判断方式 | 不应直接得出的结论 |
|---|---|---|---|
| CPU或应用计算 | CPU持续升高、运行队列增加、线程忙、GC稳定、数据库耗时稳定 | 对比热点接口、线程栈和CPU时间,确认是否为业务计算或锁竞争 | CPU高不等于必须增加Tomcat线程 |
| JVM内存或GC | RSS上升、Full GC增加、GC暂停与P99重合、交换活动增加 | 对比GC前后堆占用、老年代趋势和进程RSS | 堆使用率高不一定就是堆容量太小 |
| 磁盘I/O | iowait升高、磁盘await增加、队列变长、请求耗时同步上升 | 区分应用日志、GC日志、临时文件和其他进程的I/O | 磁盘利用率高不代表Tomcat代码一定慢 |
| 网络 | 客户端总耗时升高、服务端处理时间正常、重传或连接建立耗时增加 | 对比客户端分段耗时、代理日志和Tomcat服务端耗时 | 远端请求慢不能仅凭服务器CPU判断 |
| 应用代码或锁 | CPU、磁盘和数据库均不高,但特定接口P95异常、线程栈集中等待 | 多次线程栈采样,结合接口级日志或链路追踪 | 线程数多不代表系统处理能力强 |
| 数据库或连接池 | Tomcat忙线程增加、数据库耗时和连接池等待同步上升 | 对比SQL耗时、锁等待、连接池使用率和数据库资源 | 增大Tomcat线程不能替代数据库优化 |
CPU瓶颈通常不是“看到90%就结束判断”,而是需要同时观察运行队列、请求延迟和GC情况。
例如,压测期间进程CPU从50%升到92%,vmstat的r持续高于可运行CPU核数,GC暂停稳定,数据库P95仍保持在200ms左右,同时P95响应时间从300ms升到900ms,这更接近CPU或应用计算瓶颈。
如果CPU只有45%,但线程全部在等待数据库,那么增加CPU配额或Tomcat线程数都不会直接改善响应时间。
如果P50基本稳定,而P99偶尔跳高到数秒,且跳高时间与Full GC暂停重合,应优先检查GC,而不是只看平均响应时间。
一个典型示例是:压测前10分钟P95约400ms,Full GC暂停通常低于50ms;进入峰值后,P95升至2秒,GC日志中出现600ms级暂停,进程RSS同步增长。这时需要继续判断是堆不足、对象分配过快,还是老年代对象无法释放。
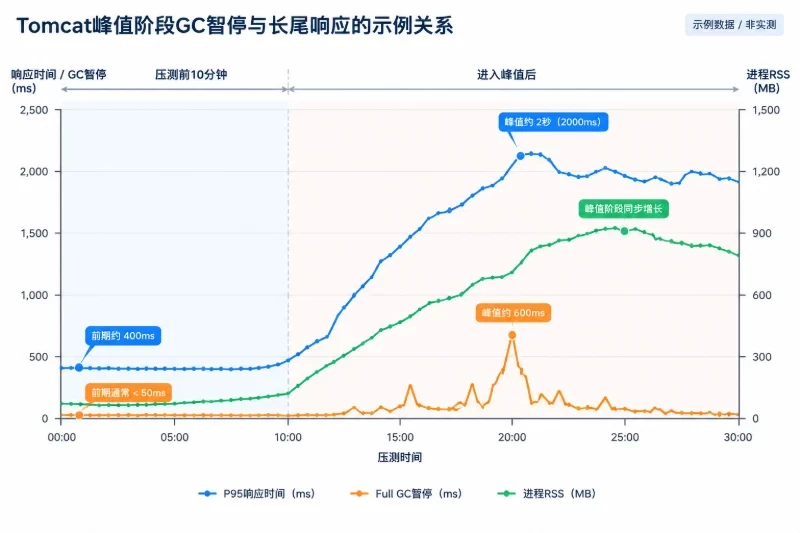
如果Full GC后老年代占用从80%降到78%,随后很快又回到85%,增加堆可能只能延长故障出现时间,应进一步检查缓存、会话、集合对象和第三方组件的对象保留情况。
iostat -xz中的await、设备利用率、队列长度和读写速率需要一起看。某个时段请求变慢,如果同时出现:
vmstat中的wa明显升高;await和队列长度上涨;那么磁盘I/O可能是主因。
日志量过大时,不应直接关闭所有日志。更稳妥的方式是先确认日志级别、滚动策略和磁盘剩余空间,在保留必要审计和错误信息的前提下减少无效输出,并安排配置变更和回滚方案。
客户端看到的总响应时间可以拆成连接建立、请求发送、服务端处理、响应传输等阶段。可以使用curl查看一次请求的分段耗时:
curl -sS -o /dev/null \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s starttransfer=%{time_starttransfer}s total=%{time_total}s\n' \
  http://127.0.0.1:8080/your-endpoint
如果本机请求的starttransfer和total都很低,但远端客户端的总耗时明显增加,应继续检查链路、代理、连接复用、重传和响应传输,而不能把问题归因于JVM。
反过来,如果本机请求的starttransfer已经很高,网络只是在等待Tomcat返回结果,重点应转向线程池、应用、GC和数据库。网络指标也要与服务器端请求处理时间对应起来,单独查看带宽使用率并不能证明网络是瓶颈。
响应时间可以用以下方式理解:
总响应时间 ≈ 排队时间 + 应用执行时间 + 数据库等待时间 + 其他下游调用时间 + 网络传输时间
这不是精确的监控公式,但适合建立排查思路。若Tomcat访问日志显示请求处理时间已经很长,而CPU、磁盘和网络均正常,应通过应用日志、线程栈或链路追踪继续拆分耗时。
数据库瓶颈常表现为:
应用线程池与数据库连接池需要匹配。比如Tomcat允许200个工作线程,而数据库连接池只有30个,超过30个并发数据库请求就可能排队。此时把Tomcat线程从200提高到400,通常只会扩大等待队列。
平均响应时间可能掩盖少量严重慢请求。建议至少同时观察:
例如:
| 现象 | 更可能的方向 |
|---|---|
| P50、P95、P99一起升高,CPU和运行队列同步升高 | CPU或整体容量不足 |
| P50稳定,P99偶发跳高,并与Full GC重合 | GC暂停或内存压力 |
| P50上升不大,P95和P99持续拉长,忙线程达到上限 | 排队、数据库或下游调用阻塞 |
| 服务端处理时间稳定,客户端总时间明显增加 | 网络、代理或响应传输 |
| 只有一个接口变慢,其他接口稳定 | 应用代码、SQL或该接口依赖的问题 |
场景一中,P95从350ms升到900ms,CPU从45%升到93%,运行队列持续增加;Tomcat忙线程从80/200升到180/200,GC暂停和数据库P95基本不变。这里更可能是CPU或应用计算不足。此时继续增加线程会带来更多上下文切换,应该先定位热点代码、锁竞争或高计算请求。
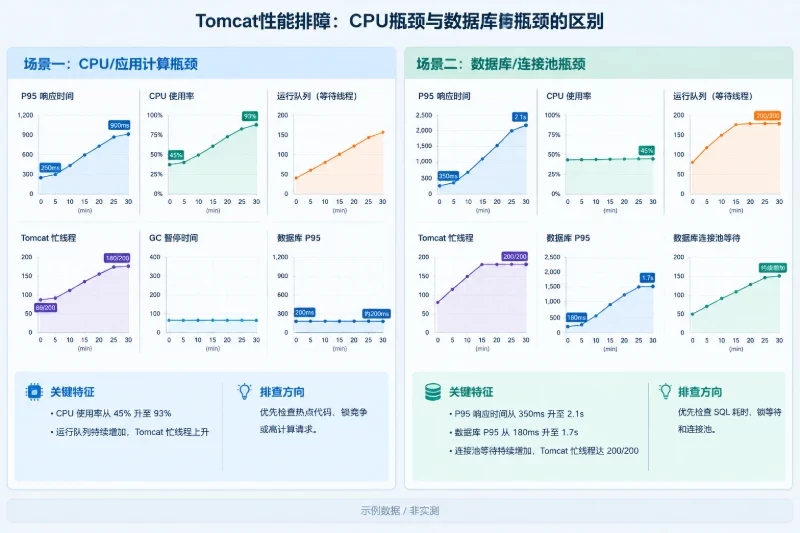
场景二中,P95从350ms升到2.1秒,CPU只有45%,Tomcat忙线程达到200/200,数据库P95从180ms升到1.7秒,数据库连接池等待也同步增加。这里的主因更接近数据库或数据库连接池,Tomcat线程池只是把下游等待暴露出来。直接把maxThreads提高到400,可能会让数据库承受更多并发请求,导致超时进一步扩大。
一次性能调整应包含完整的变更闭环:
maxThreads。服务验证可以使用:
systemctl status tomcat10 --no-pager
ss -ltnp | grep ':8080'
curl -fsS http://127.0.0.1:8080/your-endpoint
jcmd "$PID" VM.flags
实际服务名和端口需要替换为环境中的值。若服务启动失败,先查看systemctl status和对应日志,确认是否是参数版本不兼容、日志目录权限不足、XML格式错误或端口占用。
每次复测都要保持以下条件不变:JDK和Tomcat版本不变、数据库数据量不变、缓存预热方式不变、压测请求不变、测试时间段的外部流量尽量一致。否则即使响应时间发生变化,也无法判断变化是否来自本次调优。
不要只盯着某一个“优化后数值”。更有价值的组合是:
await + iowait + 日志/文件写入量:确认慢请求是否与I/O等待同步;当这些指标在相同时间窗口内一起变化,并且修改参数后能够在相同测试条件下重复出现或消失,才可以把判断从“可能原因”提升为较可信的瓶颈定位结果。


