

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


把分布式内存总量直接等同于可承载并发,通常会得到错误结论。在香港显卡服务器集群中,分布式内存首先解决的是“模型、KV Cache或中间数据能否放下”,而不是自动增加GPU计算能力;只有当原有瓶颈确实是显存或本地内存容量,并且远程内存访问延迟、互联带宽和调度开销仍在可接受范围内时,内存扩展才可能转化为更高的稳定并发。
判断方法应从同口径A/B测试开始:保持模型、量化精度、输入输出长度、请求分布和GPU数量不变,只改变KV Cache或其他数据是否放入分布式内存,然后同时观察吞吐、首Token延迟、单Token延迟、排队时间、GPU利用率和节点间带宽。若并发数增加但吞吐增长很小、尾延迟明显上升,说明得到的是“容量扩展”,而不是有效的“性能扩展”。
显卡服务器集群里的内存通常包括GPU显存、节点本地内存,以及通过节点间互联访问的远程内存。几台服务器的内存相加,并不意味着每张GPU都能以本地访问速度使用这部分容量。
分布式内存常见的作用有三类:
这三类用途的访问频率不同。权重分片可能在每一层计算时都参与通信;KV Cache在生成阶段会被持续读取;冷数据则可能只在会话切换或缓存命中时访问。访问越频繁,远程内存延迟和节点间带宽对推理性能的影响越明显。
因此,“分布式内存越大”只说明可放置的数据更多,不能直接推出以下结论:
推理服务中的并发,至少要区分三种含义:
把更多请求放进队列,会让“观测到的并发”增加,但不代表服务能力提升。常用的关系是:
并发数 ≈ 请求到达速率 × 平均响应时间
当系统接近饱和时,排队时间会快速上升,平均响应时间变长,即使请求数增加,实际吞吐也可能不再增长。因此容量规划不能只看连接数或并发数,应同时设定吞吐和延迟条件,例如:
如果GPU计算利用率已经接近上限,而显存仍有余量,继续增加分布式内存通常不会提升并发。相反,如果GPU计算利用率只有50%至70%,但显存因KV Cache不足而频繁驱逐请求,扩展内存才更可能带来收益。
下面用一组参考数据说明判断过程。它不是A5IDC实测数据,也不代表某个具体在售配置。
测试对象为一个四节点香港显卡服务器集群,每个节点配置一张24GB级GPU、128GB级本地内存,节点间使用100Gbps级互联。模型规模为7B至8B级,采用固定量化精度;每个请求的输入长度约为1024个Token,最大输出长度约为256个Token。
对照组只使用GPU显存保存活跃KV Cache;测试组允许部分KV Cache溢出到分布式内存。两组使用相同请求集合和相同解码参数,表中吞吐为集群聚合输出吞吐。
| 活跃并发 | 本地显存组吞吐 | 本地显存组p95首Token延迟 | 分布式内存组吞吐 | 分布式内存组p95首Token延迟 | 分布式内存组p95单Token延迟 | 远程带宽 |
|---|---|---|---|---|---|---|
| 4 | 58 Token/s | 150 ms | 55 Token/s | 165 ms | 41 ms | 约4 Gbps |
| 8 | 103 Token/s | 210 ms | 97 Token/s | 250 ms | 50 ms | 约14 Gbps |
| 16 | 显存不足 | 无法完成 | 140 Token/s | 430 ms | 67 ms | 约52 Gbps |
| 24 | 显存不足 | 无法完成 | 148 Token/s | 910 ms | 104 ms | 约78 Gbps |
这个反例包含三个容易被忽略的现象。
第一,分布式内存让测试组可以从8个活跃请求扩展到16个甚至24个请求,解决了显存不足问题。这说明它具备容量价值。
第二,从并发8增加到并发16时,吞吐从97 Token/s增加到140 Token/s,增幅约44%,但并发翻了一倍,首Token延迟也从250ms上升到430ms。此时不是每增加一个请求就获得相同比例的计算能力,而是多个请求在共享有限的GPU计算和内存带宽。
第三,从并发16增加到24时,吞吐只从140 Token/s增加到148 Token/s,增幅不足6%,但首Token延迟超过900ms,单Token延迟也明显恶化。继续增加内存容量并没有消除GPU计算、调度和互联带宽瓶颈。
如果服务目标是p95首Token延迟不超过500ms、p95单Token延迟不超过80ms,那么这个参考场景下的有效容量更接近16个并发请求,而不是24个。24个请求虽然能够被系统接收,但已经不适合作为稳定服务容量。
GPU显存通常具有更短的访问路径和更高的专用带宽。远程内存需要经过内存控制器、通信协议、节点间互联和软件调度。数据从远程位置取回后,GPU还可能需要等待数据到达。
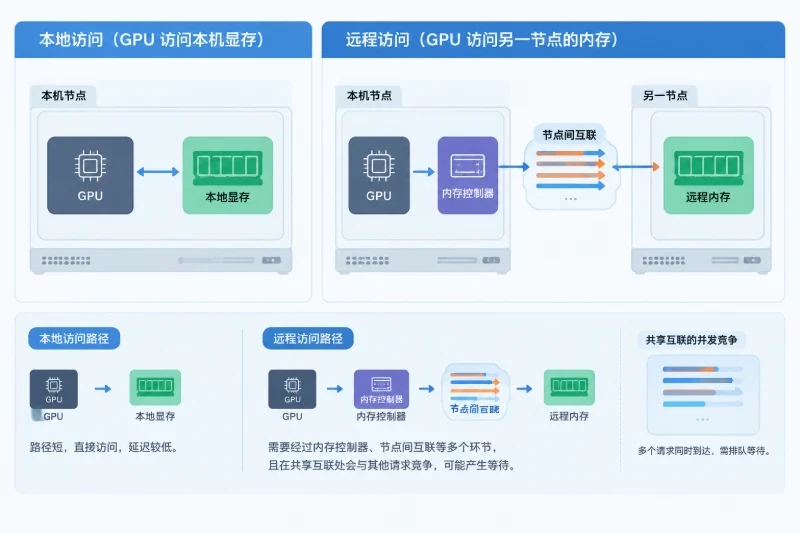
当请求较少、KV Cache访问不密集时,远程访问的额外延迟可能不明显;当并发提高后,多个请求同时读取远程数据,通信链路和队列会出现竞争,等待时间会被放大。
如果监控到远程流量为20GB/s,应先换算单位:
20GB/s × 8 = 160Gbps
这表示链路实际承载了约160Gbps的比特流量,还没有考虑协议开销和其他通信流量。不能把20GB/s与20Gbps直接比较,也不能只看远程内存总容量而忽略实际读写速率。
对自回归模型而言,输入阶段主要消耗计算资源和内存带宽,生成阶段则需要反复读取已有KV Cache并生成新的Token。分布式内存可以保存更多KV Cache,但每个Token仍然需要GPU完成注意力计算和解码计算。
当GPU计算资源成为瓶颈时,增加缓存只能让更多请求留在系统中,不能让GPU更快地产生Token。若远程KV Cache还需要频繁搬运,结果可能是GPU利用率不低,但有效吞吐增长有限,通信等待却持续增加。
如果分布式内存用于模型分片,而不是单纯保存溢出的KV Cache,部分计算可能需要在每层之间交换中间结果。此时模型虽然能够装入集群,但推理效率取决于:
模型越依赖跨节点同步,内存扩展对并发的促进作用就越不能脱离互联带宽单独评估。
分布式内存增加后,调度器需要决定数据放在哪个节点、何时迁移、哪些请求优先使用本地数据。如果请求被频繁迁移,或者某个节点承担了更多远程访问,可能出现一台节点的GPU和内存控制器已经拥堵,其他节点仍有空闲资源的情况。
因此,集群总内存利用率为60%,并不表示还有40%的内存能够立即转化为可用并发。应同时查看每个节点的本地显存、内存带宽、远程访问量和排队时间。
测试前需要固定以下变量,否则A/B结果无法比较:
短请求对远程内存的压力可能很小,长上下文和长输出请求则会显著放大KV Cache占用。因此,不能用短文本测试结果推断长上下文业务的容量。
固定并发测试用于观察资源随并发变化的曲线。可以依次测试1、2、4、8、16、24等并发档位,每个档位先预热,再持续运行一段时间。对短请求,可以运行数分钟;对长请求,应保证收集到足够多的完整请求,避免少量样本影响p99结果。
固定到达速率测试用于观察真实业务容量。逐步提高每秒请求数,记录排队时间是否增长、延迟是否失控,以及错误率是否上升。固定并发测试可能掩盖队列问题,而固定到达速率测试更容易找到稳定容量上限。
两种测试都应至少重复数次,并分别记录中位数、p95和p99。只看平均值,容易把少量严重慢请求隐藏起来。
| 指标 | 判断重点 |
|---|---|
| 聚合输入、输出Token吞吐 | 判断增加内存后是否真的处理了更多工作 |
| p50/p95/p99首Token延迟 | 判断排队和首轮计算是否恶化 |
| p50/p95/p99单Token延迟 | 判断生成阶段是否受到缓存或通信影响 |
| GPU计算利用率 | 判断瓶颈是否在计算 |
| GPU显存使用量与驱逐次数 | 判断是否存在容量不足 |
| 本地内存带宽 | 判断缓存是否压满节点本地内存 |
| 远程内存读写带宽 | 判断扩展内存是否造成通信压力 |
| 节点间链路利用率和重传 | 判断互联是否成为瓶颈 |
| 请求排队时间 | 区分真正处理能力和单纯排队 |
| 错误、超时和取消率 | 判断该并发是否可作为生产容量 |
GPU利用率高不一定代表计算效率高。如果同时存在较高的通信等待和远程带宽占用,GPU可能是在等待数据后短时间集中计算。应结合计算利用率、内存带宽和通信等待时间一起判断。
容量规划应先把请求量转换成Token量。若峰值请求速率为每秒3个请求,平均每个请求输入1200个Token、输出300个Token,则:
KV Cache的大致容量与以下因素相关:
可用一个简化关系估算单条序列的KV Cache:
KV Cache容量 ≈ 2 × 层数 × KV头数 × 头维度 × 每元素字节数 × Token数
这是容量估算式,不是最终分配值。实际系统还要加入块管理、对齐、缓存副本和安全余量。得到总需求后,应先扣除模型权重、运行时工作区和系统预留,再判断有多少空间可以用于活跃KV Cache。
如果本地显存只能容纳8个长上下文请求,分布式内存可能把可驻留请求提高到16个,但这并不表示GPU能以两倍速度生成Token。应将“可驻留并发”和“满足延迟目标的稳定并发”分别记录。
可以按下面的方式解释测试结果:
| 观察到的现象 | 更可能的瓶颈 | 分布式内存的作用 |
|---|---|---|
| 显存接近上限、GPU计算利用率中等、出现缓存驱逐 | 显存容量 | 可能提高可驻留并发,但要验证远程访问延迟 |
| GPU计算利用率长期接近上限、显存尚有余量 | GPU计算能力 | 单纯增加内存通常无效 |
| 远程带宽持续升高,p95单Token延迟同步上升 | 节点间互联或远程内存 | 继续增加容量可能放大延迟 |
| GPU利用率不高,CPU或调度线程繁忙 | 请求管理或数据准备 | 需要先检查调度、序列化和批处理效率 |
| 平均吞吐增加,但p99延迟和超时率快速上升 | 已超过稳定容量 | 不能把该并发作为生产容量 |
| 总内存利用率不高,但单个节点频繁等待 | 负载不均或数据放置不合理 | 应优化分片和放置,而不是简单加内存 |
一个实用的容量上限应满足三个条件:吞吐随请求增加仍有增长空间;p95和p99延迟处于业务目标内;连续测试期间没有持续排队、超时、内存驱逐或通信重传。只要其中一项明显失控,该并发档位就只能作为压力极限,不能作为交付容量。
分布式内存更适合以下场景:
它不适合被当作以下问题的通用解决方案:
在交付或扩容验收时,至少应明确每个节点的可用显存、可用于KV Cache的容量、远程内存访问延迟、可持续远程带宽、目标并发下的p95/p99延迟,以及出现内存不足时的降级行为。测试应在模型版本、请求长度和并发分布发生变化后重新执行;如果平均输入长度、输出长度或峰值请求速率增加,原有容量结论不能直接沿用。
分布式内存真正带来的价值,是在容量不足时扩大可服务数据集和可驻留请求数。只有当GPU计算、缓存访问、节点间带宽和调度延迟同时留有余量,并且测试结果仍满足延迟目标时,这种容量扩展才会转化为有效并发提升。


