

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


单次 ping 显示的延迟,并不能直接证明香港 CN2 优化线路服务器异常。判断是否正常,应把客户端探测结果与服务器访问日志、应用耗时、TCP 连接状态和 CPU、内存、I/O 指标放在同一时间线上比较。只有当多个测试点、多个时间窗口都出现网络侧延迟升高,并且服务器端处理耗时没有同步增加时,才更接近线路或路径问题。
如果从中国大陆固定测试点访问香港服务器,示例性的参考范围可以这样理解:中位数延迟约 20~60ms、95 分位约 40~90ms,通常属于较平稳的表现;中位数达到 60~100ms,或者高峰期 95 分位超过 100ms,需要结合运营商、测试地点和丢包判断;持续超过 100~150ms,且多个测试点同时升高,就不应只归因于正常抖动。上述数值只是判断入口,不是 CN2 线路的统一合格标准。
用户看到的页面打开时间,通常由多个阶段组成:
总耗时 ≈ DNS解析 + TCP连接 + TLS握手 + 网络往返 + 服务端排队/处理 + 响应传输
其中任何一段变慢,最终表现都可能是“服务器延迟高”。例如:
ping 从 40ms 上升到 110ms,说明 ICMP 探测的往返时间变长,但不一定等同于 HTTPS 请求也增加 70ms。ping 一直稳定在 45ms,而接口响应从 100ms 变成 800ms,问题更可能在应用、数据库、磁盘或并发排队。因此,日志定位的第一目标不是找一个“异常数字”,而是判断延迟增加发生在哪一层。
如果香港服务器使用 Nginx 作为 Web 服务或反向代理,最有价值的字段通常包括以下内容:
| 字段 | 含义 | 重点判断 |
|---|---|---|
$time_iso8601 | 请求完成时间,带时区 | 与客户端探测、系统监控对齐时间 |
$request_id | Nginx 请求标识 | 将一次请求关联到应用日志 |
$remote_addr | 客户端地址 | 区分不同测试点或运营商来源 |
$request | 请求方法和路径 | 判断是否为同一个接口或页面 |
$status | HTTP 状态码 | 区分正常响应、超时和错误 |
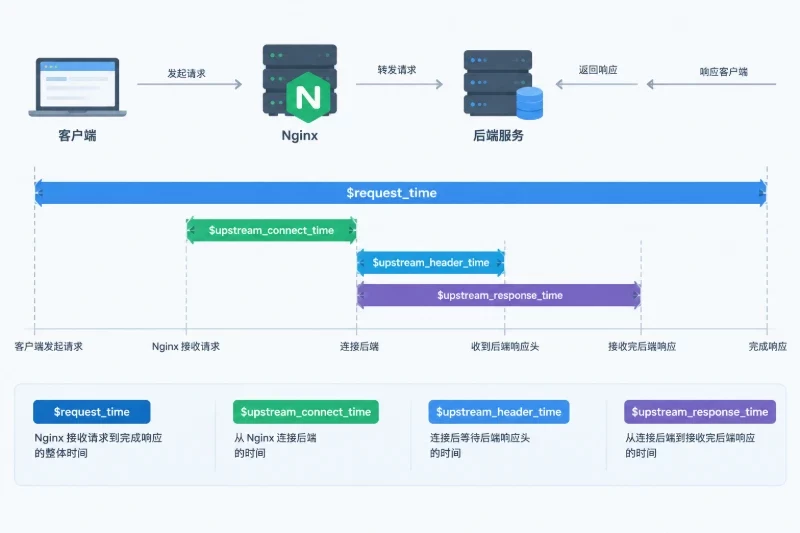
$request_time | Nginx 从接收请求到完成响应的总时间 | 判断服务端整体耗时 |
$upstream_connect_time | Nginx 与后端建立连接的时间 | 判断后端连接、监听队列或连接资源 |
$upstream_header_time | 建立后端连接到收到后端响应头的时间 | 判断后端排队和业务处理 |
$upstream_response_time | 从后端连接到接收完后端响应的时间 | 判断后端响应及传输过程 |
$upstream_addr | 实际访问的后端地址 | 确认是否命中不同后端 |
$upstream_status | 后端返回状态码 | 判断后端是否超时或异常 |
$bytes_sent | 返回给客户端的字节数 | 排查大响应造成的传输耗时 |
重点比较四个时间字段:
$request_time
$upstream_connect_time
$upstream_header_time
$upstream_response_time
$request_time 高而 $upstream_* 都低,可能是客户端接收慢、响应体较大、连接发送受阻,或者请求在 Nginx 层等待。$upstream_header_time 高,通常说明后端应用、数据库或内部队列耗时;$upstream_connect_time 高,则要检查后端连接建立、连接池、监听队列和后端服务状态。
如果当前日志没有这些字段,可以在 Nginx 的 http 配置块中增加一套独立日志格式。下面是 Linux 环境、Nginx 反向代理场景的示例:
log_format latency '$time_iso8601 '
                   'request_id=$request_id '
                   'diag_id=$http_x_diag_id '
                   'client=$remote_addr '
                   'request="$request" '
                   'status=$status '
                   'request_time=$request_time '
                   'upstream_addr=$upstream_addr '
                   'upstream_status=$upstream_status '
                   'upstream_connect_time=$upstream_connect_time '
                   'upstream_header_time=$upstream_header_time '
                   'upstream_response_time=$upstream_response_time '
                   'bytes_sent=$bytes_sent';

access_log /var/log/nginx/access_latency.log latency;
修改前应备份当前 Nginx 配置。配置保存后先执行语法检查,再平滑加载:
sudo nginx -t
sudo systemctl reload nginx
reload 通常不会中断已有连接,但仍应在业务低峰操作。若检查失败,不要继续加载;恢复原配置后重新执行 nginx -t。不同发行版的配置文件路径可能不同,应以 nginx -T 输出的实际路径为准。
Nginx 只能说明请求在网关层花了多少时间,不能解释业务代码内部的每一步。应用日志至少应记录:
例如一次请求的应用日志可以整理为:
2026-10-02T10:15:13.420+08:00 request_id=abc123
queue_wait_ms=4
db_time_ms=18
service_time_ms=36
retry_count=0
total_time_ms=61
如果 Nginx 的 request_time 为 65ms,而应用 total_time_ms 为 61ms,说明主要耗时确实发生在应用处理阶段,线路并不是首要嫌疑。反过来,如果 Nginx 只记录 70ms,客户端却测到 180ms,就要继续检查 DNS、TCP、TLS、响应传输和客户端所在网络。
网络日志不能替代主机资源监控。延迟升高时,应同时查看同一时间段的:
await、利用率和 I/O 等待;Linux 上可以使用以下只读命令进行快速观察,命令本身不会修改配置:
vmstat 1 5
iostat -xz 1 5
ss -s
如果需要查看 HTTPS 端口的 TCP 连接状态,可以根据实际端口执行:
ss -tin 'sport = :443'
iostat 由 sysstat 软件包提供,未安装时不要直接根据命令失败判断磁盘异常。若看到 CPU 长时间接近饱和、运行队列明显升高,或者磁盘 await、I/O 等待在延迟升高时同步增加,应优先排除服务器容量问题。CPU 80%~90% 以上、持续交换内存、磁盘利用率长期接近满载都可以作为调查信号,但不能单独作为线路故障结论。
客户端探测时,可以给 HTTP 请求增加一个临时诊断标识,使它出现在 Nginx 日志和应用日志中:
curl --http1.1 -sS -o /dev/null \
  -H 'X-Diag-ID: hk-latency-001' \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' \
  https://your-domain.example/health
上面的域名、路径和诊断标识应替换为实际业务值。/health 接口必须确实存在,并且不能因为缓存、权限或业务逻辑与真实接口完全不同。
命令输出中的字段分别对应:
time_namelookup:DNS 解析完成时间;time_connect:TCP 连接完成时间;time_appconnect:TLS 握手完成时间;time_starttransfer:收到首字节的时间;time_total:完整响应结束时间。客户端时间、Nginx 时间和应用时间必须使用同一时区,最好都采用带时区的 ISO 8601 格式。若服务器时间明显漂移,时间线会出现“客户端先发起、服务器却更早记录”的假象,应先检查系统时间同步状态。
不要只在一台电脑上连续执行一次 ping。测试时至少记录:
ICMP 测试可以使用:
ping -c 30 -i 0.2 your-server-ip
路径观察可以使用:
mtr -rwzc 100 -i 0.2 your-server-ip
如果关注的是 HTTPS 访问,建议再针对实际服务端口执行 TCP 路径测试,例如:
mtr -rwc 100 -T -P 443 your-domain.example
不同版本的 mtr 参数可能略有差异,可以先执行 mtr --help 核对。中间路由器不响应 ICMP 或限制探测,并不等于真实丢包;应重点看最终目标的丢包和延迟。如果只有某一个中间跳显示 50% 丢包,而后续跳和最终目标正常,通常不能据此判定线路故障。
| 观测结果 | 更可能的原因 | 下一步检查 |
|---|---|---|
ping、TCP 连接时间同时升高,Nginx 的后端耗时较低 | 客户端到香港服务器的路径、拥塞或丢包 | 更换测试点,比较多个运营商和时间段 |
ping 正常,request_time 和 upstream_header_time 同时升高 | 应用排队、数据库慢查询或后端依赖变慢 | 查看应用耗时、数据库和线程池 |
ping 正常,upstream_connect_time 升高 | 后端连接池、监听队列或后端服务异常 | 查看 ss -s、后端进程和连接上限 |
request_time 高,但后端时间低、响应字节数很大 | 返回内容传输慢或客户端接收窗口受限 | 比较小响应和大响应,查看网卡吞吐 |
| 只有首次请求慢,复用连接后正常 | DNS、TLS、冷连接或冷启动 | 分开比较首次请求和保持连接请求 |
| 只有一个测试点延迟升高 | 测试点本地网络、运营商出口或区域路径问题 | 更换同运营商和不同运营商测试点 |
| 多个测试点同时升高,且目标端丢包增加 | 路径或线路侧问题的可能性增加 | 对比历史基线,并向服务商提交时间段和测试证据 |
| 客户端显示超时,但 Nginx 没有对应日志 | 请求未到达 Nginx,或在前置设备处失败 | 检查端口连通性、前置负载均衡和安全策略 |
以一组示例数据说明判断过程:
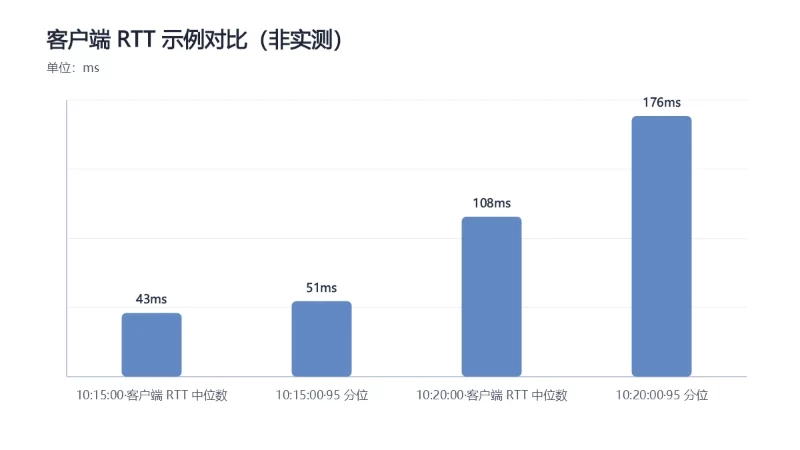
10:15:00  客户端 RTT 中位数:43ms,95 分位:51ms
10:15:13  Nginx request_time:0.068s
10:15:13  upstream_connect_time:0.004s
10:15:13  upstream_header_time:0.058s
10:15:13  应用 total_time_ms:56
10:15:13  数据库耗时:41ms
这组数据中,网络探测稳定,Nginx 和应用的耗时基本一致,主要时间花在数据库查询上。即使用户感知到接口响应变慢,也不能直接归因于香港线路。
另一组数据如下:
10:20:00  客户端 RTT 中位数:108ms,95 分位:176ms
10:20:13  Nginx request_time:0.074s
10:20:13  upstream_connect_time:0.003s
10:20:13  upstream_header_time:0.052s
10:20:13  应用 total_time_ms:49
这里服务端处理仍然较快,但客户端到服务器的探测已经明显升高。如果多个独立测试点在同一时间段得到类似结果,才有理由进一步调查路径变化、丢包和线路状态。
“正常”必须结合业务目标,而不是只看香港服务器所在地。可以用以下方式制定判断边界:
如果业务要求首字节时间不超过 200ms,可以先拆分预算:
目标 TTFB:200ms
DNS、TCP、TLS:约 50ms
服务端排队和业务处理:约 80ms
可留给网络路径和其他波动的空间:约 70ms
这只是预算示例。若应用本身的 95 分位处理时间已经达到 150ms,即使线路 RTT 只有 40ms,整体请求仍可能超过目标。此时更换线路未必能解决问题。
大文件、长轮询和持续连接不能只用一次 RTT 判断。还要观察:
例如中位数只有 45ms,但 99 分位经常超过 500ms,说明平均体验可能不错,却存在明显的尾延迟。对支付、接口调用或实时交互业务,尾延迟往往比平均值更值得关注。
香港 CN2 优化线路服务器怎么选,不能只看“CN2”或“优化线路”的名称,也不能只询问一个最低延迟。更可靠的验收记录应包括:
curl 分段耗时与服务器 request_time 的对应关系。可以采用这样的条件化判断:
完成一次调整后,应在相同测试点、相同端口、相同请求路径和相近业务负载下复测。只有客户端网络指标、服务器日志和系统监控三者在同一时间线上都改善,才能确认问题确实得到解决;否则,单纯看到某一次 ping 下降,并不足以证明香港服务器线路已经恢复正常。


