香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


把“CPU超过80%就报警”作为香港服务器的唯一规则,判断往往并不完整。CPU短时升高可能只是编译、备份或流量波动;内存“已用较高”也可能只是Linux主动利用空闲内存做缓存;磁盘空间没有用满,更不代表磁盘I/O正常。更可靠的做法是同时采集CPU、内存和磁盘的容量、压力、趋势与关联指标,再通过持续时间、分级阈值和恢复阈值减少无效告警。
实际配置时,可以先为香港服务器建立正常业务时段的基线,再设置“预警—严重—恢复”三级条件:CPU关注使用率、负载和iowait,内存关注available、交换活动和内存回收压力,磁盘同时关注空间、inode、I/O延迟和增长速度。单项指标适合提示趋势,多项指标持续异常才更适合作为需要立即处理的告警。
CPU使用率高只能说明处理器正在忙,并不能直接说明业务已经故障。需要进一步区分:
user较高:可能是应用进程计算量增加。system较高:可能是系统调用、网络处理或文件操作增多。iowait较高:CPU正在等待磁盘或其他I/O完成,问题重点可能在存储,而不是CPU核心数量。steal较高:虚拟化环境中,虚拟机等待宿主机分配处理器时间,单靠重启应用通常不能解决。因此,CPU告警至少应与负载、进程状态或业务响应时间中的一项结合。对于多核服务器,负载平均值还要结合逻辑CPU数量判断,不能把load average直接当成百分比。
Linux会将空闲内存用于页缓存和文件缓存,所以free或监控平台中的“已用内存”较高,并不必然表示内存不足。更有判断价值的是:
MemAvailable或同等含义的可用内存;如果可用内存仍然充足,交换活动很低,业务也没有响应变慢,只因为“已用内存超过某个百分比”就告警,通常会产生较多噪声。
磁盘问题至少分为三类:
因此,磁盘监控不能只看/分区的使用率。数据库、日志目录、容器数据目录或业务上传目录可能位于独立挂载点,必须分别监控。
在设置阈值之前,先确认香港服务器的操作系统、虚拟化方式、挂载点和业务运行时段。阈值不是由服务器所在地决定的,而是由应用类型、资源规格、业务峰值和可接受的响应时间共同决定。
监控对象应分成三层:
如果只监控主机层,可能看到CPU正常,却不知道应用已经停止;如果只监控服务层,又可能错过磁盘即将写满等前兆。
采集基线时,不要只观察业务低峰。应覆盖:
可以分别记录正常时段的平均值和较高分位值。平均值适合描述常态,较高分位值更适合判断“正常高峰是否会被误报”。如果业务存在明确的周周期,应覆盖多个完整周期后再确定阈值。
CPU短时尖峰适合较短采样间隔,但容量趋势没有必要每秒计算。实际配置时,可以将资源采样、趋势统计和告警评估分开:
采样过于频繁也会增加监控代理和服务器本身的开销,尤其是在磁盘目录扫描、进程明细采集或大量挂载点监控时。
| 资源 | 首要指标 | 辅助指标 | 判断重点 |
|---|---|---|---|
| CPU | 使用率、负载平均值 | user、system、iowait、steal、运行队列 | 是否持续繁忙,是否已经影响服务 |
| 内存 | 可用内存比例 | 交换读写、主要缺页、OOM记录、进程工作集 | 是否存在真实内存压力 |
| 磁盘容量 | 文件系统可用空间 | inode、增长速度、挂载点 | 是否会在维护窗口前耗尽 |
| 磁盘性能 | I/O等待、读写延迟 | 队列长度、吞吐、设备利用率 | 是否出现存储拥塞 |
| 监控本身 | 采集成功率、最后更新时间 | 心跳、代理进程状态 | 告警是否因为监控链路中断 |
下面的数值只能作为初始校准值,不能视为所有香港服务器都适用的固定标准。正式启用前,应根据基线、业务响应时间和资源余量调整。
| 指标 | 预警起点 | 严重起点 | 配套条件 |
|---|---|---|---|
| CPU使用率 | 持续约70%~80% | 持续约85%~95% | 同时观察负载、iowait或业务延迟 |
| 可用内存 | 低于约15% | 低于约10% | 严重级别最好伴随交换活动或内存回收压力 |
| 文件系统可用空间 | 低于约20% | 低于约10% | 同时检查绝对剩余空间和增长速度 |
| inode可用比例 | 低于约15% | 低于约5% | 大量小文件场景必须单独监控 |
| I/O延迟 | 高于正常基线 | 持续高于基线且业务变慢 | 不建议脱离设备类型和业务负载设置统一毫秒值 |
这里的“持续”比单个百分比更重要。例如,CPU达到90%仅持续几十秒,通常应记录为趋势;如果在业务高峰期间持续十分钟,同时负载上升、应用响应变慢,就应进入严重处理流程。
磁盘空间还应设置绝对值条件。对于容量较大的文件系统,剩余10%可能仍然很多;对于小容量系统,剩余10%可能很快耗尽。更稳妥的逻辑是:
当可用空间比例低于阈值,或可用空间低于业务运行所需的绝对余量,或按近期增长速度将在下一次维护窗口前耗尽时,触发告警。
增长速度不稳定时,不要仅凭短时间外推。日志轮换、临时文件清理和批量导入都可能造成明显的短期波动。
以下命令适用于常见Linux发行版,主要用于只读检查。命令本身不会修改业务数据,但iostat通常需要系统安装sysstat工具包;如果命令不存在,应按照当前发行版的软件包管理规范安装,不要直接复制不适用的安装命令。
date
nproc
uptime
free -h
vmstat 1 5
df -hT
df -ih
iostat -xz 1 3
可以按下面的方式理解结果:
nproc:查看逻辑CPU数量,用于辅助解释负载平均值。uptime:查看load average。应结合逻辑CPU数量和业务并发判断。free -h:重点看available,不要只看used。vmstat 1 5:重点关注运行队列、交换读写和wa。持续出现交换读写,说明内存或内存回收压力需要进一步检查。df -hT:查看各文件系统容量、可用空间和文件系统类型。df -ih:查看inode是否接近耗尽。iostat -xz 1 3:查看设备延迟、队列和利用率。需要结合业务读写模式判断,不能只看单一的设备利用率字段。如果需要找出CPU或内存占用较高的进程,可以进行只读排序:
ps -eo pid,ppid,comm,%cpu,%mem --sort=-%cpu | head -n 15
ps -eo pid,ppid,comm,%cpu,%mem --sort=-%mem | head -n 15
这些命令只能说明当时哪些进程占用较多资源,不能单独证明该进程就是故障根因。还应对照进程日志、请求量和业务响应情况。
“超过阈值立即通知”是无效告警的主要来源之一。应将触发条件写成:
例如,CPU超过预警线持续数分钟可以发送普通告警;只有超过严重线并且业务延迟同步升高,才通知更高等级的值班人员。持续时间应根据业务容忍度设置,实时交易类服务和离线批处理服务不应使用同一套规则。
如果触发阈值和恢复阈值相同,指标在临界点附近波动时会反复发送“恢复—故障—恢复”通知。应使用回差:
不同监控平台对恢复阈值的配置名称不同。如果平台不支持单独的恢复线,可以通过记录窗口、连续样本或二次确认规则实现类似效果。
单指标告警适合做预警,但严重告警应尽量结合第二个信号:
iowait高,同时磁盘延迟和队列都升高。这不是要求所有故障必须同时满足多个条件,而是避免把资源利用率升高直接等同于服务故障。对于明显的硬阈值,例如文件系统已经只剩极少空间,可以保留单条件严重告警。
如果监控平台使用Prometheus风格的指标和规则,可以将下面的示例作为结构参考。示例中的阈值是初始值,实际使用前必须核对采集器输出的指标名称、标签和挂载点过滤条件。
groups:
  - name: host-resources
    interval: 30s
    rules:
      - alert: HostCpuHigh
        expr: |
          100 * (
            1 - avg by (instance) (
              rate(node_cpu_seconds_total{mode="idle"}[5m])
            )
          ) > 85
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "主机CPU持续偏高"
          description: "CPU使用率超过预警线并持续10分钟,请结合负载、iowait和业务延迟判断。"

      - alert: HostMemoryAvailableLow
        expr: |
          100 * node_memory_MemAvailable_bytes
          / node_memory_MemTotal_bytes < 10
        for: 10m
        labels:
          severity: critical
        annotations:
          summary: "主机可用内存偏低"
          description: "可用内存持续低于预设比例,请检查交换活动、主要缺页和进程工作集。"

      - alert: HostFilesystemSpaceLow
        expr: |
          100 * node_filesystem_avail_bytes
          / node_filesystem_size_bytes < 10
          and node_filesystem_readonly == 0
        for: 15m
        labels:
          severity: critical
        annotations:
          summary: "文件系统可用空间偏低"
          description: "请确认具体挂载点、inode和近期增长速度,避免只根据根目录判断。"
配置时应特别注意以下问题:
for只解决持续时间问题,不能替代恢复阈值、告警分组和业务关联。| 观察到的组合 | 更可能的方向 | 验证方式 |
|---|---|---|
CPU使用率高,user高,运行队列也高 | 应用计算量或并发增加 | 查看高占用进程、请求量和业务延迟 |
CPU使用率不高,但iowait和磁盘延迟高 | 存储读写等待 | 对照iostat的延迟、队列和读写吞吐 |
| 可用内存持续下降,交换读写增加 | 内存压力或进程工作集增长 | 查看free、vmstat、进程内存和内核记录 |
| 磁盘空间持续下降,inode正常 | 文件内容增长或日志积累 | 对照挂载点、目录增长速度和轮换策略 |
| 空间仍有余量,但inode接近耗尽 | 大量小文件 | 使用df -ih确认具体挂载点,再定位文件来源 |
| 监控突然没有所有指标 | 采集代理、主机或监控链路异常 | 先检查心跳和采集状态,不要直接推断资源已满 |
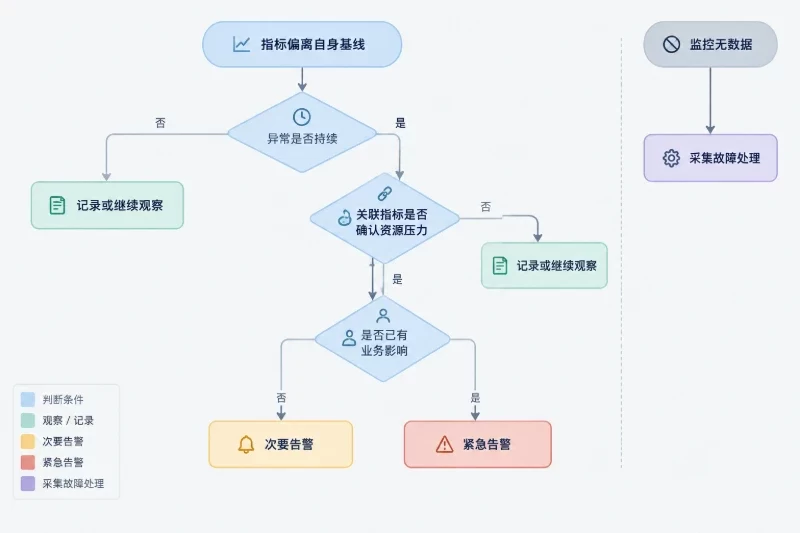
“监控无数据”应作为独立的采集故障处理,不能自动转换成CPU、内存或磁盘告警。否则监控平台本身中断时,值班人员会收到大量没有依据的资源故障通知。
同一台香港服务器上,多个挂载点同时空间不足,或者一个主机的多个服务因内存压力共同异常时,应按主机、资源类型和事件时间进行分组。通知内容中保留具体挂载点和受影响服务,但不要为每一个相同根因发送独立消息。
所有指标都可以保留在监控图表中,但不是所有指标都需要即时通知。可以将事件分为:
这样既不会丢失历史信息,也不会让值班人员被大量低价值消息淹没。
如果备份、日志压缩或数据导入会定期产生已知峰值,可以设置带结束时间的维护静默,而不是永久关闭告警。静默结束后仍需确认资源是否恢复。对于时间不固定或持续时间不可预测的任务,优先使用持续窗口和业务关联条件,不要简单屏蔽整个资源指标。
例如磁盘空间不足可能同时导致应用写入失败、日志报错和服务响应变慢。告警系统可以保留这些关联信息,但通知层应指定一个主告警,并将其他事件作为关联事件展示。这样既能保留排查线索,又能避免重复升级。
如果香港服务器运行在虚拟化环境中,应额外观察steal等指标;当虚拟机等待宿主机调度时,应用进程本身可能没有异常。此时应先确认是否为主机侧资源争用,再决定是否调整应用。
如果使用容器,还要同时区分主机内存和容器内存限制。主机可用内存尚可,并不代表某个容器没有达到自己的限制;反过来,单个容器重启也不一定说明整台主机内存不足。
如果是Windows系统,Linux命令和/proc类指标不适用,应通过性能监视器采集处理器总使用率、可用内存、逻辑磁盘剩余空间、磁盘传输延迟等对应计数器,再按照同样的原则设置持续时间、关联条件和恢复阈值。
最终,阈值应服务于“提前发现可处理的问题”,而不是追求告警数量。对香港服务器而言,最稳妥的判断路径是:先看指标是否偏离自身基线,再看异常是否持续,随后用关联指标确认是否已经形成资源压力,最后结合业务影响决定告警等级。只有在这些条件成立时,CPU、内存和磁盘告警才真正具备行动价值。