

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


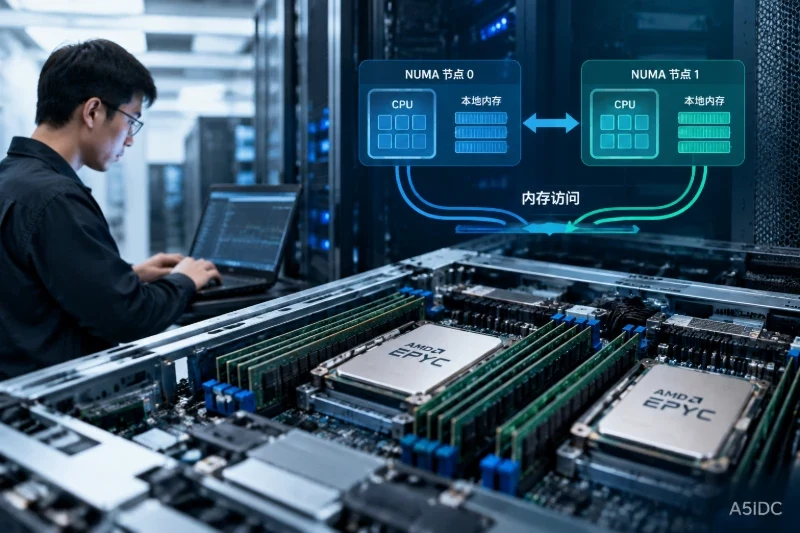
参数不等于体验。在日本AMD服务器上,EPYC的核心数量、频率和标称内存容量只能说明计算资源的上限,不能直接推导出多核业务的实际吞吐。真正决定结果的,往往是线程运行在哪个NUMA节点、数据首次分配到哪个节点,以及多个线程是否同时争用同一组内存控制器。
NUMA影响多核性能的核心原因是:每个CPU节点都有更近的本地内存,也可能需要通过Infinity Fabric访问远端内存。线程访问本地内存时路径更短、带宽竞争更容易控制;访问远端内存时,需要经过片间互连或处理器间互连,延迟、链路占用和缓存一致性开销都会增加。测试时应先确认服务器实际暴露的NUMA拓扑,再通过本地、远端和交错分配三组结果判断影响,而不是只看CPU总核心数。
在操作系统看来,NUMA节点是可以分别进行CPU和内存绑定的资源区域。双路EPYC服务器通常至少会体现出与Socket相关的NUMA距离;在支持NPS模式的单路或双路平台上,一个Socket还可能被划分为多个NUMA节点。
EPYC内部的CCD、CCX、IOD和内存控制器属于更底层的硬件结构:
因此,不能看到EPYC采用多芯粒设计,就直接把每个CCD当作一个NUMA节点。判断依据应以操作系统报告的节点、CPU列表和内存归属为准。
部分EPYC平台提供NPS(NUMA Per Socket)选项。在平台和固件支持的前提下,常见的NPS1、NPS2或NPS4会改变一个Socket被划分为几个NUMA域。
其影响可以这样理解:
NPS的具体可选项和行为取决于EPYC型号、主板固件和内存配置。选择日本AMD服务器时,不能只询问“是否为EPYC”,还应确认实例或裸机实际向操作系统暴露了几个NUMA节点。
内存通道决定同一个内存节点能同时处理多少数据请求。多线程程序即使全部运行在本地节点,如果线程数量继续增加,仍然可能先达到内存控制器或通道的带宽上限。
这意味着:
BIOS中的通道交错、Socket级内存交错和NPS配置不能混为一谈。通道交错通常用于提高一个节点内部的带宽利用率;跨节点交错则可能让数据分布更平均,但也会让单次访问不再始终落在本地内存。
一个核心执行加载或存储指令时,通常先查询缓存。只有在目标数据不在相应缓存层级,或者数据被其他核心修改后需要重新获取时,访问才会继续向内存系统发出请求。
在简化情况下,访问路径可以分为两类:
第一种情况称为本地内存访问。第二种情况称为远端内存访问。远端不一定意味着跨物理服务器,也可能只是同一个Socket内部的另一个NUMA域。
远端访问产生影响的原因主要有三点:
在单线程、缓存命中率很高的任务中,这些差异可能不明显;在大数据集、随机访问或多线程内存带宽测试中,差异会被放大。
Linux通常采用first-touch策略:匿名内存页在首次被某个线程实际写入时,倾向于分配到该线程所在的NUMA节点。
这会造成一个常见现象:
因此,单纯给进程增加线程数并不能保证内存访问自动均衡。初始化线程的位置、并行初始化方式、线程亲和性和内核的自动NUMA平衡策略,都会影响最终结果。
文件映射、页缓存、透明大页和内存回收也可能改变页面位置。测试时如果没有记录这些条件,同一台日本AMD服务器的两次结果也可能出现偏差。
| 参数或现象 | 主要影响 | 不能直接说明什么 | 建议验证方式 |
|---|---|---|---|
| CPU核心数 | 并行计算能力和可运行线程数 | 不代表内存带宽按比例增加 | 观察不同线程数下的吞吐曲线 |
| NUMA节点数量 | 线程与内存的绑定粒度 | 不代表节点越多性能越高 | 使用numactl --hardware确认 |
| NPS模式 | Socket内部的拓扑呈现方式 | 不代表处理器频率或总内存自动提升 | 记录固件配置并对照操作系统节点 |
| 内存通道使用情况 | 单节点带宽上限 | 不代表访问延迟一定更低 | 做本地带宽测试并核对内存配置 |
| 本地/远端访问比例 | 延迟、互连流量和有效带宽 | 不代表所有业务都会同比下降 | 结合numastat和业务延迟观察 |
| 线程亲和性 | 核心与节点的固定关系 | 不代表数据已经在对应节点 | 同时检查CPU绑定和内存归属 |
| 内存交错 | 负载在多个节点或通道间的分布 | 不代表每次访问都是本地访问 | 对比本地绑定和交错分配结果 |
其中,CPU核心数最容易被过度解读。对于计算密集型、数据主要驻留缓存的程序,核心数可能是主要变量;对于内存带宽受限的程序,增加核心数后吞吐可能很快趋于平坦;对于随机访问和共享数据较多的程序,远端访问比例和访问延迟可能比核心数量更重要。
性能结论必须绑定具体环境。至少应记录以下信息:
可以先使用只读命令采集操作系统看到的拓扑:
date -Is
uname -a
lscpu
lscpu -e=CPU,CORE,SOCKET,NODE
numactl --hardware
cat /sys/devices/system/node/node*/cpulist
如果系统未安装numactl,不要直接根据CPU型号猜测NUMA结构。可以先使用lscpu和/sys/devices/system/node/确认系统是否暴露了多个节点,再根据发行版的软件包管理方式补充测试工具。
重点观察以下内容:
available显示多少个NUMA节点;如果虚拟机只显示一个NUMA节点,测试结果只能说明当前虚拟拓扑下的行为,不能据此推断完整EPYC物理平台的远端访问差异。
假设numactl --hardware确认存在节点0和节点1,且测试程序名为./memory_benchmark,可以使用相同的程序、数据集和线程数进行以下对照:
export OMP_PLACES=cores
export OMP_PROC_BIND=close
export OMP_NUM_THREADS=8

numactl --cpunodebind=0 --membind=0 ./memory_benchmark
numactl --cpunodebind=0 --membind=1 ./memory_benchmark
numactl --cpunodebind=0 --interleave=all ./memory_benchmark
三条命令的含义分别是:
--membind属于严格约束。如果目标节点没有足够可用内存,程序可能分配失败,而不是自动切换到其他节点。执行前应确认节点容量,并避免在生产业务进程上直接进行严格绑定。
如果服务器只有一个NUMA节点,不应强行构造“远端测试”。这通常意味着NPS1、单Socket单节点,或者虚拟化平台没有向实例暴露完整拓扑。此时可以测试不同线程数下的带宽扩展,但不能得出同一平台内部远端访问的结论。
建议至少覆盖以下几类线程规模:
内存带宽测试的数据集应足够大,不能完全停留在缓存中;随机访问延迟测试则应使用能够区分缓存命中与内存访问的工作集。具体数据规模应根据服务器内存容量和测试工具实现确定,不宜用一个固定数值套用所有EPYC型号。
每组测试应包含预热、多个重复样本和稳定运行阶段。报告时至少保留中位数、离散程度和异常样本,并记录测试期间是否有其他进程抢占CPU或内存带宽。
对本地和远端测试分别记录读、写或复制带宽。可以使用以下相对指标,而不预设某个EPYC型号必须达到固定数值:
\[ 远端带宽比 = \frac{远端带宽}{本地带宽} \]
这个比值越低,说明当前线程与内存的跨节点访问代价越明显,但它不是一个脱离环境的通用常数。内存通道配置、节点数量、数据访问模式和测试线程数都会改变结果。
还要观察线程扩展曲线。如果单节点内线程增加后带宽很快趋于平坦,通常说明该节点的内存通道或控制器已经接近饱和;如果跨节点后总带宽继续上升,说明业务具备利用多个内存节点的条件。反过来,如果跨节点后吞吐下降,则可能是远端访问开销、互连竞争或线程与数据绑定不匹配。
随机访问、指针追踪和内存数据库类负载应重点观察访问延迟,而不是只看聚合带宽。应分别测量:
如果平均吞吐没有明显下降,但P95或P99延迟明显上升,说明少量跨节点访问可能正在影响尾延迟。这类情况在共享缓存、锁竞争或请求数据分布不均的服务中更值得关注。
业务运行期间可以使用以下命令查看内存节点活动:
numastat -m
numastat -p
不同内核版本显示的字段可能略有差异。通常可以关注本地节点访问、其他节点访问、NUMA miss以及页面迁移相关统计。观察方法应是比较业务运行前后的增量,而不是只看系统启动以来的累计值。
如果进程绑定在节点0,却持续出现较多其他节点内存访问,应进一步检查:
如果数据主要驻留在缓存中,或者每次加载数据后进行大量计算,NUMA影响可能相对有限。此时应优先观察核心利用率、频率和线程扩展效率。
但当数据集超过缓存容量后,原本的计算密集型任务也可能转变为内存受限任务。不能只根据程序名称判断,必须结合实际工作集和硬件计数器复测。
批量扫描、数组处理、部分科学计算和大规模数据转换通常会持续读取或写入内存。此类任务常见的限制是:
这类业务适合按照NUMA节点拆分工作集,并让负责处理某片数据的线程尽量运行在对应节点。
随机访问、锁密集型服务以及多个线程频繁修改同一缓存行时,对远端访问和缓存一致性更敏感。即使总带宽看起来充足,跨节点缓存行来回转移也可能推高请求延迟。
此时应同时记录线程迁移、内存节点访问和业务P99延迟,不能只用一个STREAM类带宽结果作判断。
如果日本AMD服务器提供的是虚拟机,客户看到的vCPU数量不一定等于完整物理拓扑。可能出现以下情况:
因此,虚拟机测试应明确标注“访客系统可见拓扑”和“实际可验证范围”。如果业务对NUMA局部性敏感,应在服务商侧确认是否提供裸机或完整vNUMA拓扑,而不能只按vCPU数量比较。
这可能是NPS1配置、单节点平台,也可能是虚拟机隐藏了物理拓扑。先核对固件和虚拟机规格,再决定是否有条件进行远端测试。在确认前,不要把“单节点”理解成物理服务器一定只有一个内存访问域。
优先排查工作集是否实际命中缓存、内存是否在测试线程启动前已经被其他节点分配,以及绑定参数是否生效。也可能是测试平台只暴露了一个节点,所谓远端命令并没有形成真正的远端访问。
这不是正常规律,应先检查线程数量、节点内存是否充足、内存通道是否均衡,以及两个测试是否使用了完全相同的初始化和预热过程。短时间测试、后台负载和频率变化也可能造成反常样本,不能凭一次运行调整BIOS。
常见原因包括单节点内存带宽已经饱和、线程数超过有效并行度、数据访问存在锁竞争,或者所有数据被主线程初始化到了同一个节点。结合带宽曲线、CPU利用率和numastat结果,可以区分是内存瓶颈还是调度问题。
选型和验收时,可以按以下顺序判断:
最终应比较的是“业务在目标线程数和目标数据集下的有效吞吐或尾延迟”,而不是处理器宣传页上的核心总数。EPYC的多核能力只有在CPU、内存通道、NUMA节点和线程数据布局相互匹配时,才能稳定转化为应用性能。


