

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


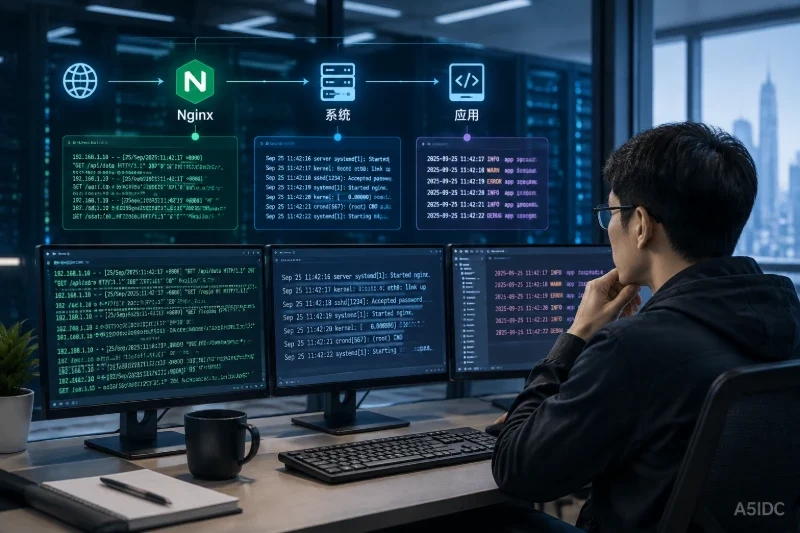
网站突然出现 500、502、504 或连接超时,最容易犯的错误是先重启服务、清空日志,或者直接修改 Nginx 超时参数。这样做可能暂时恢复页面,却会改变进程状态、覆盖现场,并让真正的故障原因更难确认。
在香港服务器上,网站请求通常先到达 Nginx,再转发给 PHP-FPM、Node.js、Java、Python 等应用进程,应用还可能继续访问数据库、缓存或其他内部服务。日志定位应按请求流向推进:先用 Nginx 访问日志确认请求是否到达、返回了什么状态码;再看 Nginx 错误日志解释失败位置;随后对照系统日志、服务日志和应用日志,最后把入口时间、服务变化时间与业务异常时间放到同一条时间线上。
排查前先记录可复现的信息,而不是只记下“网站打不开”:
GET、POST;先用只读请求确认外部表现。以下命令适用于 Linux 管理终端或安装了 curl 的环境,不会修改服务器配置:
curl -I --max-time 10 https://example.com/
curl -sS -o /dev/null -w 'code=%{http_code} time=%{time_total}s remote=%{remote_ip}\n' \
  --max-time 15 https://example.com/
可以先按状态码分流:
| 现象 | 初步含义 | 优先检查 |
|---|---|---|
2xx 或 3xx | Nginx 至少能够返回响应 | 页面内容、应用逻辑或客户端缓存 |
404 | 路径未匹配、路由不存在或文件缺失 | Nginx 路由、root/alias、应用路由 |
403 | 权限、访问规则或安全策略拒绝 | Nginx deny、文件权限、应用鉴权 |
500 | 应用或脚本执行异常的可能性较高 | 应用错误日志和 PHP-FPM 等上游日志 |
502 | Nginx 没有获得有效的上游响应 | 应用进程、监听地址、端口和 Nginx 错误日志 |
504 | 上游没有在规定时间内返回 | 应用耗时、数据库、外部依赖和超时配置 |
| 连接超时或连接被拒绝 | 端口未监听、服务异常或连接未建立 | 监听状态、系统服务和请求是否到达本机 |
这些只是第一层判断,不代表状态码必然对应某个单一原因。例如,502 不等于应用代码一定抛出了异常,也可能是应用没有启动、监听端口不一致,或进程启动后立即退出。
关联 Nginx、系统和应用日志前,要确认它们使用的时区。香港服务器可以使用 Asia/Hong_Kong,但不能假设所有组件都已统一;容器、应用运行时或独立日志系统可能仍使用 UTC。
date '+%F %T %Z %z'
timedatectl status
timedatectl show -p Timezone -p NTPSynchronized --value
不要为了排查临时修改服务器时区。时区变更会影响定时任务、日志排序和部分应用逻辑。更稳妥的方式是记录当前时区,并在比较时统一换算。若 Nginx 使用本地时间、应用使用 UTC,应先完成时间换算,再判断两个事件是否发生在同一秒或同一分钟。
在改配置或重载服务前,先确认当前生效配置并保存现场。Nginx 的日志路径会因发行版、安装方式、虚拟主机配置和容器部署方式而不同,不能直接假定所有环境都使用 /var/log/nginx/。
sudo nginx -t
sudo nginx -T 2>/dev/null | grep -E 'access_log|error_log|proxy_pass|fastcgi_pass'
其中:
nginx -t 用于检查配置语法和文件引用,不会重载配置;nginx -T 输出完整的生效配置,可用于确认日志路径、虚拟主机匹配关系和上游地址;nginx: command not found,Nginx 可能运行在容器中、使用非标准安装路径,或当前终端并未连接到目标服务器,应先确认部署方式。常见日志路径包括:
/var/log/nginx/access.log
/var/log/nginx/error.log
它们只是常见位置,最终应以 nginx -T 的结果为准。确认路径后,可以保存配置和必要的日志现场:
sudo mkdir -p /root/incident-backup
sudo nginx -T > /root/incident-backup/nginx-config-$(date +%F-%H%M%S).txt
sudo cp -a /etc/nginx /root/incident-backup/nginx-etc-$(date +%F-%H%M%S)
日志可能包含用户 IP、请求路径、查询参数或业务标识,备份目录应限制访问权限。不要使用 rm 清空日志,也不要把完整生产日志直接发送到公开渠道。日志文件很大时,先截取故障窗口附近的内容:
sudo tail -n 300 /var/log/nginx/error.log
sudo tail -n 300 /var/log/nginx/access.log
需要保留原始文件时,可复制而不是覆盖:
sudo cp -a /var/log/nginx/error.log \
  /root/incident-backup/error.log-$(date +%F-%H%M%S)

sudo cp -a /var/log/nginx/access.log \
  /root/incident-backup/access.log-$(date +%F-%H%M%S)
访问日志首先回答三个问题:请求是否到达正确的 Nginx、最终返回了什么状态码、请求耗时是否异常。实际字段取决于 nginx -T 中的 log_format,不能假定每台服务器都有相同格式。
先查看真实日志样式:
sudo tail -n 5 /var/log/nginx/access.log
如果已经确定故障发生在某个小时,可以按实际日期和格式检索。例如,下面的时间字符串只是示例,必须替换为真实故障时间:
sudo grep '25/Sep/2026:14:' /var/log/nginx/access.log | tail -n 100
重点查看这些字段:
POST、PUT 等写请求失败;$request_time;$upstream_response_time;$upstream_status;$request_id,用于关联应用日志。如果访问日志没有对应请求,不要立即修改应用代码。常见原因包括:
server 配置块;access_log 写入了自定义路径;此时应重新检查 nginx -T、server_name、监听端口和实际日志路径。实时排查时还要考虑日志缓冲:请求已经发生,并不代表记录会立即出现在文件中。
访问日志告诉你“发生了什么”,错误日志更接近“为什么发生”。先查看故障时间附近的错误记录:
sudo grep -E '2026/09/25 14:' /var/log/nginx/error.log | tail -n 100
日期和小时必须替换为实际时间。常见关键词可以这样理解:
| 错误日志关键词 | 常见含义 | 下一步 |
|---|---|---|
connect() failed (111: Connection refused) | Nginx 无法连接上游端口 | 检查应用进程、监听地址和端口 |
upstream timed out | 上游未在规定时间内返回 | 检查应用耗时、数据库和外部依赖 |
no live upstreams | 配置中的上游没有可用节点 | 检查上游服务状态和健康检查 |
recv() failed | 连接建立后读取响应失败 | 检查应用异常退出、连接中断或协议不匹配 |
permission denied | Nginx 无权读取文件或连接资源 | 检查文件、目录、SELinux 或其他安全策略 |
open() ... failed (2: No such file) | 文件、脚本或路径不存在 | 检查 root、alias 和发布路径 |
client intended to send too large body | 请求体超过限制 | 检查 client_max_body_size 与业务需求 |
SSL_do_handshake() failed | TLS 握手失败 | 检查证书、协议、SNI 和客户端兼容性 |
判断 502 时,要把错误日志中的时间、上游地址和端口与应用服务状态对照。若 Nginx 出现 connection refused,而应用服务在同一时间重启或处于 failed,故障范围通常已缩小到上游服务、监听配置或进程生命周期。若是 upstream timed out,则不能仅凭这一行判断是应用、数据库还是外部依赖变慢,还要继续查看应用日志和耗时字段。
当 Nginx 错误日志出现连接被拒绝、超时或连接中断时,进入系统层检查。先确认服务实际名称,不要直接假定一定叫 php-fpm、node 或 app:
systemctl list-units --type=service --state=running
systemctl list-unit-files --type=service | \
  grep -Ei 'nginx|php|fpm|node|python|java|gunicorn|uwsgi|app'
确认名称后查看服务状态和故障窗口内的日志:
sudo systemctl status nginx --no-pager

sudo journalctl -u nginx \
  --since '2026-09-25 14:00:00' \
  --until '2026-09-25 14:20:00' \
  --no-pager
对应用服务,将 your-app.service 替换为实际服务名:
sudo systemctl status your-app.service --no-pager

sudo journalctl -u your-app.service \
  --since '2026-09-25 14:00:00' \
  --until '2026-09-25 14:20:00' \
  --no-pager
重点关注:
failed、exit-code、signal 或启动失败;资源检查只能反映当前状态,不能替代故障窗口内的历史日志:
free -h
df -h
df -i
uptime
ps -eo pid,ppid,stat,%cpu,%mem,etime,cmd --sort=-%cpu | head -n 20
如果怀疑内存不足或内核终止进程,可以查看内核日志:
sudo journalctl -k \
  --since '2026-09-25 14:00:00' \
  --until '2026-09-25 14:20:00' \
  --no-pager | \
  grep -Ei 'oom|out of memory|killed process|i/o error|segfault'
出现 OOM 或 killed process,说明应用可能不是主动退出,而是被系统回收。重启应用只能恢复表面可用性,还需要继续检查内存峰值、进程数量和请求是否异常增长。
应用日志的位置由框架、启动方式和部署脚本决定。优先从服务定义、启动命令和运行环境中确认:
sudo systemctl cat your-app.service
sudo systemctl show your-app.service \
  -p ExecStart -p WorkingDirectory -p Environment
常见情况有:
systemd 管理的应用,日志主要在 journalctl -u your-app.service;如果使用 Docker,先确认容器名称和状态:
sudo docker ps --format 'table {{.Names}}\t{{.Image}}\t{{.Status}}\t{{.Ports}}'
确认目标容器后,按时间范围查看:
sudo docker logs \
  --since '2026-09-25T14:00:00+08:00' \
  --until '2026-09-25T14:20:00+08:00' \
  your-app-container
应用日志中应重点寻找:
如果 Nginx 返回 500,并且应用日志在同一秒出现异常堆栈,通常可以把故障定位到应用层。如果 Nginx 返回 502,而应用日志在同一时间完全没有对应请求记录,应优先检查应用是否尚未接收请求、监听地址是否配置错误,或连接是否在应用接收前就失败。
完整的故障时间线至少包含三个时间点:
如果三个时间点只相差几秒,要考虑日志缓冲、异步写入和时钟误差;如果相差数小时,应先怀疑时区或时间格式解析错误,而不是立即判断为多个独立故障。
长期排查中,最好让 Nginx 和应用使用同一个请求标识。若当前配置尚未记录 $request_id,可以在确认变更范围、备份配置后,增加类似的日志格式和请求头传递规则:
log_format main_with_id
    '$remote_addr - $remote_user [$time_local] '
    '"$request" $status $body_bytes_sent '
    'rt=$request_time urt=$upstream_response_time '
    'upstream_status=$upstream_status request_id=$request_id';

proxy_set_header X-Request-ID $request_id;
修改前必须先核对现有 log_format,不要直接覆盖原配置。修改后先检查语法:
sudo nginx -t
只有语法检查通过,并确认已经保存原配置,才考虑平滑重载:
sudo systemctl reload nginx
应用也必须读取 X-Request-ID 并把它写入应用日志。之后可以用同一个标识查询:
sudo grep 'request_id=abc123' /var/log/nginx/access.log
sudo journalctl -u your-app.service --no-pager | grep 'abc123'
如果当前没有请求 ID,只能暂时使用“时间 + 路径 + 客户端地址”组合匹配。并发较高时这种方法容易把不同请求串在一起,因此只能作为临时手段。
假设访问日志记录:
request_time=8.5 upstream_response_time=0.2
这表示请求总耗时较长,但上游处理时间较短,延迟可能发生在客户端上传、Nginx 处理、响应发送或连接管理阶段。
如果记录为:
request_time=8.5 upstream_response_time=8.3
则应优先检查应用本身、数据库查询、外部依赖或应用超时。若出现多个上游耗时值,还要结合 upstream_status、上游地址和错误日志判断是否发生了重试。最终状态为 200 的请求也可能经历过上游重试并产生明显延迟,不能只看最终状态码。
修复后先做小范围、无副作用的验证,不要立即认为故障已经消失:
curl -sS -o /dev/null -w \
'code=%{http_code} dns=%{time_namelookup}s connect=%{time_connect}s start=%{time_starttransfer}s total=%{time_total}s\n' \
--max-time 15 https://example.com/health
如果没有健康检查地址,可以选择不会产生写入副作用的页面或接口。至少验证:
404;5xx;修复确认时间后,持续观察新日志:
sudo tail -F /var/log/nginx/access.log /var/log/nginx/error.log
应用由 systemd 管理时:
sudo journalctl -u your-app.service -f
tail -F 会跟随日志轮换后的新文件,比 tail -f 更适合观察配置变更后的状态。重点查看新的 500、502、504、上游连接拒绝、应用重复崩溃,以及错误是否从单个接口扩散到整个网站。
若修复的是 Nginx 配置,还要确认当前生效配置,而不是只确认文件已经保存:
sudo nginx -T 2>/dev/null | \
  grep -E 'access_log|error_log|proxy_pass|fastcgi_pass'
若修复的是应用,应同时确认应用版本、进程启动时间和日志中的版本标识,避免实际运行的仍是旧进程或旧代码。
出现以下情况时,应停止继续叠加修改,优先考虑恢复最近一次变更:
nginx -t 不通过;5xx;回滚前先保留失败配置和错误日志。Nginx 配置回滚应恢复已备份文件,重新执行 nginx -t,确认通过后再平滑重载。应用版本应使用已有发布流程回滚,避免手工复制不完整文件。数据库结构变更、文件删除、权限调整和防火墙修改不能按普通应用回滚处理,必须分别确认备份和逆向操作。
修复后应安排明确的观察窗口,持续检查 Nginx 5xx、应用异常、服务重启和关键接口响应。如果同类错误在观察窗口内再次出现,或错误频率没有下降,应触发回滚或暂停继续变更,而不是反复重启来掩盖问题。


