

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


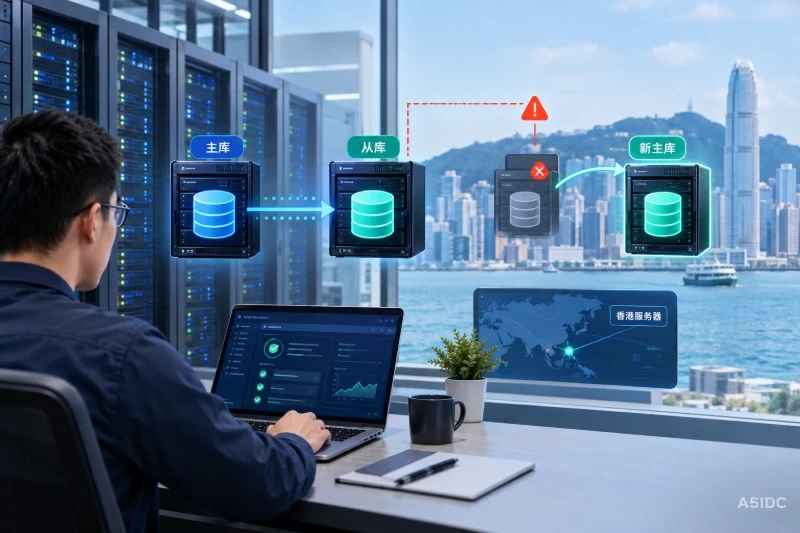
典型现场是:应用连接香港服务器上的 MySQL 主库开始报错,监控同时显示从库仍可连接。此时最危险的动作,是仅凭“从库在线”就把它改成可写并切换应用连接。主库可能只是与应用暂时失联,仍在接受其他连接的写入;从库也可能尚未执行完已收到的事务。前一种情况会造成双主写入,后一种情况会让切换后的数据落后于原主库。
现场排查应按优先级进行:先确认业务写入是否需要暂停、原主库是否仍可能接受写入;再检查从库复制线程、错误和事务执行进度;随后判断哪些已提交事务能在候选从库上得到证明;最后才执行提升、切换入口和业务验证。这个顺序也适用于事先设计切换流程:旧主库写入隔离是防止数据分叉的前提,复制追平决定切换时的数据边界,应用入口切换则决定业务何时恢复。
值班人员首先要分别从应用侧和从库侧确认现象。应用写入失败,可能是应用到主库的连接中断,也可能是主库进程不可用;从库复制连接断开,则说明从库取不到新的日志,却不能单独证明主库已经停止写入。如果原主库还可能被其他应用实例、定时任务或人工连接访问,就不能直接提升从库。
优先检查以下几项,并保留检查时间与结果:
对仅有一主一从的部署,尤其要把“谁有权决定提升”写进值班流程。两个实例彼此连接失败时,都无法仅凭对方不可达判断对方已经停止服务。没有可靠的写入隔离手段时,宁可明确记录恢复时间增加的原因,也不要同时留下两个可写主库。
以下检查示例适用于支持 SHOW REPLICA STATUS 和 STOP REPLICA 语法的 MySQL 8.0.23 及以后版本,命令在 MySQL 客户端执行。先用只读查询核对实际版本和配置;若现场版本或复制方式不同,应按该版本文档调整语法,不要把示例直接用于未知环境。
在原主库可连接时,以及候选从库上,分别执行:
SELECT VERSION();
SELECT
  @@GLOBAL.server_id,
  @@GLOBAL.gtid_mode,
  @@GLOBAL.enforce_gtid_consistency,
  @@GLOBAL.log_bin,
  @@GLOBAL.read_only,
  @@GLOBAL.super_read_only,
  @@GLOBAL.gtid_executed,
  @@GLOBAL.gtid_purged;
在候选从库上再执行:
SHOW REPLICA STATUS\G
SHOW REPLICA STATUS\G 是 MySQL 客户端的竖排显示写法。重点记录 Source_Host、Replica_IO_Running、Replica_SQL_Running、Last_IO_Error、Last_SQL_Error、Retrieved_Gtid_Set 和 Executed_Gtid_Set:
Last_SQL_Error 定位冲突或执行失败的事务。跳过错误可能掩盖数据差异,不应作为默认恢复手段;修复前需保存当前状态并确认受影响数据。Seconds_Behind_Source 为零或不可用:它不能替代事务集合比较;复制停止、连接异常和取样时机不同,都可能让这个值失去判断意义。以上判断以 GTID 复制为例。若 gtid_mode 未开启,应改用现场的二进制日志文件、位置和实际执行状态核对,不能套用下面的 GTID 比较命令。若从库曾被业务直接写入,还要检查其是否产生了不属于原主库的事务;这种从库不应未经分析就被视为干净的切换目标。
数据一致性至少有三层不同含义:从库已收到多少事务、已执行多少事务,以及原主库最终提交了多少事务。异步复制下,主库确认给业务的事务可能尚未传到从库;因此,从库把现有中继日志执行完,也不自动意味着没有数据损失。
计划内切换时,较可靠的做法是先停止业务产生新写入,在原主库上阻止后续写入并确认措施生效,然后记录其最终的 @@GLOBAL.gtid_executed。待候选从库执行完已接收事务后,比较两边 GTID 集合。只有原主库最终集合中的事务都包含在候选从库已执行集合中,才能就这一范围说“已追平”。比较期间若原主库仍在写入,之前取得的快照随时可能过期。
突发故障时,若原主库无法访问,通常拿不到可信的最终 GTID 集合。此时可以确认“从库已经执行了它收到的事务”,却不能据此确认“从库拥有原主库所有已提交事务”。是否接受可能的数据损失,应由预先约定的恢复目标和业务负责人决定,并保留告警、连接状态、事务集合及切换时间点,供原主库恢复后核对。
对于拟提升的从库,先停止其继续接收原主库事务,再等待 SQL 线程处理已收到的日志。以下操作会暂停复制接收,只能在已决定进入切换流程、且已记录当前复制状态时执行;若取消切换,可在确认原主库仍是唯一写入源后使用 START REPLICA IO_THREAD 恢复接收。
STOP REPLICA IO_THREAD;
SHOW REPLICA STATUS\G
记录此时的 Retrieved_Gtid_Set,等待 SQL 线程继续执行,再将记录的完整值代入查询:
SET @retrieved_gtids = '替换为刚才记录的Retrieved_Gtid_Set完整值';
SELECT GTID_SUBSET(@retrieved_gtids, @@GLOBAL.gtid_executed) AS relay_applied;
relay_applied 为 1,表示记录时已接收的事务均包含在当前已执行集合中;为 0,应继续等待并检查 Last_SQL_Error。执行中不能把示例占位文字当成 GTID 值直接使用。若原主库最终 GTID 集合可取得,还应在候选从库上比较:
SET @source_gtids = '替换为已停止写入的原主库最终GTID集合';
SELECT
  GTID_SUBTRACT(@source_gtids, @@GLOBAL.gtid_executed) AS missing_from_candidate,
  GTID_SUBTRACT(@@GLOBAL.gtid_executed, @source_gtids) AS extra_on_candidate;
missing_from_candidate 非空,说明候选从库缺少原主库集合中的事务,不能按“已追平”提升;extra_on_candidate 非空,则要调查从库本地写入或其他事务来源。比较结果为两个空集合,也只证明这次记录的 GTID 范围一致,仍需检查实际业务读写。
香港服务器上的主从复制设计,应预先指定候选从库、统一的业务连接入口、旧主库隔离办法,以及谁有权批准可能丢失事务的切换。日常还应核对两个实例的标识不冲突、复制账号可用、备份可恢复,并定期演练应用重新连接后的行为。恢复时间目标要覆盖发现故障、确认隔离、等待追平、调整入口和验证业务的全过程;恢复点目标则要按复制方式和最坏情况下可接受的事务缺口确定。
执行时按以下顺序推进:
STOP REPLICA;
SET GLOBAL super_read_only = OFF;
SET GLOBAL read_only = OFF;
SELECT @@GLOBAL.read_only, @@GLOBAL.super_read_only;
SET GLOBAL 修改的是实例运行状态。切换完成后还应核对实例重启后的只读配置,避免重启使角色与预期不符。不要在尚未处理旧主库数据差异时,直接清除其复制记录或把它重新接回业务。
旧主库重新可连接时,应先保持它不对业务提供写入,保存其数据和事务记录,再与现任主库比较 GTID 集合。若旧主库存在新主库没有的事务,要先判断这些事务是否对应已向业务确认的写入,制定补回或业务对账方案;若新主库已有新的写入,也不能让旧主库按原角色直接恢复服务。差异无法安全合并时,应保留证据,使用经验证的备份或现任主库数据重建复制关系,并在重建前确认备份范围与影响。
一次切换成功,不只是新主库能执行 SELECT。值班人员还应复查:旧主库是否仍能被某个写入方访问;所有应用连接是否真正迁移;复制停止前记录的事务是否执行完成;切换期间业务重试是否产生重复操作;新主库的写入是否进入备份与监控范围;以及故障恢复后,原主库是否始终处于隔离状态。这些检查项决定了故障切换究竟只是“恢复了连接”,还是在可说明的数据边界内恢复了服务。


