

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


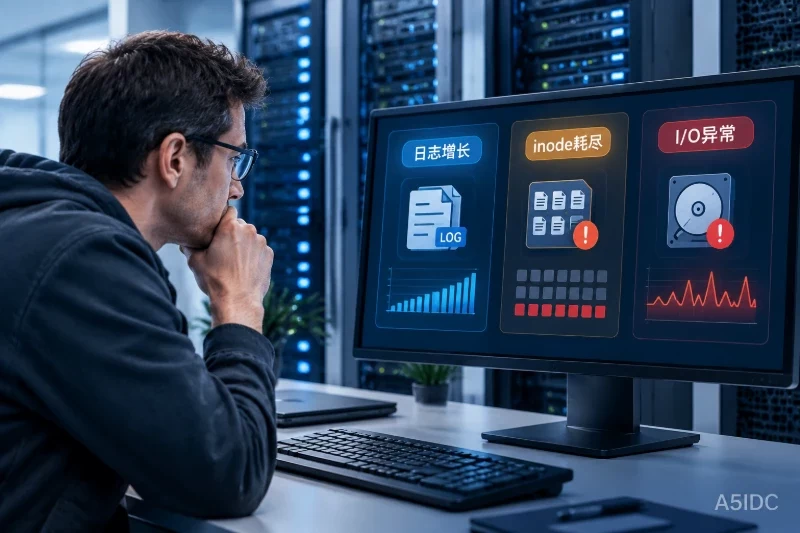
美国服务器出现“磁盘空间不足”时,业务表现可能是上传失败、数据库写入报错、日志无法继续记录,甚至服务响应变慢。但“空间不足”不一定等于磁盘容量真的被大文件占满,也可能是 inode 用尽、日志文件增长失控,或者底层 I/O 延迟过高导致写入超时。
排查时不要先执行删除或重启。优先使用只读命令确认受影响的文件系统,再依次判断容量、inode、日志、打开但已删除的文件,以及 I/O 和文件系统状态。最先执行的分流检查如下:
sudo df -hT
sudo df -ih
sudo findmnt -T /var/log
其中,df -hT 判断数据块容量,df -ih 判断 inode 使用情况,findmnt 确认具体目录属于哪个挂载点。只有完成这一步,后续的 du、日志和 I/O 检查结果才不会被错误解读。
以下结果可以作为第一轮判断依据:
| 观察结果 | 更可能的原因 | 下一步 |
|---|---|---|
df -hT 中 Avail 接近为零,df -ih 仍有较多 inode | 普通数据块被占满 | 使用 du 定位大目录和大文件 |
df -ih 中 inode 使用率接近耗尽,但容量仍有剩余 | 大量小文件或临时文件 | 统计文件数量最多的目录 |
df 显示已满,但 du 汇总明显偏小 | 文件已删除但进程仍打开、挂载点遮蔽或文件系统元数据占用 | 检查 lsof +L1 和挂载关系 |
容量和 inode 都未满,但 iostat 的等待时间、队列明显升高 | I/O 延迟或存储路径异常 | 检查进程、内核日志和文件系统状态 |
| 文件系统变为只读,内核日志出现 I/O 错误 | 文件系统或底层存储异常 | 先保护数据,再安排离线检查 |
这里的重点是:日志增长属于“占用空间的原因”,I/O 异常属于“写入变慢或失败的原因”,两者可能同时出现,但不能仅凭服务变慢就断定是磁盘满。
df 反映的是文件系统层面的真实可用空间,应该优先于单个目录的 du 结果。
sudo df -hT
sudo df -hT /
sudo df -hT /var
sudo findmnt -T /var
如果 /var 并不是独立挂载点,/var 的使用量会计入根文件系统;如果它是独立挂载点,则需要单独检查。排查时还要注意文件系统类型,因为不同文件系统的元数据和保留空间机制不同。
确认具体挂载点后,再查看目录占用:
sudo du -xhd1 / 2>/dev/null | sort -h
sudo du -xhd1 /var 2>/dev/null | sort -h
sudo du -xhd1 /var/log 2>/dev/null | sort -h
-x 表示不跨越其他文件系统,可以避免把其他挂载点的内容重复计算。du 扫描大量文件时本身会产生 I/O,磁盘已经出现高延迟时不要反复执行全盘扫描,应先缩小到受影响的目录。
如果某个目录明显占用最大,再继续查看其中的大文件:
sudo find /var/log -xdev -type f -printf '%s\t%p\n' 2>/dev/null \
  | sort -nr | head -20
对于日志目录,重点关注持续增长的单个日志、异常大的压缩包、重复生成的转储文件,以及没有被轮转的应用日志。不要因为文件名带有 .log 就直接删除,先确认它属于哪个服务、是否仍在写入,以及是否属于审计或合规留存范围。
如果 du 显示 /var/log、应用日志目录或 systemd journal 占用明显,优先检查日志保留和轮转状态。
sudo journalctl --disk-usage
sudo du -sh /var/log/* 2>/dev/null | sort -h
sudo ls -l /etc/logrotate.conf /etc/logrotate.d/
sudo logrotate -d /etc/logrotate.conf
logrotate -d 是调试模式,主要用于查看轮转规则,不会按正常流程执行轮转。检查时应关注:
如果已经确认日志可以清理,应先归档需要保留的内容。对 systemd journal,可以按照已经批准的保留周期或容量策略执行清理;不要在没有确认保留要求的情况下随意指定周期。对普通应用日志,先用 logrotate -d 检查规则,确认无误后再执行正式轮转:
sudo logrotate -f /etc/logrotate.conf
这类操作可能会重命名、压缩或删除超过保留策略的旧日志,执行前需要确认备份和留存要求。当前正在写入的日志不建议直接 rm。删除文件名并不一定能立即释放空间,而且可能造成应用继续写入一个不可见的文件。
inode 用于记录文件的元数据。大量小文件、短生命周期临时文件、缓存文件或会话文件,可能在数据容量尚未完全用尽时先耗尽 inode。典型表现是创建新文件时报 No space left on device,但 df -h 看起来仍有可用空间。
先确认各挂载点的 inode 使用率:
sudo df -ih
sudo df -ih /var
如果某个挂载点的 inode 使用率异常,再在该文件系统内统计文件数量较多的目录:
sudo find /var -xdev -type f -printf '%h\n' 2>/dev/null \
  | sort | uniq -c | sort -nr | head -20
该命令可能需要扫描大量目录,建议在业务低峰执行。结果只能说明哪些目录包含大量文件,不能直接说明哪些文件可以删除。下一步应结合文件的创建时间、所属服务和用途进行确认。
可以先做非破坏性的筛选:
sudo find /var/tmp -xdev -type f -mtime +30 -print 2>/dev/null | head -100
只有在确认文件属于可重建缓存、过期临时文件或已完成处理的数据,并且已经完成备份或获得清理授权后,才执行删除。删除操作通常无法回滚,因此不建议把带有通配符的递归删除命令直接用于 /var、应用数据目录或日志目录。
如果 inode 释放后,应用仍然无法写入,应重新检查:
sudo df -hT
sudo df -ih
数据块和 inode 必须分别恢复到有足够余量的状态,不能只看其中一项。
这是美国服务器磁盘故障排查中最容易误判的一类情况。进程打开文件后,即使文件名已经被删除,只要文件描述符仍然存在,文件占用的空间就不会立即释放。du 找不到这个文件,但 df 仍会显示空间被占用。
使用以下命令检查已删除但仍被进程打开的文件:
sudo lsof +L1
重点查看文件大小、进程名和用户。如果发现某个服务持有非常大的 (deleted) 文件,应先确认服务身份和业务影响,再安排服务重新打开日志或在维护窗口重启服务:
sudo systemctl status <实际服务名>
sudo systemctl restart <实际服务名>
这里的服务名必须替换为实际检查结果,不能照抄占位符。重启可能造成连接中断或正在处理的任务失败,执行前应确认服务依赖、维护窗口和回退方式。若应用支持按文档发送重新打开日志的信号,优先使用该方式,避免不必要的完整重启。
除了 deleted-open 文件,还要检查挂载点差异。某个目录在写入大量文件后被另一个文件系统挂载覆盖,挂载后的 du 看不到挂载前的内容,但卸载操作又可能暴露出原有数据。生产环境不要为了排查随意卸载挂载点,应通过 findmnt、系统配置和维护窗口确认。
当 df -hT 和 df -ih 都没有解释问题,但服务仍然出现写入超时、请求延迟升高或进程处于不可中断睡眠状态,就需要检查 I/O。
如果系统已安装 sysstat,可以执行:
sudo iostat -xz 1 5
sudo vmstat 1 5
sudo pidstat -d 1 5
判断时不要只看一个字段:
await 反映 I/O 请求从发出到完成的平均等待时间,持续升高说明请求完成变慢;aqu-sz 反映等待队列情况,队列持续增长通常表示处理能力跟不上请求;%util 反映设备忙碌程度,但在不同存储设备和虚拟化环境中不能单独作为故障阈值;vmstat 中的 wa 升高表示 CPU 有较多时间等待 I/O,但还需要结合设备和进程数据;pidstat -d 可帮助定位正在产生读写的进程。如果在日志增长期间同时看到 I/O 等待升高,I/O 可能是日志大量写入造成的结果,而不是独立的存储故障。相反,如果没有明显的大文件写入,却持续出现高等待、队列堆积或内核错误,则应把 I/O 异常作为主要方向。
继续检查内核和文件系统事件:
sudo dmesg -T | tail -n 100
sudo journalctl -k -n 100 --no-pager
sudo findmnt -no SOURCE,FSTYPE,OPTIONS,TARGET
如果看到 I/O error、文件系统错误、设备重置,或者挂载选项出现 ro,不要继续进行大规模删除、轮转或写入测试。先确保数据备份或快照可用,再根据文件系统类型和运行环境安排离线检查。fsck 或文件系统修复工具不应直接对正在承载业务的挂载点执行,修复前通常需要停止相关服务并在卸载或救援环境中操作。
处理完成后,不能只看一次 df 就认为故障结束,建议按以下顺序验证:
   sudo df -hT
   sudo df -ih
   sudo du -xhd1 /var 2>/dev/null | sort -h
   sudo journalctl --disk-usage
sudo lsof +L1
   sudo systemctl status <实际服务名>
   sudo journalctl -u <实际服务名> -n 100 --no-pager
sudo iostat -xz 1 5
磁盘监控至少要把数据块、inode 和 I/O 分开设置。只监控容量,无法发现大量小文件导致的 inode 耗尽;只监控空间,也无法识别文件系统已经变成只读或设备延迟持续上升。
建议持续关注以下指标:
/var/log、应用日志目录和 journal 的增长速度;这样处理后,才能把“美国服务器磁盘空间突然不足”拆分为可验证的几条路径:df -hT 负责判断容量,df -ih 负责判断 inode,du 和日志工具负责定位增长来源,lsof +L1 负责解释 df 与 du 不一致,iostat、pidstat 和内核日志则用于确认是否存在 I/O 或文件系统异常。


