

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


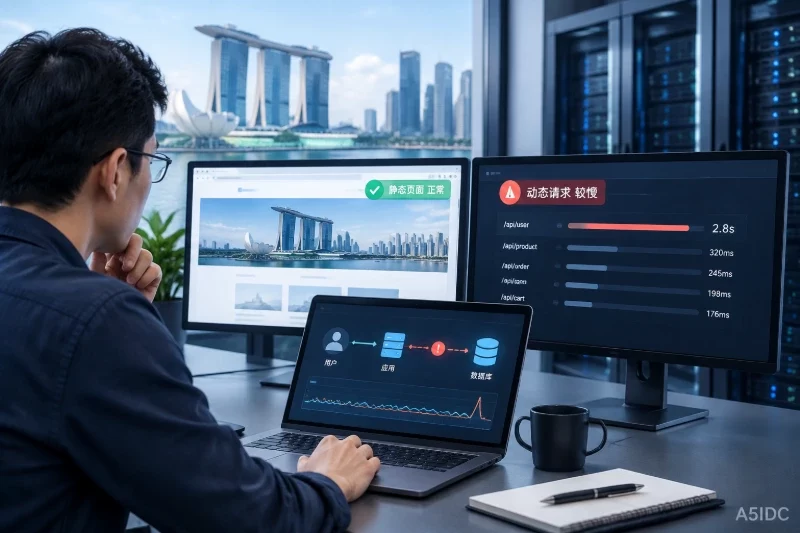
页面图片、样式能迅速加载,但登录、搜索或提交接口迟迟没有响应,说明故障可能集中在动态处理路径。排查新加坡服务器时,先确认受影响的是全部动态请求,还是某个接口、某类账号或特定时段;同时检查静态资源是否命中了浏览器缓存或 CDN,避免把“缓存访问正常”误认为“源站链路正常”。
建议按外部访问与源站对照 → Web 入口计时 → 应用内部耗时 → 数据库等待 → 系统资源关联的顺序检查。先用只读观测缩小范围,再调整配置或代码;如果已经出现大量超时,可以同步采集系统指标,但不要仅凭 CPU 高、连接多就认定根因。
选择一个能稳定复现的动态接口,以及一个由同一源站返回的小型静态文件作为对照。测试应尽量保持入口、认证状态和访问时间一致,避免拿缓存首页与需要登录的查询接口直接比较。
排查前准备好只读日志权限、服务器观测权限,以及必要时的数据库只读诊断账号。记录以下信息:
优先使用无副作用的查询接口复现,不要循环执行下单、支付或写入请求。日志和截图中的令牌、Cookie、手机号及 SQL 参数需要脱敏。
可以先建立这棵判断树:
| 观察结果 | 优先怀疑的范围 | 下一步 |
|---|---|---|
| 外部慢,服务器本机访问同一入口快 | 外部链路、代理入口,或两次请求实际走了不同路径 | 对照解析、入口地址、缓存和请求头 |
| 本机动态请求也慢,静态文件快 | 应用处理链、数据库、外部依赖 | 查看入口上游计时 |
| 仅个别接口慢 | 接口代码、SQL、锁或特定数据 | 按请求标识追踪内部耗时 |
| 多个动态接口随并发一起变慢 | 工作进程、连接池或共享资源排队 | 检查队列、连接池和系统指标 |
静态正常只能缩小范围,不能单独证明网络、磁盘或数据库没有问题。静态文件可能由缓存直接返回,动态请求则需要经过更多处理环节。
以下命令适用于安装了 curl 的 Linux 环境,仅发起一次 GET 请求,不修改配置。将域名和路径替换为实际的只读接口:
curl -sS -o /dev/null \
  --connect-timeout 5 --max-time 30 \
  -w 'code=%{http_code} ip=%{remote_ip} dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total}\n' \
  'https://app.example.com/api/read-only'
这里的超时值是测试保护条件,不是性能达标线。未带认证的请求可能只测到登录跳转或拒绝响应,因此必须确认状态码和响应内容符合预期。
这些时间大多是从请求开始累计的:
dns 偏高:先检查解析耗时。connect - dns 偏高:关注 TCP 建连路径。tls - connect 偏高:关注 TLS 握手阶段。ttfb 明显增长:重点检查请求发出后到首字节返回之间的等待。total - ttfb 明显增长:检查响应体大小、传输过程或流式输出。TTFB 包含前面的连接阶段,并不等于应用执行时间。客户端计时只能给出方向,还要与服务端日志互相验证。
如果 Web 服务确实监听本机回环地址的 443 端口,可以在服务器上保留域名与 TLS 校验,绕过外部路径进行对照:
curl --resolve app.example.com:443:127.0.0.1 \
  -sS -o /dev/null --connect-timeout 5 --max-time 30 \
  -w 'code=%{http_code} ttfb=%{time_starttransfer} total=%{time_total}\n' \
  'https://app.example.com/api/read-only'
如果服务未监听该地址,连接失败不代表应用故障,应使用经核实的本机入口。不要用 -k 跳过证书验证来掩盖入口配置问题。
本机快、外部慢时,也要确认是否绕过了代理、缓存或认证逻辑。只有请求条件相近,这个对照才有诊断价值。
以 Nginx 为入口时,先检查现有访问日志是否包含:
$request_time:从读取客户端请求首批字节,到发送响应后记录日志的请求总时间。$upstream_connect_time:连接上游耗时。$upstream_header_time:等待上游响应头的耗时。$upstream_response_time:接收上游响应的耗时。如果尚未记录,可以添加独立诊断日志。以下适用于支持这些变量的 Nginx;先通过 nginx -v 确认版本,并核实实际配置文件位置。配置示意如下:
# 放在 http 上下文
log_format timing '$time_iso8601 "$request_method $uri" status=$status '
                  'rt=$request_time uct=$upstream_connect_time '
                  'uht=$upstream_header_time urt=$upstream_response_time';

# 放在目标 server 上下文;先确认该日志目录存在且可写
access_log /var/log/nginx/timing.log timing;
修改前备份目标配置。先执行 nginx -t,通过后再使用当前部署的管理方式平滑重载;容器环境应在对应实例内检查,不能误操作宿主机上的另一套 Nginx。新增日志会增加磁盘写入,诊断结束后可移除新增配置、再次检查并重载,完成回滚。
判断时注意:
-:请求可能没有进入上游,例如命中了本地缓存或被入口直接处理。这些指标并非总能简单相减得到某一层的耗时。出现重试时,上游字段还可能包含多组值,应结合上游地址和错误日志逐次判断。
当入口日志表明等待主要发生在上游,就要沿同一个请求继续追踪。已有请求标识或链路追踪时优先使用,避免临时开启全量调试日志造成额外压力。
至少区分以下时间段:
1. 请求进入应用队列到获得工作线程或进程。
2. 从连接池获取数据库连接。
3. 执行 SQL 与读取结果。
4. 调用外部服务。
5. 业务计算、模板渲染或 JSON 序列化。
数据库调用耗时长,不一定是 SQL 执行慢。如果主要耗时发生在获取连接之前,应检查连接池等待、连接泄漏和事务是否及时结束,而不是直接修改 SQL。
常见分支及处理方向如下:
需要新增埋点时,应采样并避免记录敏感参数。代码修复优先小范围发布,保留旧版本;不要同时修改工作进程数、连接池和 SQL,否则很难确认哪项真正有效。
数据库排查应针对慢请求实际触发的 SQL,不能只查看数据库整体负载。先判断它是在执行,还是在等待锁、连接或结果传输。
以下只读示例适用于 MySQL 8.0,需要相应诊断权限;其他数据库应使用对应的活动会话和锁等待视图:
SHOW FULL PROCESSLIST;

SELECT *
FROM performance_schema.data_lock_waits
LIMIT 20;
SHOW FULL PROCESSLIST 可能展示业务 SQL 和敏感值,结果不宜公开传播。锁等待视图只能反映采样时可见的等待;没有记录,并不能排除此前发生过锁竞争,也不能排除其他类型的等待。
按结果继续定位:
对已确认的只读查询,可执行普通 EXPLAIN,重点看过滤条件是否有效利用索引、估算扫描行数以及排序行为。不要直接在生产环境执行 EXPLAIN ANALYZE:它会实际运行查询,并可能带来负载。
慢查询日志适合捕获间歇性问题,但启用前应确认版本、磁盘空间和当前参数,记录原值,并限制采集时段。没有慢日志也不代表数据库无关,因为连接池等待通常发生在数据库之外。
不要把终止会话作为第一步。终止事务可能触发回滚并影响业务;新增索引、改表或改写 SQL,也应先在测试环境验证结果一致性和执行计划,再安排生产变更及回退方案。
资源指标用于解释已经发现的等待,而不是替代请求级证据。Linux 环境可在复现时进行短时只读采样:
uptime
top -b -n 1
vmstat 1 10
如果已经安装 sysstat,可补充查看磁盘指标:
iostat -xz 1 10
这些命令不修改系统配置。vmstat 首行通常是启动以来的汇总,应重点关注后续采样。
CPU 持续繁忙且运行队列增长,才支持继续调查计算瓶颈;CPU 不高但请求堆积,更应关注锁和 I/O 等待。持续换页需要结合内存压力判断,磁盘等待也要与 SQL 扫描、日志写入或其他任务的时间对应,不能凭单个指标归因。
完成修复后,用相同接口、认证状态、数据范围和接近的并发条件复测,至少核对:
1. 客户端 TTFB、总耗时、状态码和业务结果是否恢复。
2. Web 入口上游计时,以及应用中的具体慢环节是否同步改善。
3. 超时率、错误率、连接池排队和锁等待是否下降。
4. 是否把原来的等待转移成了数据库过载、内存压力或更多重试。
一次请求变快可能只是缓存命中或流量下降。应持续观察一个有代表性的业务周期,同时保留故障前后的请求耗时和资源曲线。
后续监控重点放在动态接口延迟分位数、入口上游耗时、应用队列、连接池等待、慢查询和锁等待。把这些指标按统一时间与请求标识关联起来,新加坡服务器再次出现“静态正常、动态慢”时,就能直接追踪等待发生的位置,而不是反复通过重启试错。


