

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


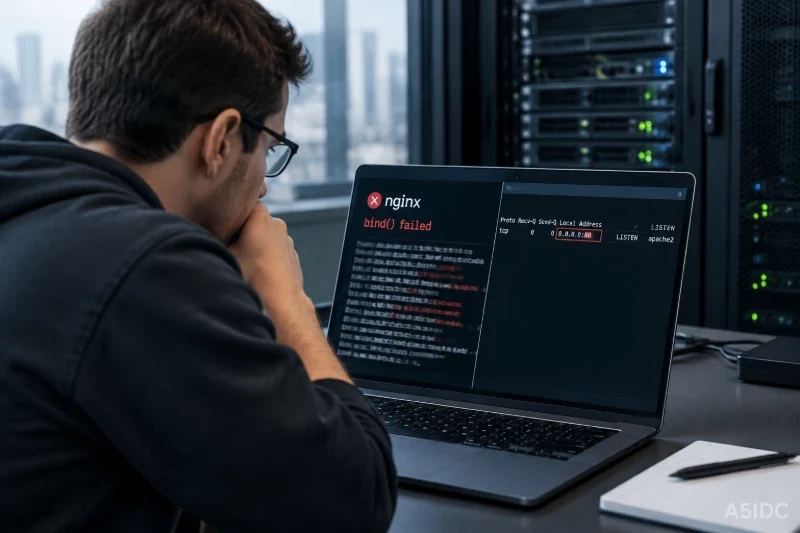
执行 systemctl start nginx 后返回失败,或者服务状态停留在 failed,只能说明启动流程没有完成。排查美国服务器上的这类问题,应先查看本次启动的错误记录:端口冲突、配置错误和权限不足都可能导致启动失败,但处理方法不同。
建议按“服务状态与日志 → 监听端口和进程 → 实际配置与权限 → 修复复测”的顺序检查。日志中出现 bind() ... failed (...: Address already in use),说明 Nginx 当时绑定该地址和端口失败;再用 ss 找到对应的监听进程,才能确认当前由谁占用。 单独看到 failed、[emerg] 或 still could not bind(),都不足以确定占用者。
以下命令适用于使用 systemd 管理 Nginx 的 Linux 美国服务器,需要具备 sudo 权限。示例服务名为 nginx.service;如果采用自定义安装或容器部署,应先确认实际管理方式,不要把宿主机服务与容器内服务混在一起排查。
先执行只读检查:
sudo systemctl status nginx.service --no-pager -l
sudo journalctl -u nginx.service -b -n 100 --no-pager -o short-iso
sudo systemctl cat nginx.service
三条命令分别用于确认:
failed、inactive,还是已经 active (running)。ExecStartPre、ExecStart 使用哪个 Nginx 程序,有没有指定 -c 配置文件、-p 前缀路径或其他参数。若服务单元不存在,应先核实安装方式和服务名,而不是继续套用后续启停命令。若服务仍然运行,则要区分“第二个实例启动失败”和“现有实例重载失败”,避免为排查而停止仍在提供服务的进程。
Nginx 自身日志的常见路径是 /var/log/nginx/error.log,但自定义安装可能不同。确认路径存在且属于当前实例后,再读取:
sudo tail -n 100 /var/log/nginx/error.log
错误日志路径由 error_log 配置或构建默认值决定;早期启动错误也可能只出现在标准错误输出和 systemd 日志中。日志文件不存在,不等于没有错误,更不能据此判断端口正常。
下面是典型的端口冲突日志示例,并非当前服务器的实测结果:
nginx: [emerg] bind() to 0.0.0.0:80 failed (98: Address already in use)
nginx: [emerg] bind() to [::]:80 failed (98: Address already in use)
nginx: [emerg] still could not bind()
其中:
bind():Nginx 正在为监听套接字绑定地址。0.0.0.0:80:尝试监听所有 IPv4 本地地址的 TCP 80 端口。[::]:80:尝试监听 IPv6 通配地址的 80 端口。Address already in use:该次绑定发生地址、端口使用冲突;Linux 上常见对应错误码为 98。判断时应以错误文字、地址、端口和时间为主,不要只记住错误码。
| 日志关键内容 | 通常说明什么 | 下一步 |
|---|---|---|
Address already in use | 该次绑定发生冲突 | 查询对应协议、地址和端口的占用者 |
Permission denied | 操作被权限或安全策略拒绝 | 根据报错对象检查绑定权限、文件权限或安全策略 |
Cannot assign requested address | 配置的监听地址在当前网络环境中不可用 | 核对本机地址与 listen 配置 |
unknown directive、unexpected ... | 配置语法或模块支持存在问题 | 按文件名和行号修正 |
cannot load certificate、open() ... failed | 证书、配置、日志等文件无法读取或打开 | 检查路径、权限及挂载状态 |
这些判断都有对象限制。例如,bind() ... Permission denied 指向监听权限;open() ... Permission denied 则指向文件访问,不能用同一种修复方式处理。
另外,同一个 Nginx 实例中,多个虚拟主机都写 listen 80; 通常是正常用法,不代表多个进程争抢端口。不要看到重复的 listen 80 就删除站点配置。
若日志指向 TCP 80 或 443,在宿主机直接运行 Nginx 的环境中执行:
sudo ss -ltnp 'sport = :80'
sudo ss -ltnp 'sport = :443'
日志如果报的是其他端口,应替换为实际端口。上述命令只读取当前状态;sudo 用于尽量完整地显示进程信息。
重点看三项:
1. Local Address:Port 是否与日志中的监听范围冲突。
2. users 中的进程名称是什么。
3. pid 对应哪个进程,是否属于目标 Nginx 服务。
不能只看端口数字:不同具体本地地址上的同号端口未必冲突;通配地址监听更容易与具体地址监听发生重叠。IPv6 监听是否同时覆盖 IPv4,还与套接字选项有关,应结合实际输出判断。
将查到的 PID 代入以下命令。示例中的 1234 只是占位值,必须替换:
ps -p 1234 -o pid,ppid,user,args
sudo systemctl status 1234 --no-pager -l
sudo systemctl show nginx.service -p MainPID -p ExecStart
ps 用于识别进程参数及父进程,systemctl status PID 可辅助判断它归属哪个服务单元。如果 PID 属于 Nginx worker,还应沿父进程确认 master。
常见分支有:
这不能推翻旧日志,只能说明查询时没有发现对应 TCP 监听者。可能是占用者已经退出、冲突短暂发生,或者检查的不是 Nginx 所在网络命名空间。
此时应核对日志时间和协议。若配置使用 QUIC/UDP,TCP 查询并不覆盖它,可针对日志端口执行:
sudo ss -lunp 'sport = :443'
容器内运行的 Nginx,需要在对应容器或网络命名空间内检查。只有确认服务已经停止、启动不会造成额外业务冲突后,才进行一次受控启动,并立即重新读取日志和监听状态,避免反复重试掩盖现场。
对于常规软件包安装,且已确认服务使用默认程序和配置时,可执行:
sudo nginx -t
sudo nginx -T
如果服务单元指定了自定义程序路径、-c 或 -p,测试时必须使用相同路径和影响配置加载的参数,否则可能出现“测试的是一套,启动的是另一套”。
-t 用于检查配置语法并尝试打开配置引用的文件;-T 还会输出完整配置,可核对 listen、include、error_log 等内容。完整配置可能包含敏感信息,不应未经脱敏公开。
nginx -t 成功不代表端口空闲,也不保证服务一定能启动。 它不能替代实际监听检查。
如果日志指向非本机地址,可只读核对:
ip address show
如果指向权限不足,应结合服务单元中的 User=、能力限制及系统安全日志判断。以管理员身份测试成功,也不一定能复现受限服务账户的运行环境。
不要使用 chmod -R 777,也不要为试错直接关闭 SELinux、AppArmor 或防火墙。普通防火墙过滤规则通常不会导致本地 bind() 返回地址占用错误。
若日志显示依赖任务失败,可检查:
sudo systemctl --failed --no-pager
sudo systemctl list-dependencies nginx.service --all --no-pager
只有日志明确指向依赖、挂载或文件缺失时,才继续沿该方向处理。
修改配置前,应备份实际要编辑的文件,并记录原来的监听地址、端口和服务状态。备份应放在不会被 Nginx include 匹配的位置,避免备份文件也被加载。
优先按以下原则处理:
listen 项。改变端口会改变访问入口,必须同时验证调用方和健康检查,不应把随意换端口当成修复完成。不要直接对占用进程执行 kill -9。这既可能中断业务,也可能触发管理器自动拉起,使冲突再次出现。若变更无效,应恢复本次修改的配置和原有服务状态,再继续定位。
再次确认配置测试通过。若 Nginx 当前处于停止或失败状态,再执行启动:
sudo systemctl start nginx.service
sudo systemctl is-active nginx.service
sudo systemctl status nginx.service --no-pager -l
sudo journalctl -u nginx.service --since "5 minutes ago" --no-pager
若服务已经运行,本次只是修改配置,并且服务单元支持重载,应在测试通过后使用 reload,避免不必要的重启:
sudo systemctl reload nginx.service
启动会使配置中的入口开始接收请求;重载会应用新配置,因此都应在业务允许的条件下进行。重载失败时,旧 worker 可能仍在服务,不能只凭 active 判断新配置已生效。
随后重新执行对应端口的 ss 查询,确认监听者属于预期实例。对于监听 IPv4 通配地址或回环地址的 HTTP 站点,可用真实域名替换示例值:
curl -I -H 'Host: www.example.com' http://127.0.0.1/
若只监听某个具体本地地址,应改用该地址;HTTPS 站点则应使用能够保留正确域名和 SNI 的方式验证,不要仅访问 IP 就判断证书或站点配置异常。检查响应是否符合预期,不能只认 200:跳转、认证或受限接口可能返回其他合理状态。
修复成立的标志是:服务状态正常、目标地址和端口由预期进程监听、本次启动没有新的绑定错误、站点请求符合预期。 随后继续观察错误日志;如果占用很快复现,应检查重复服务、自动拉起策略或计划任务,而不是反复停止进程。


