

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


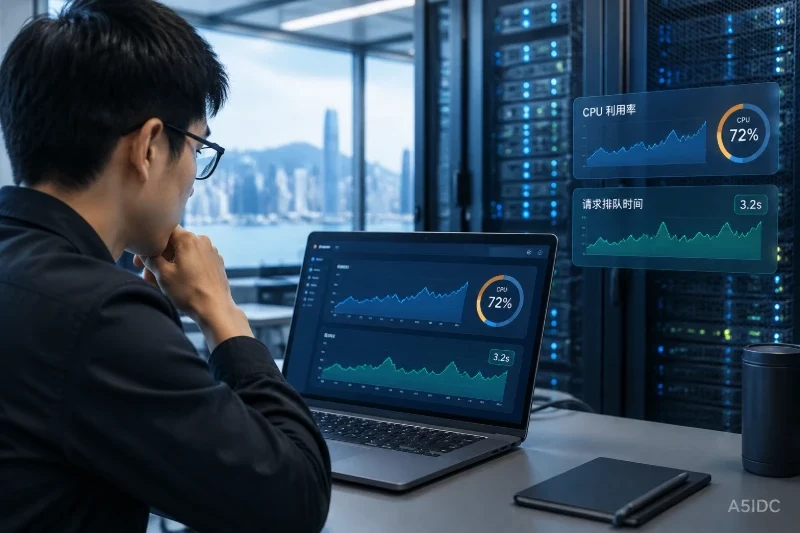
判断香港服务器是否需要扩容,应把CPU是否接近有效算力上限、请求排队时间是否持续增长、业务响应是否开始违约放在同一时间窗口内观察。单看CPU利用率高,无法证明容量不足;单看访问变慢,也不能确定增加CPU就能解决。
更可靠的扩容信号是:在请求类型基本一致的情况下,流量增加后CPU持续繁忙,请求排队时间明显上升,而完成请求的速度增长乏力,业务响应时间逼近或超过目标。如果CPU仍有余量,或者排队主要来自连接池、锁竞争、下游等待,就应先定位限制点,而不是直接扩容。
判断容量,核心不是寻找一个通用CPU百分比,而是确认服务器能否在业务允许的时间内消化请求。
建议把以下三组数据对齐观察:
这里的“持续”,应覆盖实际业务的典型高峰或完整突发过程,而不是某一次采样。不同业务的高峰长度不同,不宜套用固定观察时长。
容量不足的关键特征,是处理能力跟不上进入速度,并且这种差距已经造成无法接受的等待、超时或拒绝。CPU高只是解释原因的证据之一。
还应留意一种容易误判的情况:队列设有长度上限,或者请求会超时退出时,排队时间未必无限增长。此时队列可能保持高位,但拒绝和超时持续增加,这同样可能说明容量已经触顶。
多核服务器的总体CPU利用率,是多个核心使用情况的汇总。如果应用关键处理路径只能由一个线程执行,就可能出现某个核心持续繁忙、整机CPU却仍有余量的情况。
这时请求确实可能因计算处理不过来而排队,但增加核心数不一定有效。只有应用能够并行使用新增资源,增加核心或实例才可能转化为处理能力。
因此,看到“CPU不高但请求排队”时,应核对:
如果应用只能使用部分CPU资源,整机空闲不能证明应用还有可用算力;反过来,整机CPU高也可能由后台任务造成,不能全部归因于在线请求。
在常见Linux监控口径下,应区分用户态、内核态、I/O等待和虚拟化环境中的steal等指标,并确认监控面板如何计算“CPU利用率”。
用户态或内核态计算持续繁忙,并与请求队列同步增长,更支持计算能力不足的判断。I/O等待偏高提示需要检查存储等等待来源;steal偏高则提示虚拟CPU获得执行时间受到影响,不能直接当成应用消耗了同等算力。
系统负载也不能替代CPU利用率:Linux load average还可能包含不可中断睡眠任务。负载高不等于CPU计算能力已经耗尽,系统运行队列也不等于应用请求队列。
同样的CPU利用率,对不同服务的意义不同:
更实用的方法是找出本业务的性能拐点:随着负载提高,CPU继续上升,但完成吞吐增长开始变慢,排队时间明显变长。日常高峰应与这个拐点保留余量,余量大小取决于流量波动、业务目标和扩容生效速度,而不是套用固定比例。
请求排队时间,是请求进入某个待处理队列,到获得该队列对应处理资源之间的等待时间。它不等于总响应时间,也不等于业务代码执行时间。
一个请求可能先等待工作线程,执行过程中又等待连接池或下游结果。这些等待属于不同环节,不能统称为“CPU排队”。
最直接的测量方法,是在同一排队环节记录两个时间点:
该环节排队时间 = 获得处理资源的时刻 - 进入待处理队列的时刻
测量前要明确埋点边界。例如,请求接收时刻是否包含请求体上传过程,获得线程后是否还需要等待连接。若边界不清,上传或下游等待可能被误记为应用排队。跨主机时间戳还可能受到时钟偏差影响,宜优先使用同一组件直接记录的等待时长。
平均排队时间可能掩盖少量请求的长时间等待。P95、P99用于观察较慢那部分请求,适合识别高峰期的尾部恶化,但低流量窗口中的高分位数容易波动,应同时查看样本量。
排队是否过长,应由业务允许的响应时间反推:
可用于排队的时间预算
= 业务响应时间目标 - 必要处理及其他环节的时间预算
这是一种预算分配方法,不意味着可以直接用“总响应P99减去执行P99”得到排队P99。不同阶段的分位数不能简单相加减,最好结合请求级追踪核对。
还应将耗时差异明显的接口分开观察。否则,只是慢接口占比上升,也可能让整体排队指标看起来像容量退化。
短暂排队不一定需要扩容。如果业务允许等待,突发结束后队列能及时回落,且响应目标、超时率仍然达标,现有容量可能足够。
反之,如果高峰期间队列不断积压,高峰结束后仍长时间无法消化,说明处理能力与负载不匹配。此时应进一步确认,限制处理速度的是CPU,还是其他受限资源。
以下判断以监控时间对齐、请求类型可比、采样未掩盖短时峰值为前提:
| 观察到的现象 | 更可能的解释 | 对扩容的含义 |
|---|---|---|
| CPU持续繁忙,排队增长,完成吞吐趋于平台 | 有效计算能力可能接近上限 | 优先验证增加可用CPU是否有效 |
| CPU较高,排队稳定,响应仍达标 | 资源使用充分,尚未出现明显容量缺口 | 不必仅因CPU高立即扩容,但要评估高峰余量 |
| 总体CPU不高,排队持续增长 | 局部核心饱和、并发限制或其他等待 | 先定位排队位置,不能直接判定整机容量不足 |
| CPU与排队都低,但访问仍慢 | 慢点更可能不在当前计算队列 | 增加CPU通常缺少依据 |
| 队列高位不再增长,超时或拒绝增加 | 队列上限、超时退出可能掩盖积压 | 结合进入量、完成量及失败量确认是否过载 |
“CPU高、排队高”仍不是最终证明。例如,无效重试或异常循环也可能同时推高两者。因此还需要验证:新增算力能否提高有效请求的完成速度。
验证前,应准备好业务响应目标、代表性高峰数据,以及能区分进入请求量、完成请求量和失败量的监控。负载试验宜在隔离环境或受控范围内进行;生产验证应预设停止条件,避免持续加压扩大影响。
可按以下顺序验证:
1. 固定对比条件。尽量保持接口比例、数据规模、缓存状态和后台任务一致,避免把工作负载变化误认为容量变化。
2. 观察负载上升过程。确认CPU、排队分位数和完成吞吐是否出现稳定的关联,而不是只比较两个孤立峰值。
3. 只改变一个容量因素。在应用能够使用新增资源的前提下,增加可用CPU或可独立分担请求的实例,再比较同等负载下的表现。
4. 检查有效改善。排队时间下降、业务响应恢复达标,且可承载的有效吞吐提高,才支持扩容方向正确。
如果CPU下降了,但排队没有改善,说明瓶颈可能转移或原本就在其他环节。如果增加实例后等待反而加重,应检查是否把更多并发压向同一个受限下游。单纯延长超时或扩大队列,只是允许请求等得更久,不能证明处理能力提高。
对于香港服务器,可执行的扩容标准是:典型高峰下排队已消耗业务时间预算,有效CPU处理能力确实受限,并且受控验证表明新增资源能降低等待、提高有效吞吐。三项同时成立,就有较充分的扩容依据;若仅有CPU高或响应慢,应先补齐证据。若当前尚未违约,但预计负载将在扩容生效前越过已验证的性能拐点,则应提前安排容量,而不是等到超时集中出现后再行动。


