

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


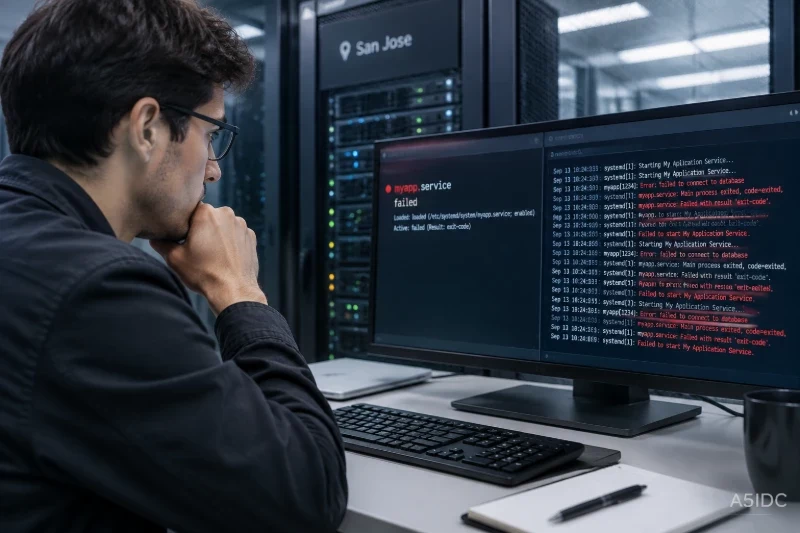
服务启动命令返回失败、进程刚出现就退出、端口始终没有监听,都会造成业务不可用,但原因并不相同。在圣何塞服务器上遇到这类问题,应先区分:是 systemd 没能执行程序,还是程序启动后自行报错退出,或者服务实际已运行、只是访问失败。远程连接失败不等于服务启动失败,active 也不等于业务已经就绪。
建议按低风险到高风险的顺序检查:先保存 systemctl status 和同一时间窗口的日志,再根据退出状态核对启动命令、配置与权限,随后检查端口和依赖,最后处理资源限制并验证恢复。以下命令适用于使用 systemd 管理服务的 Linux 系统;将示例中的 myapp.service 替换为真实单元名,8080 替换为实际业务端口。查询操作通常不会改变运行状态,但读取完整日志可能需要管理员权限;日志对外分享前应遮盖凭据和业务敏感信息。
暂时不要连续重启,先保留当前状态和报错:
sudo systemctl status myapp.service --no-pager -l
sudo systemctl show myapp.service \
  -p LoadState -p ActiveState -p SubState -p Result \
  -p ExecMainCode -p ExecMainStatus -p NRestarts
sudo journalctl -u myapp.service -b \
  --since "15 minutes ago" --no-pager -o short-iso
status 适合快速识别失败点,但只显示部分近期日志;journalctl 用于还原完整时间线。-b 限定当前启动周期,如果故障发生在重启之前,应先用 journalctl --list-boots 确认是否保留了历史记录,再查询对应启动周期。
| 观察结果 | 通常意味着什么 | 下一步 |
|---|---|---|
LoadState=not-found | 单元名错误,或单元文件未被识别 | 核对名称、文件位置及是否需要重新加载 |
failed,伴随执行阶段错误 | 可能尚未进入应用初始化 | 检查启动路径、运行用户和工作目录 |
status=1/FAILURE 等非零退出 | 程序或启动脚本报告失败 | 查找退出前的应用错误 |
Result=timeout | 启动流程未在期限内完成 | 检查依赖等待、启动模式及就绪通知 |
start-limit-hit | 多次启动触发 systemd 频率限制 | 查找更早的第一次失败 |
active (running),但访问失败 | 进程在运行,业务未必可用 | 核对监听地址、端口和本机请求 |
enabled 只表示设置了相应的启动关联,不代表当前正在运行。active (exited) 对某些一次性任务可能正常;若对象本应是常驻服务,则需要结合 Type= 和启动方式判断。
日志末尾的 Failed to start、Main process exited 往往只是结果。真正有用的是它们之前的错误,例如:
No such file or directory:启动路径、解释器、配置文件或依赖文件缺失。Permission denied:文件权限、目录访问权限或安全策略阻止了操作。Address already in use:绑定的地址与端口发生冲突。Connection refused:连接目标在当时拒绝了连接,需核查依赖服务是否监听。No space left on device:空间、inode 或相关存储限制可能耗尽。只有错误时间与本次启动一致,并且能解释进程退出,才应将其作为根因线索。 旧日志中的端口冲突,不能直接解释本次配置解析失败。
查看 systemd 实际加载的定义:
sudo systemctl cat myapp.service
sudo systemctl show myapp.service \
  -p FragmentPath -p DropInPaths \
  -p ExecStart -p User -p Group -p WorkingDirectory \
  -p StandardOutput -p StandardError
如果 journal 中只有管理器的失败提示,应根据应用配置继续查找文件日志。不能假定所有应用错误都进入 journal;输出去向、日志权限和应用自身的日志设置都会影响可见性。若找不到任何启动记录,还应确认时间范围、单元名以及日志是否被保留。
例如,若日志依次出现“读取配置失败”“程序退出”“systemd 标记失败”,排查应落到配置文件,而不是先调整重启策略。
systemd 中常见的 203/EXEC 表示执行程序阶段失败,但不只意味着“文件不存在”,也可能涉及执行权限、脚本解释器或文件系统挂载选项。200/CHDIR 指向工作目录切换失败,217/USER 指向用户凭据设置阶段的问题。
重点核对 ExecStart=、WorkingDirectory=、User=,以及程序依赖的环境文件。交互式终端能启动,不代表 systemd 能启动:服务通常不会读取用户的 .bashrc,其工作目录、环境变量和权限也可能不同。
另外,ExecStart= 默认不是 shell 命令行,不能直接把管道、重定向等终端写法照搬进去。
对于程序声明支持的配置检查或 dry-run 模式,应优先使用,并指定服务实际读取的配置文件。不要猜测通用的 --test 参数,也不要在已有实例运行时直接执行正常启动命令,以免重复监听或写入业务数据。
以下路径和账户仅作示例,替换后再执行:
namei -l /opt/myapp/bin/myapp
namei -l /etc/myapp/config.conf
sudo -u appuser test -r /etc/myapp/config.conf
echo $?
namei -l 可逐层查看目录权限,部分系统需安装相应工具。紧随 test 的退出码为 0,表示以该用户身份测试读取权限成功;非零则表示测试未通过。即使文件可读,父目录缺少搜索权限也会导致访问失败。
这里的用户身份测试不能完整复现 systemd 沙箱和安全策略。若普通权限正常,还应核对:
ProtectSystem=、ReadWritePaths= 等限制是否覆盖目标路径。不要用 chmod -R 777 或关闭安全机制试错。确需调整权限时,应先记录属主、权限和 ACL,只修改已证实有问题的路径;影响范围是该路径的访问能力,失败后应恢复原记录。安全策略则应针对具体拒绝原因修正。
先查看本机监听情况:
sudo ss -ltnp 'sport = :8080'
sudo ss -lunp 'sport = :8080'
ip address show
TCP 和 UDP 分别检查,避免协议不一致造成误判。
如果日志出现 Address already in use,且 ss 显示该地址、端口已有监听,应确认占用进程是谁。可能是旧实例、另一项服务,也可能是预期的 systemd socket 激活机制,不能看到占用就直接结束进程。
如果是 Cannot assign requested address,则应比较配置中的监听 IP 与本机实际地址。它通常指向绑定地址不存在,不应按端口冲突处理。
停止旧实例或修改监听地址前,先确认业务归属、备份配置并评估中断范围;应通过原管理方式停止已确认的实例。若调整无效,恢复原配置及原服务状态。不要先清空防火墙规则:防火墙通常影响访问,并不能解决程序本地绑定失败。
检查 systemd 层面的依赖和失败单元:
sudo systemctl list-dependencies myapp.service --all
sudo systemctl --failed
随后对日志指向的依赖服务分别查看状态和日志。应用也可能连接未写入单元依赖关系的数据库、缓存或远程接口,因此依赖列表不是完整的业务依赖清单。
需要区分三个概念:
After= 控制启动顺序,不会单独把目标服务拉起。Requires=、Wants= 表达不同强度的启动依赖关系。如果程序因连接依赖失败而退出,应使用依赖自身的健康检查确认就绪,并核查地址、认证与超时配置。不要仅增加固定休眠时间。
若依赖正常但 systemd 仍等待超时,再检查 Type= 是否与程序行为匹配:例如 Type=notify 需要程序发送就绪通知,Type=forking 需要匹配后台派生行为。只有证实初始化确实需要更长时间,才考虑调整启动超时。
进程被突然终止、日志写到一半中断,或出现写入失败时,再检查资源与内核事件:
df -h
df -i
free -h
sudo journalctl -k -b --since "15 minutes ago" --no-pager
sudo systemctl show myapp.service \
  -p MemoryMax -p TasksMax -p LimitNOFILE
判断时需要相互印证:
SIGKILL 不足以证明 OOM,应结合内核记录或相关内存事件。Too many open files 时,再核对文件描述符限制及应用使用量。清理空间前应确认文件归属、备份与保留要求,不要直接删除数据库文件或正在使用的日志。调整资源限制也应记录原值,确认主机承受能力,无效时回滚。
每次只修改一个已经有证据支持的问题,便于确认因果。修改前保存配置和单元覆盖文件;修改失败时恢复对应备份,不要为了回滚一个参数而移除全部覆盖配置。
如果修改了 systemd 单元或 drop-in 文件,先执行:
sudo systemctl daemon-reload
仅修改应用配置通常不需要这一步。确认根因已处理、且服务处于停止或失败状态后,可在允许业务恢复的窗口执行:
sudo systemctl reset-failed myapp.service
sudo systemctl start myapp.service
sudo systemctl status myapp.service --no-pager -l
sudo journalctl -u myapp.service --since "5 minutes ago" --no-pager
reset-failed 会清除失败状态及相关计数,不会修复根因,因此应在留证之后使用。启动可能恢复对外流量;若服务仍在运行而需要重启,应另外安排中断窗口。
恢复验证至少覆盖三层:
1. 管理状态:常驻服务保持运行,NRestarts 不再持续增加,没有新的启动错误。
2. 本机功能:实际地址和端口正确监听,使用服务对应协议完成健康检查,而不只是确认进程存在。
3. 访问路径:本机正常后,再从实际访问端验证;若只有远程失败,转向访问控制和网络路径检查,不再反复修改启动配置。
对圣何塞服务器上的长期运行服务,建议持续关注失败状态、重启次数增量、就绪耗时、端口与业务健康检查,以及磁盘、inode 和依赖可用性。保留“首次错误、对应时间、修改项、恢复结果”,下次出现相似症状时,才能迅速判断是旧问题复发,还是不同原因造成了相同表象。


