

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


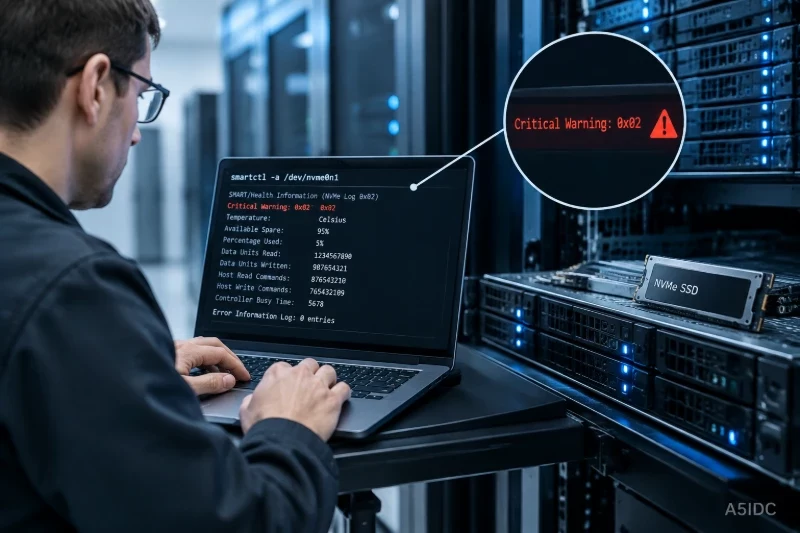
美国服务器上的 NVMe SSD 固态硬盘验收,目标不只是看到 PASSED,而是确认:设备身份正确、健康日志可读取、关键告警为零,且在正常业务观察期间没有新增介质错误或温度告警。检查应先使用只读命令,不为“验证健康”直接进行全盘写入、格式化或固件升级。
在 Linux 系统中,确认设备路径后,可用 sudo smartctl -x /dev/nvme0 获取详细信息。优先查看 Critical Warning、Available Spare、Percentage Used 和 Media and Data Integrity Errors;其中 Critical Warning: 0x00 只是没有触发该字段定义的告警,不等于硬盘不存在故障风险。
以下操作适用于能够直接访问 NVMe 设备、且安装了支持 NVMe 的 smartmontools 的 Linux 主机,需要具备相应设备读取权限。先核对工具与磁盘:
command -v smartctl
smartctl --version
lsblk -o NAME,TYPE,SIZE,MODEL,SERIAL,MOUNTPOINT
sudo smartctl --scan
这一步应确认三个边界:
/dev/nvme0 通常是 NVMe 控制器设备,/dev/nvme0n1 是其命名空间块设备,不能把编号不同直接理解为不同物理硬盘。lsblk 的设备树核对。设备路径可能在重启后变化。后续对比必须同时核对序列号、型号和固件版本,不能仅凭 /dev/nvme0 判断是同一块盘。
如果扫描没有发现 NVMe 设备,或输出显示的是虚拟磁盘,应先确认物理设备是否向当前系统开放,不要不断更换 -d 参数猜测设备类型。
本次检查不修改硬盘配置,也不主动写入测试数据。smartctl -x 用于读取设备信息与日志,不执行介质自检;但它仍会向控制器发送管理请求,对于已经频繁超时、掉盘的设备,不宜高频重复读取。
执行前应确认现有备份可恢复,并记录当前业务错误、磁盘只读状态和维护窗口。如果设备已经出现严重告警,应优先保护数据,而不是先跑压力测试证明它“还能用”。
如果系统没有 smartctl,应按实际发行版的软件管理流程安装 smartmontools。生产环境不应为了检查磁盘而顺带进行全系统升级。
以下示例在 Bash 中执行,设备路径必须替换为核对后的实际对象。日志目录放在容量充足、适合留证的位置:
device=/dev/nvme0
logdir="$HOME/nvme-health-$(date -u +%Y%m%dT%H%M%SZ)"
mkdir -p "$logdir"

{
  date -u '+%Y-%m-%dT%H:%M:%SZ'
  uname -r
  smartctl --version
  lsblk -o NAME,TYPE,SIZE,MODEL,SERIAL,MOUNTPOINT
} > "$logdir/context.txt" 2>&1

sudo smartctl -x "$device" > "$logdir/baseline.txt" 2>&1
rc=$?
printf '%s\n' "$rc" > "$logdir/baseline.exit"
cat "$logdir/baseline.txt"
这里将完整输出和退出码分别保存,避免只截图一行 PASSED,遗漏设备身份、命令错误或历史计数。日志可能包含序列号、主机信息与挂载路径,对外提交前应脱敏,但内部应保留原件。
Critical Warning 是位掩码,不是告警数量Critical Warning 可以同时包含多个告警。常见低五位含义如下:
| 掩码 | 含义 | 验收处理 |
|---|---|---|
0x01 | 可用备用空间低于设备设定阈值 | 不按正常状态验收,核对备用空间与阈值 |
0x02 | 温度越过设备定义的相关阈值 | 核对当前温度、设备阈值和温度告警累计时间 |
0x04 | NVM 子系统可靠性下降 | 暂停验收,结合介质错误及设备日志处理 |
0x08 | 介质已进入只读状态 | 立即检查业务写入影响,优先保护数据 |
0x10 | 易失性存储器备份装置失效 | 对实现该功能的设备,按硬件告警处理 |
例如,0x04 表示可靠性下降;0x0c 等于 0x04 + 0x08,表示可靠性下降与介质只读同时存在,不能解释为“有 12 个错误”。
部分规范版本还定义了其他告警位。出现上表之外的置位时,应结合当前 smartctl 的解码文本、设备规范和厂商资料确认,不能因为不认识该位就忽略。
用于正常状态验收时,Critical Warning 应为 0x00;任何非零值都应暂停通过,查明具体置位原因。
| 字段 | 判断依据 | 需要关注的边界 |
|---|---|---|
Available Spare | 与 Available Spare Threshold 对比 | 低于阈值会触发相应告警;等于阈值也已缺乏余量,不宜仅因没有置位就通过 |
Percentage Used | 厂商对已消耗耐久度的估计 | 达到或超过 100% 表示估计耐久度已消耗完,不等于此刻必然停止工作 |
Media and Data Integrity Errors | 设备记录的未恢复数据完整性错误累计数 | 非零须查明历史原因;观察期间新增应暂停验收 |
Error Information Log Entries | 错误信息日志条目的累计计数 | 不等于坏块数,应检查错误类型及是否持续增长 |
Temperature | 与设备实际提供的温度阈值对比 | 不应套用一个适合所有 NVMe SSD 的固定温度 |
| 温度告警累计时间 | 比较前后快照是否增长 | 当前温度正常,不能抹去历史超温;新增说明窗口内出现过越界 |
还需避免三种误读:
Percentage Used: 0% 不证明硬盘从未使用过,整数显示和厂商估算方法都会影响结果。Unsafe Shutdowns 是非正常关机累计次数,不是闪存损坏次数;若持续增长,应结合断电、异常重启记录排查。对于要求“无历史介质错误”的交付验收,可将 Media and Data Integrity Errors = 0 作为明确条件。对于在役设备,历史非零值需要结合已知事件评估,但不能据此放宽对新增错误的处理。
PASSED 和退出码都不能单独作为验收结论SMART overall-health self-assessment test result: PASSED 是汇总结果,不是一次全盘读取测试的结论,也不是性能或数据完整性保证。
smartctl 的退出状态采用位掩码,非零可能涉及参数问题、设备打开失败、命令执行失败或健康异常等。应结合当前版本的 man smartctl 和完整输出判断。
常见结果分支如下:
首次快照只能说明检查时刻及历史累计状态。对于待交付或准备恢复业务的美国服务器,应在正常、可控的业务负载下再次采样,不额外安排全盘写入或高压力基准测试。
在保留前述变量的同一 Bash 会话中执行:
sudo smartctl -x "$device" > "$logdir/observe.txt" 2>&1
rc=$?
printf '%s\n' "$rc" > "$logdir/observe.exit"

diff -u "$logdir/baseline.txt" "$logdir/observe.txt" \
  > "$logdir/compare.diff"
diff 返回有差异是正常现象,不代表磁盘故障。通电时间、读写量和温度可能自然变化,应重点核对:
1. 序列号、型号一致,确认比较对象未变。
2. Critical Warning 仍为 0x00。
3. 备用空间未进入阈值边界,耐久度符合约定用途。
4. 介质与数据完整性错误没有新增。
5. 温度告警累计时间没有增长;错误日志计数增长时,已经解释对应原因。
在使用 systemd 日志的主机上,还可保存对应时段的内核记录:
sudo journalctl -k --since "30 minutes ago" --utc --no-pager \
  > "$logdir/kernel.txt"
将时间范围调整为实际观察窗口,检查 NVMe 超时、控制器复位、I/O 错误或设备消失等记录。此类现象即使没有同步触发 SMART 告警,也不能忽略;但仅凭这些记录也不能断定一定是 SSD 介质损坏。
完整留证应包括设备身份、工具版本、UTC 采样时间、前后原始输出、退出码、内核日志及当时负载说明。若日志保存在被怀疑故障的盘上,应尽快复制到独立留证位置。
观察窗口至少应覆盖接入前的低负载状态,以及接入后一个有代表性的正常业务负载周期。具体时长由业务周期和维护窗口确定,不用一次短暂空闲采样替代持续观察;间歇性故障还应覆盖原先容易出现问题的时段。
只读检查本身没有磁盘配置需要回滚。这里的回退对象是“继续交付、扩大负载或恢复承载业务”的动作。出现以下情况,应停止推进:
Critical Warning 置位。已经接入业务时,应按既有迁移或故障切换方案回退;没有可用冗余时,先安排数据保护和维护窗口,不要直接拔盘、强制重启或继续加压。保留告警前后的原始日志,再进入硬盘更换或进一步诊断流程,才能让验收结果既可解释,也可追溯。


