

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


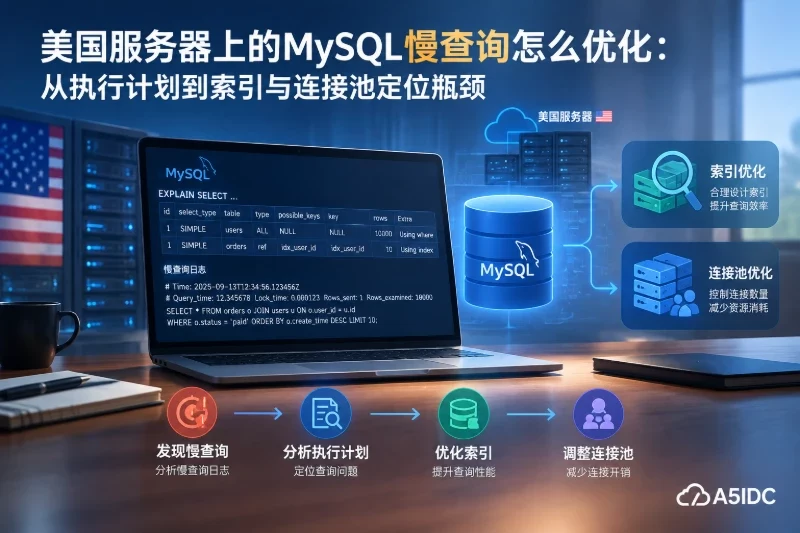
很多人看到美国服务器上的 MySQL 查询变慢,第一反应是“给字段加索引”或“把连接池调大”。这两种处理在特定条件下都可能有效,但都不是通用答案:慢查询可能卡在扫描行数、排序临时表、锁等待、连接建立、连接池排队,甚至是应用与数据库之间的网络往返。更稳妥的做法是先用慢查询日志和 EXPLAIN 确认执行路径,再分别判断索引、SQL、连接池和服务器资源是否构成瓶颈。
核心判断可以概括为:执行计划显示扫描或排序成本高,优先优化 SQL 和索引;执行计划正常但等待时间长,检查锁、连接池和资源;只有在确认连接建立或跨网络往返占比明显时,才调整连接复用和访问路径。
应用记录的接口耗时,通常包含多个阶段:
1. 从连接池获取连接;
2. 建立或复用数据库连接;
3. 发送 SQL;
4. MySQL 执行和等待锁;
5. 返回结果集;
6. 应用读取、反序列化和后续处理。
而 EXPLAIN 主要用于分析优化器选择的执行计划,并不能直接说明连接池排队或应用处理结果集花费了多少时间。因此,单看接口总耗时就修改索引,容易把问题定位错。
可以先把应用日志中的以下时间拆开:
如果只有“获取连接”耗时明显增加,而数据库内实际执行时间正常,问题更接近连接池容量、连接泄漏或连接释放不及时,而不是索引。
慢查询日志适合发现重复出现、影响较大的 SQL。生产环境启用前应确认磁盘空间、日志轮转和权限配置,避免日志快速增长影响数据库所在磁盘。
先查看当前配置:
SHOW VARIABLES LIKE 'slow_query_log';
SHOW VARIABLES LIKE 'slow_query_log_file';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'log_queries_not_using_indexes';
SHOW VARIABLES LIKE 'min_examined_row_limit';
如果需要临时降低慢查询阈值进行排查,可以使用动态配置。具体是否可动态修改取决于 MySQL 版本和权限:
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
这里的 1 只是示例阈值,不应直接视为所有业务的标准。阈值应根据接口目标、查询频率和数据库负载设定。排查结束后,应恢复到合适值,并通过配置文件或正式配置管理保证重启后行为一致。
不建议一开始就长期启用“未使用索引查询”日志。某些合法查询,例如小表全表扫描、低选择性字段过滤,可能本来就不需要索引;大量记录这些查询会增加噪声。
EXPLAIN 的关键列对目标查询先执行:
EXPLAIN
SELECT id, status, created_at
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50;
重点关注以下字段:
| 字段 | 主要含义 | 需要关注的情况 |
|---|---|---|
type | 表访问方式 | ALL 通常表示全表扫描,但小表不一定是问题 |
possible_keys | 优化器认为可能使用的索引 | 为空时检查过滤条件、字段类型和索引定义 |
key | 实际选择的索引 | 为 NULL 时需要解释原因 |
key_len | 实际使用的索引长度 | 联合索引未使用完整部分时需进一步分析 |
rows | 优化器估算要检查的行数 | 数量较大且查询频繁时风险更高 |
filtered | 经过条件过滤的估算比例 | 与 rows 一起判断扫描和过滤成本 |
Extra | 额外执行信息 | 关注临时表、额外排序、回表等线索 |
type = ALL 并不等于“必须立刻加索引”。如果表很小,全表扫描可能比走索引更快;如果条件字段只有两种值,索引选择性低,优化器也可能有意放弃索引。正确判断要结合实际数据量、查询频率和执行耗时。
EXPLAIN ANALYZE 验证实际执行过程支持该语法的 MySQL 版本可以使用:
EXPLAIN ANALYZE
SELECT id, status, created_at
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50;
它会实际执行查询并返回估算值与实际执行情况。对包含写操作、调用副作用函数或可能返回大量数据的语句,必须先确认语句性质和执行影响。生产环境执行前应使用只读副本、测试环境或低峰时段,并限制结果集范围。
如果 EXPLAIN 估算扫描行数很小,但 EXPLAIN ANALYZE 显示实际扫描远大于估算,常见原因包括:
可以在确认业务允许的前提下更新统计信息:
ANALYZE TABLE orders;
该操作可能读取表数据并产生资源消耗,不宜在高峰期对大表随意执行。执行前应确认表引擎、业务窗口和监控状态;如果更新后计划变差,应记录原执行计划,并通过调整索引、SQL 或版本化配置回退,而不是反复执行操作。
例如查询条件为:
SELECT id, created_at, amount
FROM orders
WHERE user_id = 10001
  AND status = 'paid'
  AND created_at >= '2026-01-01'
ORDER BY created_at DESC
LIMIT 50;
可以评估类似下面的联合索引:
CREATE INDEX idx_orders_user_status_created
ON orders (user_id, status, created_at);
这个索引是否有效,取决于实际数据分布和查询比例。通常应优先放置能够稳定缩小结果集的等值条件,再考虑范围条件和排序字段,但不能把它当成机械规则。若 status 取值极少而 user_id 区分度高,先放 user_id 往往更有意义;若业务还有大量只按 status 查询的语句,则需要单独评估这些访问模式。
添加索引前先检查现有索引,避免重复或高度重叠:
SHOW INDEX FROM orders;
索引不是免费资源,会增加写入、更新、删除成本,并占用磁盘和缓冲池空间。对高频写入表,新增索引应先在测试环境或结构相近的环境验证,观察写入延迟、锁等待、磁盘使用和查询计划。
以下写法可能让普通索引难以发挥作用:
-- 可能导致对列逐行计算
WHERE DATE(created_at) = '2026-01-01'

-- 可能发生隐式类型转换
WHERE user_id = '10001'

-- 前缀通配符通常无法有效使用普通B树索引
WHERE email LIKE '%@example.com'
可以改为范围条件:
WHERE created_at >= '2026-01-01 00:00:00'
  AND created_at <  '2026-01-02 00:00:00'
字段类型应在表结构和应用参数中保持一致。对于字符串搜索、表达式索引或生成列,必须结合 MySQL 版本、字符集、排序规则和业务需求验证,不能仅凭 EXPLAIN 中出现索引名称就判断优化成功。
SELECT * 放大回表和网络传输如果接口只需要少量字段,应明确列名:
SELECT id, status, created_at
FROM orders
WHERE user_id = 10001
ORDER BY created_at DESC
LIMIT 50;
返回列减少后,可能降低磁盘读取、回表、网络传输和应用解析成本。但“覆盖索引”只有在索引包含查询所需列、且优化器确实选择该索引时才成立。索引中加入过多字段会增大索引体积和写入成本,因此不应为了覆盖查询无限扩展索引。
如果 SQL 的扫描行数、索引选择都合理,但执行时间仍然波动,应查看当前事务和锁等待。可先使用:
SHOW FULL PROCESSLIST;
在支持相应视图的 MySQL 版本中,也可以检查 InnoDB 状态:
SHOW ENGINE INNODB STATUS\G
重点观察:
不要看到锁等待就直接终止线程。KILL 可能触发回滚,回滚时间甚至长于原事务执行时间,还可能影响依赖该事务的其他请求。执行终止操作前,应记录线程、事务、业务影响和回滚方案,并确认应用能够正确重试。
在美国服务器上,数据库资源指标应与慢查询时间对齐观察,而不是只看某一时刻的 CPU 使用率。至少记录以下指标:
| 指标 | 可能说明的问题 |
|---|---|
| CPU 长时间升高 | 计算、排序、函数处理或并发过高 |
| 磁盘读写延迟升高 | 数据未命中缓存、临时表或写入压力增加 |
| 内存和缓冲池命中情况 | 热数据无法稳定保留,读取更依赖磁盘 |
| 活跃连接数 | 并发增加、连接泄漏或池配置不合理 |
| 锁等待时间 | 事务设计、更新范围或提交时机存在问题 |
| 临时表、临时文件增长 | 排序、分组或结果集处理成本较高 |
| 网络接收和发送量 | 返回结果过大或应用与数据库交互过于频繁 |
资源指标只能帮助缩小范围,不能单独证明某个索引一定有效。例如 CPU 低并不代表没有数据库问题,查询可能正在等待磁盘、锁或网络;CPU 高也不一定需要增加连接数,盲目增加并发可能进一步放大锁和 I/O 压力。
连接池常见的错误判断是:接口变慢,所以把最大连接数继续调大。只有在数据库仍有可用处理能力、应用确实长时间等待空闲连接时,增加池容量才可能缓解问题。
建议在应用侧记录:
不同结果对应的方向不同:
连接池上限应同时受数据库最大连接数、应用实例数量、后台任务和管理连接约束。多实例部署时,单实例池上限不能只按单台应用计算,否则总连接数可能超过数据库承载范围。
以下做法通常比盲目扩容连接池更直接:
连接池参数名称因语言和框架不同,不能直接套用其他系统的配置。修改前应确认连接池实现、连接超时、空闲回收、最大生命周期和数据库服务端超时的关系。配置变更应分批发布,并保留原参数作为回滚值。
如果查询结果高度重复、变化频率低,缓存可以减少数据库读取;但缓存不能修复错误的执行计划,也不能替代必要的权限和一致性校验。涉及订单状态、库存、权限等数据时,应先定义允许的过期时间、主动失效方式和异常回源策略。
深分页也是常见慢查询来源:
SELECT id, created_at, amount
FROM orders
WHERE user_id = 10001
ORDER BY created_at DESC
LIMIT 100000, 50;
随着偏移量增大,数据库可能需要扫描并丢弃大量行。若业务允许,可以使用基于上一页排序键的连续分页:
SELECT id, created_at, amount
FROM orders
WHERE user_id = 10001
  AND (
       created_at < '2026-02-01 12:00:00'
       OR (
          created_at = '2026-02-01 12:00:00'
          AND id < 900000
       )
  )
ORDER BY created_at DESC, id DESC
LIMIT 50;
这种方式要求排序字段组合具备稳定的唯一顺序,并且索引与过滤条件相匹配。若数据会频繁插入、更新或删除,还需要验证翻页过程中是否出现重复或遗漏。
可以按以下顺序处理单条慢查询:
1. 记录原始状态:保存 SQL、参数范围、执行时间、返回行数、当前 EXPLAIN、相关资源指标和锁等待信息。
2. 确认问题阶段:区分连接池获取、数据库执行、结果读取和应用处理耗时。
3. 检查执行计划:查看访问类型、实际索引、估算行数、排序和临时表线索。
4. 验证数据与统计信息:确认字段类型、数据分布、统计信息是否过期。
5. 先改 SQL,再评估索引:减少无用列、避免对索引列做函数计算,检查分页和排序方式。
6. 在测试环境添加索引:比较查询耗时、写入成本、索引体积和新旧执行计划。
7. 检查锁和连接池:确认是否存在长事务、连接泄漏、池中排队或并发过高。
8. 小范围发布并观察:关注慢查询数量、P95/P99 延迟、CPU、I/O、锁等待和错误率。
9. 准备回滚:保留原 SQL、旧索引定义和连接池参数;删除索引或恢复配置前,确认没有依赖该索引的新查询。
删除索引同样属于有影响的数据库操作,不应直接在高峰期执行。先确认索引依赖关系和备份可用性,再选择维护窗口;如果数据库版本支持在线 DDL,也要确认具体算法、锁级别和表引擎行为,不能仅凭“在线”二字认为不会影响业务。
EXPLAIN 显示使用索引,但查询仍然慢可能是索引选择性不足、回表行数过多、排序仍在索引外完成,或者真正耗时来自锁等待。应结合 rows、Extra、实际执行分析和锁状态判断,而不是继续增加相似索引。
这通常说明索引维护成本已经显现。应检查索引是否重复、是否被多个查询使用、是否可以缩小索引列,必要时撤销未经验证的索引变更。撤销前先确认没有其他关键查询依赖该索引。
这往往意味着数据库资源或锁竞争已经成为瓶颈。恢复原连接池配置,检查活动连接、事务持有时间和数据库资源使用,再通过降低并发、缩短事务和优化慢 SQL 处理,而不是继续增加连接数。
先确认索引已成功创建、字段顺序符合查询形态、查询没有隐式类型转换,并检查统计信息。对参数分布差异很大的查询,应分别使用代表性参数测试;不要仅因某一次 EXPLAIN 没选索引就强制指定索引。
对美国服务器上的 MySQL 慢查询,索引只是执行路径的一部分。只有在执行计划显示扫描、排序或回表成本确实偏高时,索引优化才是首选;如果数据库执行正常而接口仍慢,应把注意力转向连接池排队、事务锁等待、结果集大小和应用处理。每次变更都应保留基线、限定影响范围并验证回滚条件,这样才能确认性能改善来自正确的瓶颈定位,而不是短时间的偶然波动。


