

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


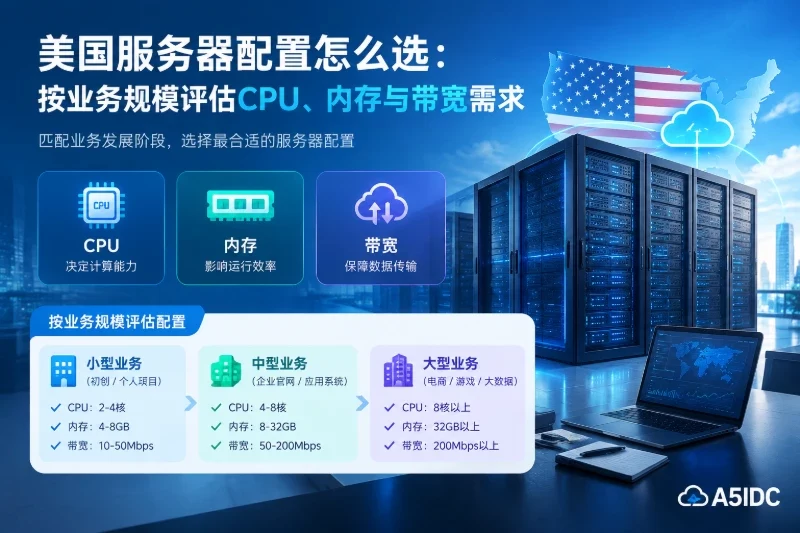
美国服务器配置选错,常见后果并不只是“运行速度慢”:CPU不足会造成请求排队,内存不足会触发交换分区,带宽或网络端口不足则会在流量高峰时出现超时。更稳妥的做法,是先根据访问用户、业务类型和峰值流量确定资源边界,再通过交付验收测试确认实际配置,而不是只看套餐名称或单项参数。
如果业务用户主要位于美国,或需要在美国部署应用、API、网站和数据服务,应重点核对三个问题:CPU是否能承受并发计算,内存是否能容纳应用与缓存,带宽是否覆盖峰值传输量。以下步骤适用于新部署、迁移和扩容前评估,具体性能必须以实际实例、测试节点、测试时间和测试环境为准。
不同业务对CPU、内存和带宽的依赖并不相同,不能只按访问量估算。
| 业务类型 | CPU关注点 | 内存关注点 | 带宽关注点 |
|---|---|---|---|
| 企业官网、展示站 | 动态页面生成、压缩和插件任务 | Web服务、脚本运行和操作系统缓存 | 页面、图片、文件下载的峰值流量 |
| API或后台服务 | 请求处理、序列化、加密和业务计算 | 运行时、连接池、缓存和队列 | 请求与响应大小、并发连接数 |
| 数据库服务 | 查询、排序、索引和事务处理 | 数据库缓存、连接和临时结果集 | 读写请求与复制流量 |
| 文件分发、媒体或下载业务 | 目录和权限处理通常不是主要瓶颈 | 文件缓存与并发连接管理 | 通常是首要约束 |
| 编译、转码、批处理 | 多核并行计算和持续负载 | 临时文件、任务队列和工作集 | 通常低于CPU和磁盘压力,除非需要大量上传下载 |
同一台美国服务器可能同时承载Web、API和数据库。此时不能简单相加后购买“更高配置”,还要判断是否应该拆分角色。数据库和批处理任务争用CPU、内存时,应用层看到的通常是响应时间抖动,而不是平均资源使用率明显超标。
配置应围绕峰值窗口设计。可采用以下基础估算:
带宽粗略换算时,注意服务商通常以Mbps或Gbps表示速率,而业务日志可能以MB、GB统计流量。字节和比特相差八倍,不能直接比较。计算结果还应考虑协议开销、重试、缓存未命中和突发流量。
建议在验收前写下三项业务目标:
1. 正常负载下的接口或页面响应时间范围。
2. 峰值期间允许的错误率、超时率和排队时间。
3. CPU、内存和网络使用率达到什么程度时触发扩容。
这些目标必须与业务实际相关。没有真实负载样本时,任何固定的性能数字都只能作为临时测试阈值,不能视为美国服务器的普遍性能承诺。
以下分级是部署初期的选型框架,不代表任何商家的固定套餐,也不代表在所有应用、系统和网络环境下都能达到相同结果。最终配置应以压测和线上监控为准。
适用对象包括访问量较小的企业站、管理后台、轻量API和开发验证环境。
选择时重点核对:
验收时,分别执行页面访问、后台登录、API调用和文件下载测试,观察CPU是否在请求期间持续满载,内存是否发生交换,以及带宽是否在下载任务期间成为瓶颈。
如果CPU利用率不高但页面仍慢,应优先检查数据库查询、磁盘I/O和应用日志;如果内存持续不足,则应先减少不必要的常驻进程或增加内存,而不是直接增加CPU。
适用对象包括有稳定访问量的官网、订单或会员系统、多个API服务,以及应用和数据库暂时部署在同一台美国服务器上的场景。
选择时应重点关注:
这类业务通常更容易出现资源互相争抢。例如,后台生成报表占用CPU和内存后,前台接口响应变慢;数据库缓存不足时,增加带宽也不会改善查询速度。验收时应分别进行前台请求、数据库查询和后台任务测试,确认各类任务同时运行时仍符合业务目标。
当应用和数据库共用一台服务器时,建议至少设置监控区分两类进程。若数据库内存占用增长导致应用被系统回收,先调整连接数、缓存和查询,再决定是否扩容或拆分服务。
适用对象包括高峰访问明显的API、实时业务、持续编译、转码、批处理和大量动态内容生成。
选择时:
对于这类业务,单台服务器配置再高也可能存在单点故障和扩容限制。若验收时发现某一资源持续接近上限,应先确认应用是否存在低效查询、无界队列、内存泄漏或重复传输,再制定扩容或拆分方案。
交付后先记录美国服务器的实例标识、操作系统版本、CPU可见核心数、内存总量、网卡信息和磁盘挂载情况。不要仅根据控制面板显示判断,系统内也要进行核验。
uname -a
lscpu
free -h
ip -br addr
ip -br link
df -hT
将命令输出保存到交付记录中。若控制面板标称配置与系统识别结果不一致,先停止迁移和压测,要求确认实例规格或重新交付。不要在未确认前通过修改系统配置掩盖问题。
观察CPU核心数、逻辑处理器数量和应用进程的使用情况:
nproc
uptime
top
uptime中的负载值不能脱离CPU核心数单独解释。短时间负载升高可能来自一次批处理,持续升高且请求排队才更值得关注。验收时至少覆盖正常访问和业务峰值两种状态,并记录测试时间、并发数、测试脚本版本和样本数量。
判定分支如下:
使用以下命令查看内存、交换分区和系统压力:
free -h
swapon --show
vmstat 1 5
重点看available、交换分区是否持续增长,以及vmstat中的内存回收和等待情况。少量交换分区并不一定说明故障,但业务高峰期间持续读写交换分区,通常意味着内存余量不足或进程存在异常增长。
判定分支如下:
available仍充足,且没有持续交换:可能是系统缓存,不能仅凭“已用”判断不足。带宽验收必须说明测试节点、时间、协议和样本边界。美国服务器到不同用户网络的结果可能不同,单次测速不能代表所有访问者体验。
推荐记录以下信息:
如果使用iperf3,需要在服务器和独立测试节点上分别运行,并确认测试节点由你控制或获得授权。示例仅用于测试,不应在生产环境直接开放公共端口。
服务器端:
iperf3 -s
测试节点端:
iperf3 -c SERVER_IP -t 30 -P 4
测试完成后立即停止服务端进程,并按实际防火墙策略关闭测试端口。若不能使用iperf3,可通过受控大小的测试文件和应用日志观察传输,但要避免使用未经授权的公共测速服务作为唯一依据。
判定分支如下:
每次验收至少保存四类证据:
1. 配置证据:控制面板截图或实例信息、lscpu、free -h、网卡和磁盘输出。
2. 负载证据:测试脚本、并发数、请求总量、测试开始和结束时间。
3. 结果证据:成功率、错误类型、响应时间分布、CPU、内存、交换和带宽曲线。
4. 环境证据:测试节点、网络类型、应用版本、数据库版本和当时是否存在其他任务。
测试结果建议按“正常负载、预期峰值、短时突发”分别记录。不要只保存平均值,至少同时记录最大值和异常请求比例。若没有完整监控,可先使用系统命令和应用访问日志建立基线,但这类结果的覆盖范围有限,应标注为抽样验收。
一个可执行的验收表可以包含:
| 核对项 | 记录内容 | 通过条件 | 异常处理 |
|---|---|---|---|
| CPU | 核心数、峰值利用率、负载、响应时间 | 峰值期间仍符合业务目标 | 降低后台并发,排查单线程和低效任务 |
| 内存 | 总量、可用量、交换使用、进程增长 | 无持续交换,关键进程稳定 | 检查缓存、连接池和内存泄漏 |
| 带宽 | 测试节点、方向、并发、传输量 | 覆盖业务峰值且无明显丢失 | 更换节点复测,区分端口、应用和节点限制 |
| 应用 | 成功率、错误、超时、日志 | 错误和超时在允许范围内 | 按外部网络、代理、应用、数据库顺序排查 |
| 回滚 | 备份点、版本、恢复步骤 | 能在维护窗口恢复旧版本 | 先演练,再进行正式迁移 |
任何配置调整前,先备份应用配置、数据库和部署清单,明确影响范围和恢复负责人。不要在没有备份的情况下直接修改数据库参数、覆盖应用目录或删除日志。
推荐采用低风险回滚顺序:
1. 停止或暂停新增流量,保留当前错误日志和监控数据。
2. 记录异常发生时间、最近一次变更、CPU、内存、带宽和应用错误。
3. 回滚应用版本、配置文件或后台任务并发设置。
4. 重新执行最小化健康检查。
5. 确认页面、API、数据库连接和关键业务流程恢复后,再逐步放量。
应用发布可先保留旧版本目录,通过软链接切换版本。示例中的路径仅适用于采用该目录结构的部署环境,执行前必须核对实际路径和服务名称:
readlink -f /srv/app/current
ls -ld /srv/app/releases/*
如果已经准备好旧版本目录,可在确认备份和服务管理方式后切回:
ln -sfn /srv/app/releases/OLD_VERSION /srv/app/current
systemctl restart app.service
systemctl status app.service --no-pager
不要直接套用app.service、路径或版本名。若服务名不确定,先执行:
systemctl list-units --type=service --state=running
数据库参数、操作系统内存策略和网络策略的调整影响范围更大,应安排维护窗口,并保留原配置副本。验证失败时,优先恢复原配置,不要连续修改多个变量,否则无法判断哪项变更导致问题。
验收通过后,不代表配置永久适用。至少在业务版本、访问结构或文件分发方式变化时重新评估:
如果当前美国服务器在正常负载下资源充足,但峰值时单项资源突然打满,应优先定位具体瓶颈,而不是同时升级CPU、内存和带宽。CPU瓶颈对应计算和并发策略,内存瓶颈对应工作集与缓存,带宽瓶颈对应传输量、端口限制和测试路径。只有明确瓶颈后,扩容才有可验证的目标。
最终保留一份可复用的配置基线:实例识别结果、业务版本、测试节点、测试时间、峰值样本、通过条件、异常记录和回滚步骤。下次扩容、迁移或更换美国服务器时,用同一套测试方法复核,才能区分真实配置变化与测试环境差异。


