

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


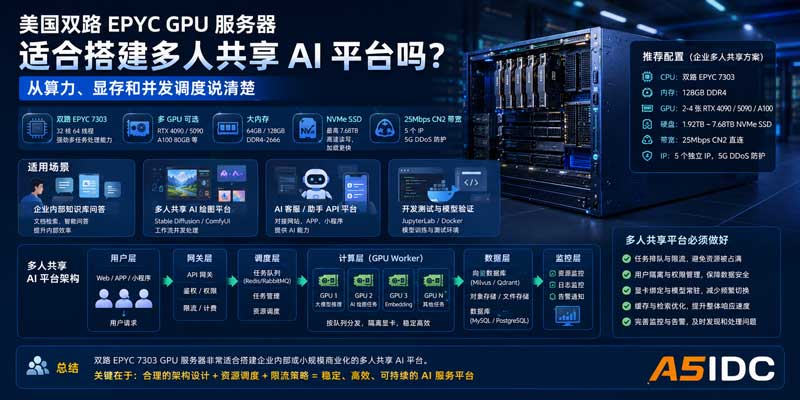
现在很多企业做 AI 服务,已经不是简单买一张显卡跑个模型那么简单了。以前可能只是一个技术人员在服务器上部署 Stable Diffusion、ChatGLM、Qwen、Llama、ComfyUI、Ollama 或 vLLM,自己测试一下推理效果。但真正用到业务里以后,问题很快就变了:客服要用,运营要用,开发要用,老板也要看效果,甚至还想做成一个内部多人共享的 AI 平台。
这时候,服务器就不能只看“有没有 GPU”。多人共享平台更像一个小型 AI 资源池,它要同时考虑 CPU 调度、GPU 显存、内存容量、NVMe 磁盘吞吐、模型加载方式、用户隔离、队列机制、带宽瓶颈和权限控制。双路 EPYC 7303 这种 32 核 64 线程的 GPU 服务器,是否适合做多人共享 AI 平台,关键不在于“能不能跑”,而在于你准备让多少人共享、跑什么模型、是做推理还是训练,以及有没有把资源调度方案设计好。
从配置角度看,双路 AMD EPYC 7303、64GB/128GB DDR4 内存、多张 RTX 4090 / RTX 5090 / A100 可选,再加 NVMe SSD,这类服务器比较适合做以下几类 AI 共享平台:
第一类是企业内部 AI 助手平台,比如内部知识库问答、合同摘要、客服话术生成、运维命令辅助、SEO 内容初稿生成、代码解释、文档总结等。
第二类是多人共享的 AI 绘图或工作流平台,比如 Stable Diffusion WebUI、ComfyUI、Fooocus、FLUX 类模型工作流、批量出图任务等。
第三类是开发测试型 AI 平台,比如给研发、算法、产品团队共用 JupyterLab、Docker 容器、模型测试环境、API 调试环境。
第四类是轻量级 AI SaaS 原型平台,比如先做一个面向内部或小范围客户的 AI 接口服务,验证业务模型,而不是一开始就上大规模分布式集群。
但它不适合直接当成“无限多人同时使用的大型公网 AI 平台”。如果没有限流、队列、用户隔离和模型加载策略,再强的 GPU 服务器也会被几个大任务拖死。尤其是 AI 绘图、视频生成、大模型长上下文推理、多用户并发训练,这些场景很容易把显存、内存、磁盘 IO 和带宽同时打满。
按当前配置页面,这台服务器的核心参数可以这样理解:
| 配置项 | 参数 | 对 AI 多人共享平台的意义 |
|---|---|---|
| CPU | AMD EPYC 2 × 7303,32 核 64 线程 | 适合多容器、多进程、API 网关、任务队列、数据预处理 |
| 内存 | 64GB / 128GB DDR4-2666 | 建议多人平台优先选 128GB,避免模型、缓存、容器同时占用导致内存紧张 |
| GPU | RTX 4090 48GB / RTX 5090 32GB / A100 80GB 可选 | 决定模型大小、并发推理能力、绘图速度和显存余量 |
| GPU 数量 | 支持从单卡到多卡扩展 | 多人共享平台建议至少 2 卡起步,生产环境可按业务扩到 4 卡或 8 卡 |
| 硬盘 | 960GB / 1.92TB / 3.84TB / 7.68TB NVMe SSD | 模型文件、向量库、图片缓存、日志、数据集都很吃磁盘 |
| 带宽 | 25Mbps 直连 CN2 | 适合 API 调用、后台访问、知识库问答,不适合大量模型文件传输或图片视频公网分发 |
| IP | 5 个,含 5G DDoS 防护 | 可做管理面、API 面、测试环境、业务入口分离 |
这组配置的核心优势,不是单纯某一个硬件指标特别夸张,而是 CPU、GPU、NVMe、IP 数量都比较适合做“资源拆分”。多人共享 AI 平台最怕的不是单次任务跑不动,而是多个用户同时发任务时互相抢资源,最后所有人都觉得慢。
很多用户选 GPU 服务器时,第一反应是看显卡型号:4090、5090、A100,哪个显存大,哪个性能强。但我在实际部署 AI 平台时,最怕的是客户只看显卡,不看整体链路。
多人共享平台里,GPU 只是最终执行推理或生成任务的核心,但在 GPU 前后,还有很多资源会被同时消耗。
比如用户上传 PDF、Word、Excel、图片,系统要做解析、切片、OCR、Embedding、向量入库,这些任务会吃 CPU、内存和磁盘 IO。用户发起问答时,系统要从向量库检索上下文,再拼接 Prompt,再交给大模型推理。用户生成图片时,任务队列、图片缓存、模型切换、ControlNet、LoRA 加载都会占用磁盘和显存。
如果只有一张好显卡,但 CPU 核心不够、内存只有 32GB、硬盘还是普通 SATA SSD,多人平台很快就会卡在模型加载、文件处理和任务排队上。
双路 EPYC 7303 的价值就在这里:32 核 64 线程并不是为了让单个模型“推理更快很多”,而是为了支撑多个服务同时运行,比如:
Nginx / Caddy 入口层
API Gateway
用户后台
任务队列 Redis / RabbitMQ
模型推理服务 vLLM / TGI / Ollama / FastAPI
向量数据库 Milvus / Qdrant / Chroma
文件解析服务
图片生成服务
日志监控 Prometheus / Grafana
多个 Docker 容器或虚拟化环境
这些东西一起跑时,CPU 核心数和线程数就很重要。
这是比较适合的场景。
比如公司有产品文档、售后文档、技术手册、合同资料、服务器故障处理记录、客户常见问题,希望员工通过一个内部 AI 系统查询。这个场景对 GPU 的要求不像大规模训练那么夸张,但对稳定性、响应速度、权限管理和知识库更新要求比较高。
推荐方案:
CPU:双路 EPYC 7303
内存:128GB DDR4
GPU:1-2 张 RTX 4090 48GB 或 1 张 A100 80GB
硬盘:1.92TB 或 3.84TB NVMe SSD
模型:Qwen2.5 / Llama / DeepSeek 蒸馏模型 / 企业私有模型
组件:FastAPI + vLLM/Ollama + Qdrant/Milvus + Redis + Nginx
如果只是几十个内部员工使用,重点不是盲目堆 GPU,而是要做好检索、缓存和限流。很多企业知识库问答慢,并不是 GPU 不够,而是文档切片混乱、向量库检索太散、Prompt 拼接太长,导致每次问答都消耗过多 Token。
如果平台主要跑 Stable Diffusion、ComfyUI、FLUX、LoRA、ControlNet、多图批量生成,那么 GPU 显存和 GPU 数量就非常关键。
单张 GPU 可以跑,但多人共享时体验会明显受限。因为图片生成任务不像普通问答,一个任务可能持续几十秒甚至几分钟。如果 5 个用户同时提交高分辨率图片生成任务,没有队列隔离的话,后面的人就只能等待。
建议方案:
入门测试:1 张 RTX 4090 48GB / RTX 5090 32GB
正式多人使用:2-4 张 GPU
高强度工作流:优先考虑 A100 80GB 或多张 4090/5090
硬盘:至少 1.92TB NVMe,素材多建议 3.84TB 起
内存:建议 128GB
部署时不要让所有用户直接抢同一个 WebUI 后台。更合理的方式是:
用户前台
  ↓
任务提交接口
  ↓
Redis / RabbitMQ 队列
  ↓
GPU Worker 1
GPU Worker 2
GPU Worker 3
GPU Worker 4
  ↓
生成结果存储
  ↓
前台展示 / 下载
这样即使多人同时提交任务,也不会把某一张显卡直接打爆。每个 Worker 绑定固定 GPU,任务按队列分发,平台体验会稳定很多。
如果你想把 AI 能力包装成 API,供网站、APP、小程序或内部系统调用,这台服务器也可以做。
但要注意一点:API 平台更怕“瞬时并发”。比如白天没人用,晚上业务高峰突然有几十个用户同时请求,模型服务如果没有批处理和限流,就会出现响应变慢、排队积压、显存占满的问题。
推荐架构:
用户请求
  ↓
API 网关限流
  ↓
鉴权与计费
  ↓
请求队列
  ↓
模型推理服务
  ↓
结果缓存
  ↓
返回用户
如果使用 vLLM 这类推理框架,可以利用连续批处理提升吞吐。但这类优化不是“装好模型就自动完成”,需要根据模型大小、显存容量、最大上下文长度、并发量来调参数。
常见调优方向包括:
控制 max_model_len,避免长上下文拖慢全部请求
限制单用户并发数,避免某个用户占满资源
设置请求超时时间,避免异常任务长期占用 GPU
启用常见问题缓存,重复问题不用每次都推理
按模型大小分组,大模型和小模型不要混跑很多 AI 平台刚开始部署时,会犯一个错误:直接装一个 WebUI,然后给所有人账号登录。这样做短期能用,但不适合长期多人共享。
问题主要有几个。
第一,资源不可控。某个用户一次性提交大图、高分辨率、多 LoRA、多 ControlNet,可能直接占满显存。
第二,任务不可排队。大家同时点生成,后台看似还在运行,但实际体验会变成“谁先抢到资源谁先跑”。
第三,权限不好管理。不同部门、不同客户、不同测试环境混在一起,数据隔离很差。
第四,故障不好排查。某个插件、模型、工作流出问题,可能影响整个平台。
更推荐的方式是把平台拆成三层:
第一层:用户入口层
负责登录、权限、套餐、任务提交、结果展示。

第二层:调度层
负责队列、限流、任务状态、GPU 分配、失败重试。

第三层:计算层
每个 GPU Worker 独立运行,绑定指定显卡和模型环境。
这样服务器虽然还是一台物理机,但使用方式已经接近小型 GPU 资源池。
适合 3-10 人内部测试,主要做 AI 问答、轻量绘图、模型验证。
CPU:双路 EPYC 7303
内存:64GB DDR4
GPU:1 张 RTX 4090 48GB 或 RTX 5090 32GB
硬盘:960GB NVMe SSD
带宽:25Mbps CN2
这个方案可以跑起来,但不建议承载正式多人平台。64GB 内存在多容器、多模型、多任务情况下会比较紧。硬盘 960GB 对 AI 来说也不算宽裕,因为模型、缓存、日志、图片素材很快就会占用大量空间。
适合 10-30 人左右内部共享,做知识库问答、AI 客服测试、内容生成、轻量绘图。
CPU:双路 EPYC 7303
内存:128GB DDR4
GPU:2 张 RTX 4090 48GB / RTX 5090 32GB
硬盘:1.92TB 或 3.84TB NVMe SSD
带宽:25Mbps CN2
这是我更推荐的起步方案。128GB 内存可以给系统、容器、向量库、缓存和模型服务留下余量。2 张 GPU 可以做基础隔离,比如一张跑大模型问答,一张跑图片生成,或者按不同用户组分配。
适合业务已经跑起来,需要更稳定地支撑多个部门、多个客户或多个任务队列。
CPU:双路 EPYC 7303
内存:128GB DDR4
GPU:4 张 GPU 起步,按业务选择 RTX 4090 / RTX 5090 / A100
硬盘:3.84TB 或 7.68TB NVMe SSD
带宽:如有大量图片/文件下载,建议额外配合对象存储或 CDN
这个方案的关键不只是硬件升级,而是必须上调度系统。否则即使堆到 4 张卡、8 张卡,也可能因为任务混乱导致体验不稳定。
如果只是做 API 调用、后台管理、企业内部知识库问答,25Mbps 直连 CN2 是可以用的。AI 问答本身返回的是文本,带宽压力并不大。真正消耗带宽的是以下几类场景:
用户频繁上传大文件
用户下载大量生成图片
多人同时下载模型输出包
平台对外提供图片/视频生成服务
远程拉取大模型文件
远程同步数据集
所以这类服务器更适合把 GPU 计算放在本机,把大文件分发交给对象存储、CDN 或独立下载节点。不要把 AI 平台、模型下载、图片分发、视频预览全部压在同一条 25Mbps 带宽上。
比较合理的做法是:
AI 推理:放在 GPU 服务器
模型文件:提前离线下载到本地 NVMe
图片结果:生成后同步到对象存储或独立存储节点
公网访问:使用 CDN 或前端加速
管理后台:走 CN2 线路保持低延迟访问
这样可以避免“GPU 还没跑满,带宽先堵住”的问题。
如果要把它做成多人共享平台,我建议一开始就采用容器化部署,而不是所有东西直接装在宿主机里。
推荐基础结构:
Ubuntu Server 22.04 LTS
NVIDIA Driver
CUDA / Container Toolkit
Docker
Docker Compose 或 Kubernetes 单机版
Nginx / Caddy
Redis
PostgreSQL / MySQL
Qdrant / Milvus
FastAPI / Node.js 后端
vLLM / Ollama / TGI
Prometheus + Grafana
目录可以这样规划:
/data/models        模型文件
/data/datasets      数据集
/data/vector        向量库数据
/data/uploads       用户上传文件
/data/outputs       生成结果
/data/logs          运行日志
/data/backups       备份数据
显卡分配可以这样做:
GPU 0:大模型问答服务
GPU 1:Embedding / 小模型 / API 服务
GPU 2:ComfyUI / 绘图任务
GPU 3:备用或高优先级任务
如果是多卡环境,不建议所有服务都默认可见所有 GPU。应该通过 CUDA_VISIBLE_DEVICES 或容器运行参数限制每个服务能使用哪张卡。
例如:
docker run --gpus '"device=0"' your-llm-service
docker run --gpus '"device=1"' your-embedding-service
docker run --gpus '"device=2"' your-comfyui-worker
这样可以减少互相抢显存的问题。
不要让一个用户同时提交几十个任务。每个用户可以设置:
普通用户:同时 1-2 个任务
高级用户:同时 3-5 个任务
管理员:不限制或单独队列大模型问答里,上下文越长,显存和计算消耗越高。不是所有问题都应该开放 32K、64K 长上下文。
建议:
普通问答:4K-8K
知识库问答:8K-16K
高权限用户:按需开放更长上下文AI 绘图平台不建议实时抢占 GPU。应该统一进入队列,由 Worker 按顺序处理。
频繁加载不同模型会严重拖慢平台体验。可以把模型分为:
常驻模型:高频使用,长期加载
低频模型:按需加载,进入低优先级队列
测试模型:只给管理员或研发使用知识库平台最容易被大文件拖慢。建议限制:
单文件大小
单用户总容量
单知识库文档数量
单次解析页数
OCR 任务并发数至少要监控这些指标:
GPU 使用率
GPU 显存占用
CPU 使用率
内存占用
NVMe 磁盘读写
任务队列长度
接口响应时间
失败任务数量
单用户资源消耗
没有监控的 AI 平台,后期很难判断到底是显卡不够、内存不够,还是任务调度设计有问题。
它不太适合直接做大规模公网 AI 平台,比如完全开放注册、几十上百人同时在线、每个人都可以跑大模型长文本、绘图、视频生成。除非你在前面加上严格的套餐限制、队列系统、计费系统和多机扩展能力。
它也不适合把大模型训练作为主要用途。双路 EPYC 7303 + 多 GPU 可以做微调、LoRA、测试训练、小规模实验,但如果目标是持续训练大模型,应该考虑更专业的多 GPU 高速互联、分布式存储、训练框架和更大的集群方案。
另外,如果你的 AI 平台主要面向海外大流量用户访问,或者大量图片、视频、文件下载,25Mbps 带宽就不应该承担全部公网分发。GPU 服务器负责计算,文件分发交给对象存储、CDN 或独立大带宽服务器,会更合理。
如果要把这台双路 EPYC 7303 GPU 服务器用好,我更建议把它定位成 AI 计算节点,而不是把所有业务都堆在上面。
比较稳的生产结构是:
前端站点 / 用户后台
  ↓
API 网关 / 鉴权 / 限流
  ↓
任务队列
  ↓
GPU 计算节点
  ↓
对象存储 / 图片存储 / 知识库数据
  ↓
监控与日志系统
如果早期预算有限,也可以先单机部署,但架构上要预留拆分空间。比如数据库、对象存储、前端站点、用户系统,后期都可以慢慢迁移出去。GPU 服务器只专心做最值钱的部分:模型推理、图片生成、Embedding、向量检索和 AI 计算任务。
双路 EPYC 7303、32 核 64 线程、多 GPU 可选、NVMe SSD 这些配置,确实适合搭建企业内部或小规模商业化的多人共享 AI 平台。它的优势在于 CPU 线程足够支撑多服务运行,GPU 可按业务扩展,NVMe 适合承载模型和缓存,整体更适合做一个可控的 AI 资源池。
但真正决定体验的,不只是硬件配置,而是平台设计方式。多人共享 AI 平台一定要做好队列、限流、权限、显卡绑定、模型常驻、缓存、监控和数据隔离。否则服务器配置再高,也可能因为几个用户同时提交大任务而变得卡顿。
所以这类服务器最适合的使用方式是:先从企业内部 AI 助手、知识库问答、多人绘图、模型测试平台做起;等业务量稳定以后,再按 GPU 数量、带宽、存储和节点数量逐步扩展。这样既不会一开始投入过重,也能避免把一台高性能 GPU 服务器用成一个“谁都能抢、谁都跑不快”的混乱平台。


