

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


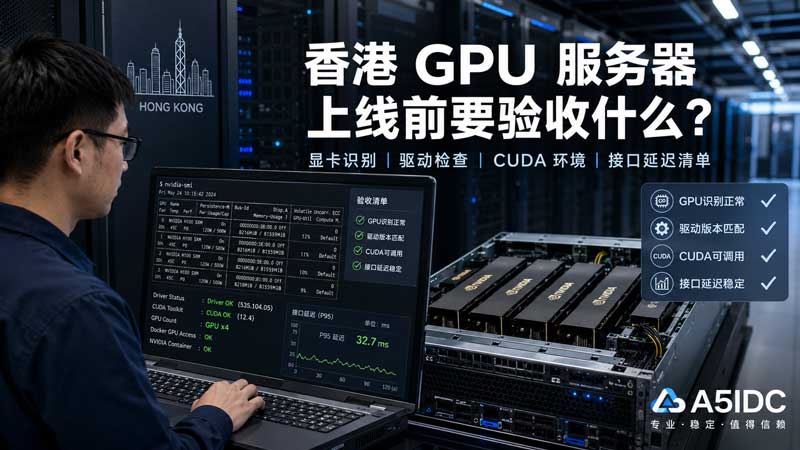
很多用户租用香港GPU服务器时,最容易犯的一个错误是:服务器能登录,nvidia-smi 能显示显卡,就认为可以上线了。
但在真实项目里,GPU 服务器上线前要验收的不只是“显卡有没有识别”。还要看驱动版本和 CUDA 是否匹配、容器能不能调用 GPU、显卡是否跑在正确的 PCIe 模式、显存是否异常占用、业务接口延迟是否稳定、香港到大陆访问是否抖动,以及模型推理在高并发下会不会突然变慢。
尤其是做 AI 推理、AIGC 应用、图像识别、视频转码、语音识别、跨境业务后台时,GPU 服务器上线前如果没有验收好,后面出现问题往往不是简单的“服务器卡”,而是驱动、CUDA、框架、接口、线路、磁盘 IO、显存调度一起混在一起,排查成本很高。
我之前遇到过一种很典型的情况:客户租了一台香港 GPU 服务器,用来部署 AI 图像识别接口。服务器交付后,SSH 能登录,nvidia-smi 也能看到显卡,客户觉得没问题,就直接把业务切过去了。
刚开始访问量不大,一切正常。后来接口并发上来以后,问题开始出现:
最后排查下来,服务器硬件本身没坏,问题出在上线前没有做完整验收。
所以香港 GPU 服务器上线前,建议至少验收这 8 类内容:
| 验收方向 | 主要检查内容 | 不验收可能出现的问题 |
|---|---|---|
| 显卡识别 | GPU 型号、数量、显存、温度、功耗 | 少卡、错卡、显存异常 |
| 驱动环境 | NVIDIA Driver、CUDA、cuDNN | 框架无法调用 GPU |
| 容器环境 | Docker、NVIDIA Container Toolkit | 容器内识别不到显卡 |
| PCIe / 拓扑 | PCIe 速率、NUMA、NVLink、卡间通信 | 多卡性能上不去 |
| 系统资源 | CPU、内存、NVMe、Swap、IO | 推理卡顿、加载模型慢 |
| 网络线路 | BGP、CN2、回国带宽、国际带宽 | 国内访问延迟波动 |
| 接口延迟 | API 首包、总耗时、P95/P99 | 上线后接口不稳定 |
| 压测稳定性 | 并发、显存、温度、功耗、日志 | 高峰期崩溃或降速 |
GPU 服务器不是只看显卡型号。显卡、CPU、内存、硬盘、线路、系统环境都会影响最终效果。
下面是几类常见香港 GPU 服务器配置,可以作为上线验收时的参考。
适合业务:
参考配置:
| 项目 | 推荐配置 |
|---|---|
| CPU | AMD EPYC 4585PX / Intel Xeon Gold 系列 |
| 核心 | 16 核 32 线程或以上 |
| 内存 | 128GB DDR4 / DDR5 |
| 硬盘 | 960GB / 1.92TB NVMe SSD |
| GPU | RTX 4090 / RTX 5090 / A 系列专业卡 |
| 带宽 | 100M BGP + 25M CN2 直连,或按业务升级 |
| 系统 | Ubuntu 22.04 LTS 更常见 |
| 适合场景 | 单模型推理、图像处理、AI API 接口 |
这类服务器上线前最重要的不是多卡通信,而是:
适合业务:
参考配置:
| 项目 | 推荐配置 |
|---|---|
| CPU | AMD EPYC 9554 / EPYC 9754 |
| 核心 | 64 核以上,视模型数量调整 |
| 内存 | 256GB / 512GB DDR5 |
| 硬盘 | 2 × 1.92TB NVMe 或更高 |
| GPU | A100 80GB / 多张 RTX 系列 / 多张专业卡 |
| 带宽 | 1G 三网直连回国或 3G 国际带宽 |
| 内网 | 建议 10G 内网,方便模型、数据、日志分离 |
| 适合场景 | 多模型推理、企业 AI 平台、视频 AI 分析 |
这类配置上线前重点要看:
适合业务:
参考配置:
| 项目 | 推荐配置 |
|---|---|
| CPU | AMD EPYC 9754 / 双路高核心平台 |
| 内存 | 512GB / 1TB |
| 硬盘 | 多块 NVMe SSD,可做 RAID 或数据盘分离 |
| GPU | 4 × GPU / 8 × GPU,按业务定制 |
| 网络 | 10G 内网 + 独享回国 / 国际带宽 |
| 系统 | Ubuntu 22.04 + Docker + NVIDIA Runtime |
| 适合场景 | 多租户 GPU 任务、训练、批量推理、视频处理 |
这类服务器上线前如果只看 nvidia-smi,远远不够。一定要检查:
GPU 服务器交付后,第一件事就是检查显卡识别情况。
常用命令:
nvidia-smi重点看这几项:
GPU Name
Driver Version
CUDA Version
Memory-Usage
Temperature
Power Usage
GPU-Util
正常情况下,你应该确认:
| 检查项 | 正常结果 |
|---|---|
| GPU 数量 | 和购买配置一致 |
| GPU 型号 | 和合同 / 产品配置一致 |
| 显存容量 | 和显卡规格一致 |
| 驱动版本 | 能正常显示,不报错 |
| CUDA Version | 能显示 CUDA 兼容版本 |
| 温度 | 空载一般不应异常偏高 |
| GPU-Util | 空载时通常接近 0% |
| 显存占用 | 空载不应被异常进程占满 |
如果是多卡服务器,可以用:
nvidia-smi -L示例输出:
GPU 0: NVIDIA A100 80GB PCIe
GPU 1: NVIDIA A100 80GB PCIe
GPU 2: NVIDIA A100 80GB PCIe
GPU 3: NVIDIA A100 80GB PCIe
如果你购买的是 4 卡服务器,但这里只显示 3 张卡,那就不能上线。这个问题可能来自硬件连接、BIOS 设置、驱动加载、PCIe 插槽识别,也可能是系统没有正确加载显卡。
很多 GPU 服务器问题,不是显卡坏了,而是驱动、CUDA、PyTorch、TensorFlow 版本不匹配。
nvidia-smi也可以查看内核模块:
lsmod | grep nvidia如果没有输出,说明 NVIDIA 驱动模块可能没有正常加载。
nvcc -V如果提示:
command not found不一定代表 CUDA 不能用,因为有些服务器只安装了运行环境,没有安装完整 CUDA Toolkit。但如果你的业务需要编译 CUDA 扩展,比如某些推理加速库、算子编译、深度学习框架源码编译,就需要完整 CUDA Toolkit。
ls -l /usr/local/cuda正常情况下可能指向类似:
/usr/local/cuda -> /usr/local/cuda-12.x如果你使用 PyTorch:
python3 - <<'EOF'
import torch
print("CUDA available:", torch.cuda.is_available())
print("GPU count:", torch.cuda.device_count())
if torch.cuda.is_available():
    print("GPU name:", torch.cuda.get_device_name(0))
EOF
如果输出:
CUDA available: True
GPU count: 1
GPU name: NVIDIA ...
说明 PyTorch 可以调用 GPU。
如果你使用 TensorFlow:
python3 - <<'EOF'
import tensorflow as tf
print(tf.config.list_physical_devices('GPU'))
EOF
上线标准不是“系统能看到显卡”,而是你的业务框架能真正调用 GPU。
现在很多 AI 项目都是用 Docker 部署,比如:
这时必须检查容器内是否能识别 GPU。
docker versiondocker info | grep -i nvidiadocker run --rm --gpus all nvidia/cuda:12.2.0-base-ubuntu22.04 nvidia-smi如果容器里也能正常显示显卡,说明 Docker 调用 GPU 基本正常。
如果宿主机 nvidia-smi 正常,但 Docker 内部报错,常见原因是:
| 问题 | 可能原因 |
|---|---|
| Docker 内看不到 GPU | 未安装 NVIDIA Container Toolkit |
--gpus all 报错 |
Docker 版本或 runtime 配置异常 |
| 容器启动后找不到 CUDA 库 | 镜像 CUDA 版本和驱动不兼容 |
| PyTorch 显示 CPU | 安装了 CPU 版本 PyTorch |
| 多卡只识别一张 | 容器启动参数限制了 GPU |
容器部署时建议明确指定 GPU:
docker run -d \
  --gpus '"device=0"' \
  --name ai-api \
  -p 8000:8000 \
  your-ai-image:latest
多卡服务器不要一上来就 --gpus all 全部开放给一个容器。更稳的做法是按业务拆分:
--gpus '"device=0"'
--gpus '"device=1"'
--gpus '"device=2,3"'
这样后期排查显存占用、接口延迟、任务隔离会更清楚。
单卡服务器可以少看一点,但多卡 GPU 服务器一定要看拓扑。
命令:
nvidia-smi topo -m你会看到类似:
        GPU0    GPU1    CPU Affinity
GPU0     X      PIX     0-31
GPU1    PIX      X      0-31
这里主要看:
| 标识 | 含义 | 影响 |
|---|---|---|
| PIX | 同一个 PCIe Switch 下 | 通信较好 |
| PXB | 跨多个 PCIe Bridge | 通信略复杂 |
| PHB | 经过 Host Bridge | 延迟更高 |
| SYS | 跨 CPU / NUMA 节点 | 多卡通信成本更高 |
| NVLink | 有 NVLink 互联 | 多卡训练更有优势 |
对于 AI 推理业务,不一定必须追求 NVLink。但如果你做多卡训练、大模型切分、分布式推理,就要非常关注 GPU 之间的拓扑关系。
还可以检查 PCIe 速率:
nvidia-smi -q | grep -A 20 "PCI"重点看是否出现 PCIe 降级。例如本来应该跑在较高带宽模式,但实际只有低速链路,这会影响模型加载、数据传输和多卡通信。
GPU 服务器上线前,显存状态一定要干净。
命令:
nvidia-smi看底部 Processes 区域:
Processes:
GPU   PID   Type   Process name   GPU Memory
如果服务器刚交付,显存已经被未知进程占用,就要确认是不是:
可以用:
ps -fp <PID>查看进程来源。
如果是自己的进程,可以重启服务。如果是异常进程,不要直接粗暴 kill,先确认是否属于业务服务。
常见处理方式:
docker ps
docker stop <container_id>
或者:
kill -9 <PID>但正式环境不建议随便 kill -9,因为可能导致任务中断、日志损坏、临时文件残留。
很多人以为 GPU 服务器慢,就是显卡不够强。其实在真实业务里,经常是 GPU 在等 CPU、内存或磁盘。
lscpu关注:
如果你跑的是图片预处理、视频解码、批量数据清洗,CPU 太弱会导致 GPU 利用率上不去。
典型表现是:
GPU-Util 只有 20% - 40%
CPU 占用接近 100%
接口响应越来越慢
这时不是显卡不行,而是 CPU 喂不饱 GPU。
free -h上线前建议确认:
如果看到 Swap 大量使用,接口延迟通常会明显变差。
lsblk
df -h
测试磁盘读取:
fio --name=readtest --filename=/tmp/testfile \
--size=5G --rw=read --bs=1M --iodepth=16 --numjobs=1 --direct=1
AI 业务里,NVMe 的价值不只是“存模型”,还会影响:
如果是 A100 80GB 这类高端 GPU,但硬盘还是普通 SATA SSD,很多场景下会出现“GPU 很贵,但等数据等得很浪费”的情况。
香港 GPU 服务器经常用于面向大陆用户、东南亚用户或海外业务。上线前必须验收网络线路。
常见线路组合包括:
| 线路类型 | 适合业务 |
|---|---|
| 100M BGP + 25M CN2 直连 | 国内访问质量优先的 AI 接口、小模型服务 |
| 1G 三网直连回国 | 访问量较大、接口调用频繁、下载量较高 |
| 3G 国际带宽 | 面向海外用户、跨境业务、国际访问为主 |
| 10G 内网 | 多台服务器之间传模型、传数据、集群调度 |
ping -c 20 your-domain.com但 Ping 只能说明 ICMP 层面的延迟,不等于真实 API 延迟。
从用户所在地到服务器:
mtr -rw <server_ip>从服务器到用户方向:
mtr -rw <client_ip>GPU 服务器上线前,尤其要看双向路由。
有些问题是“用户访问服务器慢”,有些问题是“服务器回包方向绕路”。如果只测单向,很容易误判。
从大陆节点下载服务器文件:
wget http://your-server/test.bin从服务器拉取外部资源:
wget https://example.com/model.binAI 业务还要特别关注模型下载速度。很多模型文件几十 GB,如果服务器国际出口质量不好,部署阶段会非常痛苦。
对于 AI 推理类业务,最终用户关心的不是 nvidia-smi,而是接口多久返回。
建议上线前至少测 4 个指标:
| 指标 | 含义 |
|---|---|
| 首次请求耗时 | 模型是否需要冷启动 |
| 平均耗时 | 正常接口速度 |
| P95 延迟 | 95% 请求能否稳定 |
| P99 延迟 | 高峰极端延迟是否可接受 |
curl -o /dev/null -s -w \
"DNS:%{time_namelookup} Connect:%{time_connect} TTFB:%{time_starttransfer} Total:%{time_total}\n" \
https://api.yourdomain.com/predict
重点看:
| 字段 | 说明 |
|---|---|
| DNS | 域名解析耗时 |
| Connect | TCP 连接耗时 |
| TTFB | 服务端开始响应时间 |
| Total | 整个请求完成时间 |
如果 Connect 很高,可能是网络线路问题。
如果 TTFB 很高,通常是后端服务、模型推理、队列、数据库、磁盘或 GPU 调度问题。
如果 Total 很高,可能是响应体太大、带宽不足、接口返回文件较大。
wrk -t4 -c50 -d60s https://api.yourdomain.com/predict参数解释:
| 参数 | 含义 |
|---|---|
-t4 |
4 个线程 |
-c50 |
50 个并发连接 |
-d60s |
持续 60 秒 |
重点看:
压测时同时开一个窗口观察 GPU:
watch -n 1 nvidia-smi如果并发一上来,GPU 利用率不高,但接口延迟变高,通常说明瓶颈不在 GPU,而在:
下面这张表可以直接作为交付验收表使用。
| 验收项 | 命令 / 方法 | 合格标准 |
|---|---|---|
| GPU 数量 | nvidia-smi -L |
与购买配置一致 |
| GPU 型号 | nvidia-smi |
与产品配置一致 |
| 显存容量 | nvidia-smi |
与显卡规格一致 |
| GPU 温度 | nvidia-smi |
空载温度正常,无异常高温 |
| GPU 功耗 | nvidia-smi |
空载和压测下无异常波动 |
| CPU 型号 | lscpu |
与配置一致 |
| 内存容量 | free -h |
与配置一致 |
| 硬盘容量 | lsblk / df -h |
与配置一致 |
| NVMe 状态 | smartctl -a /dev/nvme0n1 |
无明显错误计数 |
| 验收项 | 命令 / 方法 | 合格标准 |
|---|---|---|
| NVIDIA 驱动 | nvidia-smi |
正常显示 Driver Version |
| CUDA 兼容 | nvidia-smi |
显示 CUDA Version |
| CUDA Toolkit | nvcc -V |
需要编译时必须可用 |
| PyTorch GPU | torch.cuda.is_available() |
返回 True |
| TensorFlow GPU | tf.config.list_physical_devices('GPU') |
能识别 GPU |
| CUDA 动态库 | `ldconfig -p | grep cuda` |
| 多卡识别 | nvidia-smi -L |
所有 GPU 可见 |
| 验收项 | 命令 / 方法 | 合格标准 |
|---|---|---|
| Docker 状态 | docker version |
正常运行 |
| GPU Runtime | `docker info | grep -i nvidia` |
| 容器识别 GPU | docker run --gpus all ... nvidia-smi |
容器内可显示 GPU |
| 单卡隔离 | --gpus '"device=0"' |
指定 GPU 正常 |
| 多卡调用 | --gpus all |
多卡可被容器识别 |
| 容器显存释放 | 停止容器后看 nvidia-smi |
显存释放正常 |
| 验收项 | 方法 | 合格标准 |
|---|---|---|
| 国内 Ping | 多地区测试 | 延迟稳定,无明显丢包 |
| 双向 MTR | 客户端和服务器互测 | 路由无明显绕路或高丢包 |
| API Connect 时间 | curl -w |
连接耗时稳定 |
| API TTFB | curl -w |
服务端响应时间稳定 |
| API Total | curl -w |
总耗时符合业务要求 |
| P95 延迟 | wrk / ab / 自研压测 |
高峰下可接受 |
| P99 延迟 | 压测统计 | 不出现严重长尾 |
| 带宽占用 | iftop / 面板监控 |
不长期打满 |
nvidia-smi 正常,但程序还是用 CPU 跑常见原因:
cuda;排查命令:
python3 - <<'EOF'
import torch
print(torch.__version__)
print(torch.version.cuda)
print(torch.cuda.is_available())
EOF
如果 torch.cuda.is_available() 是 False,就不要继续优化业务代码,先修环境。
解决方向:
CUDA_VISIBLE_DEVICES;--gpus 参数;常见原因:
观察 GPU:
watch -n 1 nvidia-smi如果 GPU-Util 长期很低,说明 GPU 没吃满。
解决方向:
这种情况最容易误判。不要只看 CPU 和 GPU,要拆分接口时间。
用:
curl -o /dev/null -s -w \
"Connect:%{time_connect} TTFB:%{time_starttransfer} Total:%{time_total}\n" \
https://api.yourdomain.com/predict
判断方法:
| 现象 | 可能原因 |
|---|---|
| Connect 高 | 网络线路、DNS、TCP 建连慢 |
| TTFB 高 | 后端排队、模型推理慢、数据库慢 |
| Total 高 | 返回体大、带宽不足、下载慢 |
| 偶发超时 | worker 被占满、队列阻塞、显存不足 |
| 晚高峰变慢 | 线路拥塞或回国方向波动 |
解决方向:
常见原因:
CUDA_VISIBLE_DEVICES 限制了 GPU;检查环境变量:
echo $CUDA_VISIBLE_DEVICES检查容器参数:
docker inspect <container_id> | grep -i gpu解决方向:
常见原因:
查看占用进程:
nvidia-smi
ps -fp <PID>
PyTorch 中可以尝试:
import torch
torch.cuda.empty_cache()但要注意,empty_cache() 不是万能的。如果进程还在,显存可能不会真正释放。
生产环境建议:
GPU 服务器上线前,不建议只跑一个 demo。至少要模拟真实业务。
测试模型是否能正常返回。
curl https://api.yourdomain.com/predict看显存是否上涨、是否内存泄漏。
for i in {1..100}; do
  curl -s https://api.yourdomain.com/predict > /dev/null
donewrk -t4 -c30 -d120s https://api.yourdomain.com/predict建议至少观察:
观察内容:
nvidia-smi dmon或者:
watch -n 1 nvidia-smi重点看:
| 指标 | 正常表现 |
|---|---|
| GPU-Util | 有规律波动,不长期为 0 |
| 显存 | 稳定,不持续上涨 |
| 温度 | 不异常升高 |
| 功耗 | 不频繁异常波动 |
| 接口延迟 | P95 / P99 可控 |
| 错误率 | 不出现大量 5xx |
| 系统日志 | 无驱动报错、OOM、重启 |
不同业务的验收重点不一样,不建议所有用户都照一个标准。
重点验收:
推荐配置方向:
重点验收:
推荐配置方向:
重点验收:
推荐配置方向:
重点验收:
推荐配置方向:
香港 GPU 服务器上线前,建议把下面这些信息记录下来,作为交付和后续排障依据。
服务器 IP:
系统版本:
CPU 型号:
内存容量:
硬盘容量:
GPU 型号:
GPU 数量:
显存容量:
NVIDIA Driver:
CUDA Version:
Docker Version:
PyTorch / TensorFlow Version:
线路类型:
Ping 测试结果:
MTR 测试结果:
API 平均延迟:
API P95 延迟:
API P99 延迟:
压测并发数:
压测持续时间:
上线前异常项:
处理结果:
这样做的好处是,后面如果客户反馈“接口变慢了”“显卡利用率低了”“国内访问不稳定了”,可以直接和上线前数据对比,而不是从头猜。
香港 GPU 服务器上线前,最怕的不是发现问题,而是没发现问题就直接上线。
真正可靠的验收,不是只看服务器能不能登录,也不是只看 nvidia-smi 有没有显卡,而是要把硬件、驱动、CUDA、Docker、框架、网络、接口延迟、并发压测全部串起来看。
如果是普通网站服务器,上线前重点可能是 CPU、内存、磁盘、带宽。但 GPU 服务器多了一层复杂性:显卡本身能识别,不代表业务能稳定调用;CUDA 能安装,不代表框架版本一定匹配;单次接口正常,不代表高并发下不会排队;Ping 延迟低,也不代表 API 的 TTFB 一定稳定。
所以我的建议很简单:
租用香港 GPU 服务器后,不要急着上线。先按清单验收一遍。显卡识别、驱动、CUDA、容器、模型、接口、线路、压测全部过一遍,后面业务真正跑起来时,稳定性会高很多,排障成本也会低很多。


