

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


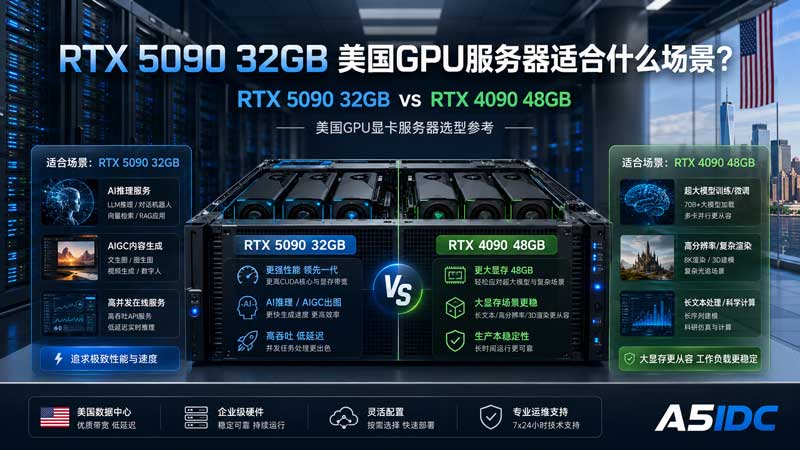
很多用户看到 RTX 5090 32GB,第一反应是:新一代显卡,肯定比 RTX 4090 更好。这个判断不能说错,但放到服务器租用和 AI 部署里,就不能只看“新不新”。
更准确地说:
RTX 5090 32GB 更适合“模型能放进显存,但想要更高推理速度、更强单卡性能”的场景。
RTX 4090 48GB 更适合“显存容量更紧张,模型、上下文、分辨率、批量任务更容易爆显存”的场景。
NVIDIA 官方 RTX 5090 是 Blackwell 架构,配备 32GB GDDR7 显存;第三方显卡规格中,RTX 5090 常见参数包括 21760 个 CUDA 核心、512-bit 显存位宽、约 1792GB/s 显存带宽和 600W TDP。
而 NVIDIA 官方 RTX 4090 标准规格是 24GB GDDR6X、16384 个 CUDA 核心,并不是 48GB;市场上的 RTX 4090 48GB 多数属于面向 AI/服务器场景的扩容定制版本,需要特别关注供货来源、散热、固件和长期稳定性。
所以,这两张卡的核心区别不是一句“5090 比 4090 强”就能概括,而是要看你的任务到底卡在 算力、显存容量、显存带宽、还是服务器整体架构 上。
A5IDC 美国 GPU 服务器产品线支持 A100 80GB / RTX 4090 48GB / RTX 5090 32GB 显卡方案,可搭配 1G 三网直连回国 或 3G 国际带宽,适合 AI 训练、大模型推理、视频渲染和海外 AI 应用部署。
| 配置型号 | CPU | 内存 | 硬盘 | 显卡方向 | 带宽 | 适合业务 |
|---|---|---|---|---|---|---|
| 美国GPU-01 | AMD EPYC 7402P,24核48线程 | 64GB DDR4 | 960GB NVMe PCIe Gen4 SSD | RTX 5090 32GB / RTX 4090 48GB / A100 80GB | 1G三网直连回国 / 3G国际带宽 | 单卡推理、AIGC图片生成、轻量训练、API服务 |
| 美国GPU-02 | 双路 AMD EPYC 7303,32核64线程 | 64GB DDR4 | 960GB NVMe PCIe Gen4 SSD | RTX 5090 32GB / RTX 4090 48GB / A100 80GB | 1G三网直连回国 / 3G国际带宽 | 多任务推理、批量生成、视频处理、企业AI服务 |
| 美国GPU-03 | 双路 Intel Xeon Gold 6330,56核112线程 | 64GB DDR4 | 960GB NVMe PCIe Gen4 SSD | RTX 5090 32GB / RTX 4090 48GB / A100 80GB | 1G三网直连回国 / 3G国际带宽 | 多进程推理、渲染集群、训练辅助、复杂后端服务 |
实际选型时,不能只盯着显卡。GPU 负责计算,CPU 负责调度、数据预处理、接口服务、解码和任务分发;NVMe 决定模型加载、素材读写和数据集处理效率;带宽则决定 API 访问、素材上传下载和跨境用户体验。
RTX 5090 32GB 的优势在于新架构、高显存带宽和更强的单卡吞吐能力。它非常适合部署:
比如一个面向海外用户的 AI 客服系统,如果使用 Qwen、Llama、Mistral 等中小规模模型,并且经过 INT4 / INT8 量化,32GB 显存往往可以支撑比较稳定的推理部署。此时,RTX 5090 的价值主要体现在 更快的 token 输出、更高的响应效率和更好的单卡性能密度。
但如果你要跑的是更大的模型、更长上下文、更高 batch size,32GB 显存就可能变成限制。
RTX 5090 32GB 很适合图片生成类业务,比如:
这类业务有一个特点:很多时候并不是模型特别大,而是任务数量多、生成频率高、用户希望等待时间短。
如果只是普通文生图、图生图、局部重绘、批量生成,RTX 5090 32GB 往往比 RTX 4090 48GB 更适合做“高效率生产卡”。因为它的显存容量虽然小于 48GB,但单卡性能和显存带宽更强,更适合追求生成速度的业务。
但如果你经常跑超大分辨率、多 ControlNet、多 LoRA、多模型串联工作流,RTX 4090 48GB 的大显存会更稳。
美国 GPU 显卡服务器还常用于视频类场景,例如:
这类任务不仅吃 GPU,也吃 CPU、硬盘和带宽。
如果是短视频团队,用户在国内办公,素材需要上传到美国服务器处理,再下载结果,那么建议选择 1G 三网直连回国带宽,减少跨境传输等待时间。
如果业务主要面向海外用户,例如美国、欧洲用户访问你的 AI 视频生成平台,则可以选择 3G 国际带宽,更适合海外访问和大文件分发。
很多企业租用美国 GPU 服务器,不是为了自己测试,而是为了把 AI 能力做成产品,例如:
这种场景下,RTX 5090 32GB 的优势是“单位时间处理能力强”。如果模型显存占用没有超过 32GB,它往往比 RTX 4090 48GB 更适合做高频调用型业务。
简单说:
模型放得下,追求速度,优先 RTX 5090 32GB。
模型放不下,频繁爆显存,优先 RTX 4090 48GB 或 A100 80GB。
GPU 服务器选型时,显存不是越大越好,但显存不够一定不行。
| 对比项 | RTX 5090 32GB | RTX 4090 48GB |
|---|---|---|
| 显存容量 | 32GB | 48GB |
| 核心优势 | 新架构、高吞吐、高带宽 | 大显存、更抗爆显存 |
| 更适合 | 中小模型高速推理、AIGC、渲染 | 大模型、长上下文、大图、多工作流 |
| 选型关键词 | 速度、效率、单卡性能 | 容量、稳定放模型、减少 offload |
| 风险点 | 显存容量上限较明显 | 需关注定制卡来源和稳定性 |
举个简单例子:
如果你的模型加载后占用 20GB 显存,RTX 5090 32GB 还有余量,可以跑得很舒服。
如果你的模型加载后占用 38GB 显存,RTX 5090 32GB 就不够了,即使它算力更强,也会因为显存不足被迫 CPU offload、降低 batch size,甚至直接 OOM。这个时候 RTX 4090 48GB 更合适。
RTX 5090 32GB 更像“高速推理卡”。
它适合:
RTX 4090 48GB 更像“大显存实用卡”。
它适合:
很多用户的问题不是“5090 和 4090 谁更强”,而是“我的任务到底需要更快的计算,还是需要更多显存”。
大模型部署时,最怕一种情况:模型勉强能跑,但部分权重被迫放到 CPU 内存里,也就是常说的 offload。
offload 之后,表面上模型启动了,但实际体验会明显下降:
所以,如果你的模型在 RTX 5090 32GB 上需要大量 offload,那就不应该硬上 5090。此时 RTX 4090 48GB 或 A100 80GB 才更合适。
RTX 5090 这类消费级高端显卡在服务器里可以做多卡部署,但不能简单等同于 A100 / H100 这类数据中心 GPU。以部分 RTX 5090 规格为例,其 NVLink 标注为不支持。
这意味着多卡部署时要特别注意:
如果你的业务只是多个独立任务并行,例如多个 ComfyUI 实例、多个推理 API 实例、多用户图片生成,多卡消费级 GPU 依然很实用。
但如果你要跑一个特别大的模型,并且依赖高效跨卡通信,就要认真评估 A100 80GB 这类数据中心卡。
推荐:RTX 5090 32GB
适合配置:
如果用户主要在海外,优先 3G 国际带宽。
如果用户主要在国内访问美国 AI 服务,优先 1G 三网直连回国。
解决方案建议:
推荐:RTX 5090 32GB 或 RTX 4090 48GB
如果主要是普通图片生成、批量出图、商品图、广告图、头像生成,优先 RTX 5090 32GB。
如果经常使用复杂工作流,比如高分辨率、多 ControlNet、多 LoRA、多模型节点串联,优先 RTX 4090 48GB。
适合配置:
解决方案建议:
推荐:RTX 5090 32GB 起步,复杂任务选 RTX 4090 48GB 或 A100 80GB
视频任务比图片任务更容易吃满显存、硬盘和带宽。
如果只是短视频转码、字幕识别、视频增强,RTX 5090 32GB 很适合。
如果是 AI 视频生成、长视频处理、数字人批量合成,RTX 4090 48GB 会更稳。
如果要做更大规模训练或高强度商业化视频生成,建议评估 A100 80GB。
解决方案建议:
推荐:RTX 4090 48GB 或 A100 80GB
这类任务更看重显存容量和稳定性。
RTX 5090 32GB 可以做一些轻量 LoRA 训练、模型实验和小规模微调,但如果你频繁遇到 batch size 上不去、梯度检查点开了仍然爆显存,那 RTX 4090 48GB 会更合适。
如果是企业级训练、长时间训练、较大模型、多人实验环境,建议直接考虑 A100 80GB。
解决方案建议:
选 RTX 5090 32GB 还是 RTX 4090 48GB,可以按照下面这个流程判断:
如果能,优先考虑 RTX 5090 32GB。
如果不能,直接考虑 RTX 4090 48GB 或 A100 80GB。
如果是 API 服务、图片生成平台、企业 AI 工具,响应速度很重要,RTX 5090 32GB 更有优势。
如果是,RTX 4090 48GB 更稳。
如果是,需要重点关注:
GPU 服务器不是普通台式机,长期 7×24 小时运行时,散热和稳定性比跑一次 benchmark 更重要。
| 用户需求 | 推荐显卡 | 推荐理由 |
|---|---|---|
| AI 聊天 API、知识库问答 | RTX 5090 32GB | 模型可控时,推理速度和吞吐更重要 |
| Stable Diffusion 普通出图 | RTX 5090 32GB | 生成效率高,适合高频任务 |
| ComfyUI 复杂工作流 | RTX 4090 48GB | 大显存更适合多节点、多模型 |
| Flux / SDXL 高分辨率批量生成 | RTX 4090 48GB | 更不容易爆显存 |
| 视频转码、字幕识别、视频增强 | RTX 5090 32GB | 单卡处理速度更有优势 |
| AI 视频生成、数字人批量合成 | RTX 4090 48GB / A100 80GB | 显存压力更大 |
| LoRA 微调、小规模训练 | RTX 4090 48GB | 训练更依赖显存余量 |
| 企业级大模型训练 | A100 80GB | 数据中心卡更适合长时间训练 |
| 海外 AI SaaS 平台 | RTX 5090 32GB + 3G国际带宽 | 海外访问和 API 响应更重要 |
| 国内团队远程调用美国 GPU | RTX 5090/4090 + 1G三网直连回国 | 更重视中美访问链路体验 |
64GB 内存可以作为起步配置,但如果你跑的是多模型、多用户、多任务队列,建议升级到 128GB。
原因很简单:
GPU 显存负责模型计算,但 CPU 内存还要承担数据预处理、缓存、任务调度、Web 服务、数据库连接、日志处理等工作。内存太小,服务器整体响应会变慢。
AI 服务器经常需要加载大模型文件、读取素材、写入生成结果。如果硬盘速度太慢,会出现一种情况:GPU 很强,但模型加载慢、素材读取慢、任务切换慢。
建议:
美国 GPU 服务器常见两种带宽方向:
1G 三网直连回国:
适合国内团队远程调用、国内客户访问 AI 服务、中美之间频繁上传下载素材。
3G 国际带宽:
适合海外 AI SaaS、海外用户访问、国际素材分发、面向欧美市场的 AI 工具平台。
如果你的客户主要在国内,但你选择普通国际带宽,可能 GPU 算力很强,用户访问却觉得慢。
如果你的客户主要在海外,但你选择回国优化线路,可能带宽成本没有用在最关键的地方。
GPU 服务器部署 AI 应用时,常见问题不是硬件不够,而是环境混乱:
建议生产环境使用 Docker / Conda 隔离,并固定版本,例如:
nvidia-smi
nvcc -V
python -c "import torch; print(torch.__version__); print(torch.cuda.is_available())"
部署完成后,不要随意升级驱动、CUDA 和 PyTorch。AI 服务器最重要的是稳定运行,而不是每天追最新版本。
如果用一句话概括:
RTX 5090 32GB 美国 GPU 显卡服务器,适合模型能放进 32GB 显存、但对推理速度、生成效率、单卡吞吐要求更高的业务。
RTX 4090 48GB 更适合显存压力更大的场景,比如大模型、长上下文、高分辨率图片、复杂 ComfyUI 工作流、小规模训练和 LoRA 微调。
对于大多数 AI 应用部署来说,不要只问“哪张显卡更强”,而是要先问:
我的模型多大?
显存够不够?
用户在哪里?
是推理还是训练?
是自己用,还是做成商业 API?
是图片生成,还是视频生成?
是国内访问,还是海外访问?
如果模型能稳定放进 32GB 显存,RTX 5090 32GB 往往是更高效的选择。
如果经常爆显存、任务复杂、模型更大,RTX 4090 48GB 会更稳。
如果是企业级训练、大模型长期高负载运行,则建议进一步考虑 A100 80GB 这类更偏数据中心定位的 GPU 方案。


