

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


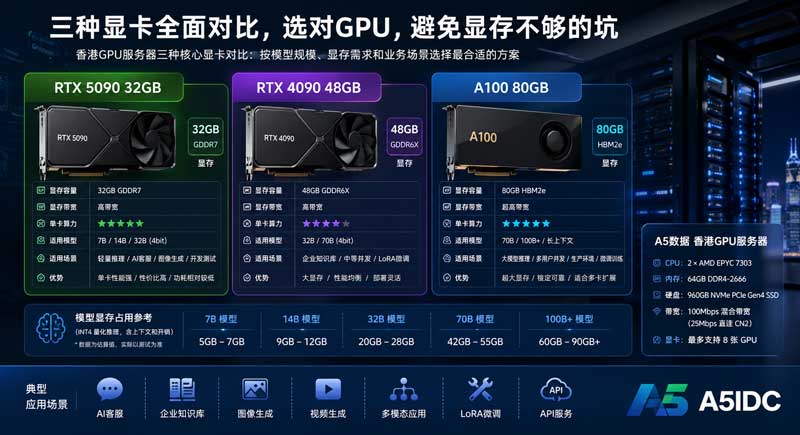
很多企业租香港GPU服务器时,第一反应是看显卡型号:RTX 4090、RTX 5090、A100,哪个性能强就选哪个。但真正跑大模型、AI客服、企业知识库、图像生成、推理服务时,最容易翻车的地方不是 CPU,也不是硬盘,而是显存不够。
很多人一开始觉得:“模型能加载起来就行。”结果真正上线后才发现:单用户可以跑,多用户一并发就爆显存;短上下文没问题,长上下文一开就 OOM;本地测试能跑,接入业务后响应慢、排队严重。本文就从真实部署角度,讲清楚买香港 GPU 服务器前需要避开的几个坑。
买普通服务器时,我们通常看 CPU、内存、硬盘、带宽。但买 GPU 服务器时,最关键的指标是:
显存大小决定模型能不能稳定跑,GPU算力决定跑得快不快。
很多用户容易把这两件事混在一起。比如 RTX 5090 的算力很强,但如果显存只有 32GB,它不一定适合跑更大的模型;A100 80GB 的单卡算力未必在所有场景都比消费级卡夸张,但它的大显存、稳定性和多卡扩展能力,反而更适合企业级大模型推理。
简单来说:
这就是为什么很多人前期省了一点 GPU 成本,后面却在迁移模型、重做架构、换服务器上花了更多时间。
本文以 A5 数据香港 GPU 显卡服务器为参考,适合企业知识库、AI客服、大模型推理、图像生成、LoRA 微调、跨境业务 AI 系统等场景。
| 项目 | 配置 |
|---|---|
| CPU | 2 × AMD EPYC 7303 |
| 内存 | 64GB DDR4-2666 |
| 硬盘 | 960GB NVMe PCIe Gen4 SSD |
| 带宽 | 100Mbps 混合带宽,含 25Mbps 直连 CN2 |
| GPU 选择 | RTX 4090 48GB vRAM / RTX 5090 32GB vRAM / A100 80GB vRAM |
| GPU 扩展 | 最大支持 8 张显卡 |
这套配置的核心特点是:CPU 核心数充足,NVMe 适合模型文件读取和向量库数据访问,香港 CN2 线路对国内访问更友好,适合需要中国大陆、东南亚、海外用户共同访问的 AI 服务。
很多用户会这样问:“我想跑 70B 模型,一张卡够不够?”
这个问题不能只看“70B”三个字,还要看模型精度、量化方式、上下文长度和并发数量。
一般可以粗略理解为:
| 模型规模 | FP16 推理显存 | INT8 / 8bit | INT4 / 4bit | 部署建议 |
|---|---|---|---|---|
| 7B | 14GB-16GB | 8GB-10GB | 5GB-7GB | 单卡轻松跑 |
| 14B | 28GB-32GB | 16GB-20GB | 9GB-12GB | 32GB 显存较合适 |
| 32B | 64GB 以上 | 35GB-45GB | 20GB-28GB | 建议 48GB 或 80GB |
| 70B | 140GB 以上 | 75GB-90GB | 42GB-55GB | 建议 A100 80GB 或多卡 |
| 100B+ | 200GB 以上 | 100GB+ | 60GB-90GB+ | 建议多卡并行 |
这里要注意:表里的数字多数只是模型权重占用,还没有把 KV Cache、batch size、上下文长度、框架开销、显卡碎片等因素完全算进去。
也就是说,70B 模型 4bit 量化后可能看起来 48GB 能塞进去,但只要上下文长度稍微拉高,或者多个用户同时提问,就很容易显存爆掉。
很多人在测试阶段只做了一件事:把模型加载起来,然后问一句话,能回答,就觉得配置够了。
但真实业务不是这样。
比如企业知识库 AI 客服,真实流程通常是:
这时显存占用会明显上涨,尤其是长上下文场景。
举个例子,一个 70B 模型在 4bit 量化后,单用户短问题可能还能跑;但如果你把上下文从 2K 拉到 8K,再同时支持 3-5 个用户请求,显存压力会马上上来。很多 OOM 问题不是启动时出现,而是在上线后高峰访问时出现。
所以选 GPU 服务器时,不要只问“能不能跑”,更要问:
能不能稳定跑?能不能多人同时跑?能不能带长上下文跑?能不能长期在线跑?
A5 数据香港 GPU 服务器最大支持 8 张显卡,这是很适合企业扩展的能力。但这里有一个常见误区:
不是插了 2 张 48GB 显卡,就自动变成一张 96GB 显卡。
多卡显存不能像内存条那样简单合并。大模型要使用多卡显存,通常需要 tensor parallel、pipeline parallel、DeepSpeed、vLLM、TensorRT-LLM、Transformers accelerate 等框架配合。
如果你的部署方式不支持多卡切分,模型还是只能放在单张显卡里。比如单卡 32GB 放不下的模型,不会因为服务器里还有另一张 32GB 显卡就自动成功。
多卡更适合这些场景:
| 多卡用途 | 说明 |
|---|---|
| 模型切分 | 把大模型权重拆到多张 GPU 上 |
| 并发扩容 | 多张卡分别承载不同请求 |
| 多模型部署 | 一张卡跑主模型,一张卡跑 embedding / rerank / 图像模型 |
| 微调训练 | 多卡加速 LoRA / QLoRA / 全参训练 |
| 高可用调度 | 避免单卡压力过大,方便业务分流 |
如果是企业正式部署,建议一开始就确认:你的推理框架是否支持多卡,模型是否适合张量并行,显卡之间通信是否会成为瓶颈。
RTX 5090 32GB 更适合对速度敏感、模型规模不是特别大的业务,比如:
它的优势是单卡性能强,适合跑中小模型。但 32GB 显存的限制也很明显:如果你想跑 70B,或者做长上下文、多并发,显存余量会比较紧张。
适合用户:
预算有限,但希望体验高性能 GPU 推理;模型主要集中在 7B、14B、32B 量化版本。
RTX 4090 48GB vRAM 的优势在于显存比 32GB 更宽裕,适合一些“32GB 能跑但不舒服”的场景。
它适合:
48GB 的好处是显存余量明显比 32GB 更大。比如同样跑 32B 模型,32GB 显存可能需要压缩上下文和 batch,而 48GB 可以保留更多空间给 KV Cache 和业务并发。
但它也不是万能的。如果你要长期稳定跑 70B,并且还要支持多人访问、长上下文、企业知识库检索,那么 48GB 依然可能偏紧。
适合用户:
希望单卡跑更大模型,预算又不想直接上 A100 的企业用户。
A100 80GB 的价值不只是显存大,更重要的是它更适合企业级 AI 部署。
它适合:
对于 70B 模型来说,A100 80GB 的单卡空间会舒服很多。即使用 4bit 或 8bit 量化,也能留出更多空间给上下文和并发,而不是刚好把模型塞进去。
如果业务是企业内部使用,用户量不大,RTX 4090 48GB 可能够用;但如果是对外提供 AI 服务,或者需要多部门、多客户调用,A100 80GB 更稳。
适合用户:
重视稳定性、长期运行、70B 模型、生产环境部署的企业客户。
如果只是内部员工查询文档,用户量不大,可以从 RTX 5090 32GB 或 RTX 4090 48GB 起步。模型建议选择 7B、14B 或 32B 量化版本。
推荐方案:
| 业务规模 | 推荐 GPU |
|---|---|
| 小型企业内部知识库 | RTX 5090 32GB |
| 中型知识库 + 较长文档检索 | RTX 4090 48GB |
| 多部门、多客户、生产环境 AI 客服 | A100 80GB |
| 高并发 AI API 服务 | 多卡 A100 80GB |
这里要特别注意:RAG 系统不是只跑一个大模型。它通常还需要 embedding 模型、rerank 模型、向量数据库、缓存服务和 Web API 服务。因此 CPU、内存和硬盘也不能太弱。
2 × AMD EPYC 7303 + 64GB DDR4 + 960GB NVMe 的组合,适合把推理服务、向量库、小型数据库、缓存服务放在同一台机器上。如果后续文档量很大,建议把向量库和数据库单独拆出去。
如果目标是 70B 模型,不建议只看“能不能加载”。更合理的判断方式是:
推荐方案:
| 部署目标 | 推荐配置 |
|---|---|
| 70B 低并发测试 | RTX 4090 48GB 可尝试 4bit |
| 70B 正式推理 | A100 80GB 更稳 |
| 70B 多用户访问 | 2 卡或多卡 A100 |
| 70B + 长上下文 + API 服务 | 多卡 A100 + vLLM / TensorRT-LLM |
如果预算允许,70B 生产环境建议优先考虑 A100 80GB。不要为了省成本把显存压到极限,否则后期优化空间很小。
微调比单纯推理更吃显存,尤其是 batch size、序列长度、优化器状态都会增加显存压力。
如果只是做 QLoRA 微调,RTX 4090 48GB 已经可以覆盖不少中小模型。如果要微调更大的模型,或者希望训练速度更稳定,建议选择 A100 80GB 或多卡方案。
建议:
Stable Diffusion、Flux、ComfyUI、视频生成、多模态模型也会吃显存,尤其是高分辨率、批量出图、多模型串联时。
如果只是单人使用或工作室内部使用,RTX 5090 32GB 就比较合适。如果要多人使用、排队出图、同时跑多个模型,建议 RTX 4090 48GB 起步。如果还要接入大语言模型、图像理解、多模态问答,则 A100 80GB 更适合做综合 AI 节点。
GPU 服务器不只是本地算力问题。如果你的用户在国内访问,服务器放在香港,线路就很关键。
A5 数据这套香港 GPU 服务器提供:
100Mbps 混合带宽,含 25Mbps 直连 CN2。
这类线路更适合:
不过也要明确一点:GPU 推理本身不是特别吃带宽,真正吃带宽的是大文件上传下载、模型文件同步、图片/视频生成结果传输、API 高频调用。
如果只是文本 AI客服,100Mbps 带宽基本够用;如果是图片生成、视频生成、批量文件处理,就要根据文件大小和用户并发来评估是否需要更高带宽。
不要一上来就问“哪张卡最好”,而是先确定你要跑什么模型:
模型规模确定后,显存选择才有依据。
同一个模型,不同精度显存差距很大。
比如 70B:
所以不要只问模型参数量,要同时问:你准备用什么精度跑?
很多用户忽略上下文长度。短对话和长文档问答完全不是一回事。
企业知识库经常会把多段文档塞进 Prompt,导致上下文变长。上下文越长,KV Cache 占用越高,显存压力越大。
如果你只是普通聊天,4K 上下文可能够用;如果要处理合同、技术文档、产品手册,8K、16K 甚至更长上下文才实用。
单用户测试成功,不代表 10 个用户同时访问也能成功。
建议上线前至少测试:
观察显存变化,再配合压测工具观察:
真正的上线判断标准不是“能回答”,而是“高峰时不崩”。
如果你未来可能从 1 张卡扩到 2 张、4 张、8 张,就要提前规划:
A5 数据香港 GPU 服务器最大支持 8 卡,这对后期扩展是有价值的。但前期架构如果没设计好,后面加卡也未必能马上提升效果。
比较稳的 AI 服务架构可以这样拆:
如果是企业知识库,可以进一步拆成:
这样做的好处是:后期某一部分压力大,可以单独扩容,而不是所有服务都挤在一个进程里。
如果是测试环境,可以选择刚好够的配置;但如果是生产环境,建议至少预留 20%-30% 显存余量。
简单建议如下:
| 需求 | 推荐选择 |
|---|---|
| 只跑 7B / 14B 模型 | RTX 5090 32GB |
| 跑 32B 模型,兼顾预算 | RTX 4090 48GB |
| 70B 量化推理测试 | RTX 4090 48GB 可尝试 |
| 70B 生产环境 | A100 80GB |
| 企业知识库 + AI客服 | RTX 4090 48GB / A100 80GB |
| 多用户 API 服务 | 多卡 A100 |
| LoRA 微调 | RTX 4090 48GB 起步 |
| 长上下文 + 高并发 | A100 80GB 或多卡 |
一句话总结:
小模型看性价比,中模型看显存余量,大模型看 A100,多用户业务看多卡扩展。
买香港 GPU 服务器,最怕的不是价格高,而是买错配置。很多用户前期只看显卡型号,觉得模型能跑起来就够了,结果真正上线后才发现:显存不够、上下文不够、并发不够、扩展也不方便。
如果只是测试 7B、14B 模型,RTX 5090 32GB 已经可以满足很多需求;如果要跑 32B 或更复杂的企业知识库,RTX 4090 48GB 会更稳;如果目标是 70B、大模型 API、企业级 AI客服或长期生产环境,A100 80GB 才是更可靠的选择。
A5 数据香港 GPU 显卡服务器采用 2 × AMD EPYC 7303、64GB DDR4、960GB NVMe PCIe Gen4 SSD,并提供 RTX 4090 48GB、RTX 5090 32GB、A100 80GB 多种显卡选择,最大支持 8 卡扩展。对于需要香港节点、CN2 线路、私有化大模型部署和企业 AI 应用的用户来说,关键不是盲目追求最高配置,而是先把模型规模、显存需求、并发量和后期扩展规划清楚。
真正稳定的 GPU 服务器方案,永远不是“刚好能跑”,而是“上线后还有余量”。


