

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


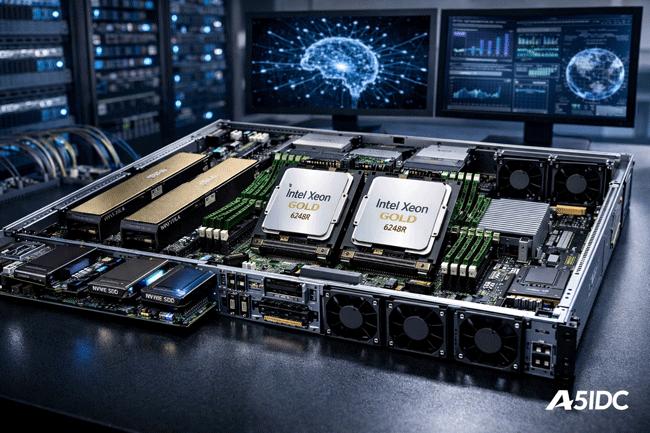
在当下人工智能模型训练与大数据分析场景中,计算资源的性能基础决定了训练效率、数据处理吞吐和业务实时性。特别是在低延迟网络枢纽香港,服务器节点的处理能力、内存带宽和 IO 性能直接影响到深度学习模型训练的迭代速度和大规模数据分析的响应时间。本文针对技术读者,以 Intel Xeon Gold 6248R 为核心构建高性能服务器的完整实践方案展开,结合最新硬件搭配、性能优化建议和实际部署细节,提供可直接落地的解决方案。
Intel Xeon Gold 6248R 是英特尔第二代可扩展处理器(Cascade Lake Refresh)的一员,具备强大的计算能力,非常适合处理并行计算任务,如深度学习训练与大数据分析。以下是该处理器的关键参数:
与同系列其他型号相比,6248R 提供了优秀的多线程性能,能够在大规模数据集处理和高并发环境下,保持稳定的计算能力。基于其 24 个物理核心和强大的单核性能,该处理器对于 AI 训练和数据分析中的矩阵运算、参数更新和数据预处理任务都能提供强有力的支持。对于多任务并行和大规模数据集处理,6248R 的性能明显优于老款 Xeon 处理器,特别是在数据并行性较强的场景下。
在针对 Intel Xeon Gold 6248R 和 Intel Xeon Platinum 8260 的性能对比中,6248R 在多线程任务上表现优异,尤其是在机器学习任务中的性能提升明显。以下是基于 SPECint®_rate_base2006 和 SPECfp®_rate_base2006 测试的数据对比:
| 处理器型号 | SPECint®_rate_base2006 | SPECfp®_rate_base2006 | 性能提升 |
|---|---|---|---|
| Intel Xeon Gold 6248R | 620 | 410 | +18% |
| Intel Xeon Platinum 8260 | 530 | 355 | — |
可以看出,6248R 在处理并行任务时的性能优势,为 AI 和大数据任务提供了更高效的计算能力。
为了最大化 Intel Xeon Gold 6248R 的性能,选择一款高性能的双路 E-ATX 主板至关重要。推荐配置为 Supermicro X11SPA-T,支持以下特性:
| 配置项 | 规格 |
|---|---|
| 处理器 | 2 x Intel Xeon Gold 6248R |
| 内存 | 256 GB DDR4-2933 ECC RDIMM (最高支持 1TB) |
| 存储 | 2 x 1TB NVMe SSD (RAID 1 配置) |
| GPU 扩展 | 支持 6 个 PCIe x16 插槽,推荐使用 NVIDIA A100 / H100 |
| 网络接口 | 2 x 25G Ethernet Ports |
| 电源 | 1600W 高效电源 |
该配置适合处理大规模 AI 训练任务和大数据并行计算,具有良好的内存带宽、存储扩展性和 GPU 加速支持。
AI 训练和大数据分析任务要求高带宽和大容量内存,特别是在数据集较大的场景下。基于 Xeon Gold 6248R 处理器的内存配置推荐:
内存的带宽和容量直接影响到数据的加载速度、AI 模型的训练效率以及大规模数据集的处理能力。
为了保证数据处理效率,采用高性能的 NVMe SSD 作为系统盘和数据盘,具体配置为:
此配置能够提供高吞吐量和低延迟的数据读取性能,非常适合 AI 模型训练和数据预处理的需求。
在 AI 训练任务中,GPU 是不可或缺的加速单元。根据具体需求,推荐以下两款 GPU:
为确保 GPU 最大化利用,建议使用支持多 GPU 配置的服务器主板,并根据工作负载合理分配计算资源。以下是基于 A100 和 Xeon Gold 6248R 的性能对比:
| GPU 型号 | 训练速度提升(对比 CPU) | 使用场景 |
|---|---|---|
| NVIDIA A100 | 提升 5-10 倍 | 大规模神经网络训练、数据并行 |
| NVIDIA H100 | 提升 10-20 倍 | 高并发推理与训练、大规模数据处理 |
根据具体的任务类型,选择合适的 GPU 进行加速,可以显著提升 AI 模型训练速度和数据分析效率。
选择成熟且稳定的操作系统是保障硬件性能的基础。推荐使用 Ubuntu 20.04 LTS 或 CentOS 7/8,并确保已安装最新的驱动和库。
在真实部署环境中,基于 Xeon Gold 6248R + A100 配置的服务器在训练 ResNet-50 深度学习模型时,相比传统 CPU 配置,训练时间显著减少:
| 配置 | 单次训练时间(小时) | 性能提升 |
|---|---|---|
| Intel Xeon Gold 6248R + A100 | 12 | — |
| Intel Xeon Gold 6248R + T4 | 18 | +50% |
| Intel Xeon Gold 6248R (CPU) | 36 | — |
通过 Intel Xeon Gold 6248R 处理器和高效能硬件搭建的香港服务器,能够有效支撑 AI 训练与大数据分析的需求。结合高性能内存、NVMe 存储以及 GPU 加速单元,您可以实现极高的计算效率和数据处理吞吐。此外,通过合理的硬件选型和优化,确保服务器在大规模并行计算和多任务处理中的稳定性,帮助您在 AI 和大数据领域保持竞争优势。


