

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


在高并发、多地域分布、实时性要求高的在线游戏场景下,合理的 CPU 与内存配置直接关系到游戏体验和服务器成本。本文从实时监控、资源预测、硬件特性、压测验证、成本效益分析、动态调度和失败案例等多个维度给出全面、可操作性的解决方案与参考方法。
高效识别性能瓶颈是优化硬件配置的第一步。常见监控指标包括 CPU 总体与 per‑core 使用率、内存使用量、帧处理延迟、网络吞吐量与丢包率等。
根据业内实践经验,核心监控指标应包括:
以下以 Prometheus + Grafana 为例说明如何采集 CPU/内存/网络等性能指标。
在 Grafana 中创建如下关键面板:
| 监控指标 | 可能原因 | 优化方向 |
|---|---|---|
| 单核高负载 | 游戏逻辑线程集中,CPU 频率或 IPC 不足 | 提升单核性能(更高频率、架构新一代 CPU) |
| 内存使用接近上限 | 资源密集型场景或缓存数据过多 | 增加内存容量、提升内存带宽 |
| 网络拥塞/丢包 | 带宽限制或队列阻塞 | 提升 NIC 带宽、优化网络控制策略 |
| 大量上下文切换 | 过多线程或虚拟化过度 | 降低线程冲突,适量减容容器/VM |
资源分配策略必须基于对玩家行为的精确分析,在峰值到来前预判资源需求。
分以下关键维度收集和建模:
可以利用最近的业务日志或专门埋点系统得到上述数据,并通过统计模型预测峰值负载。
定义:
则资源需求预测可以表示为:
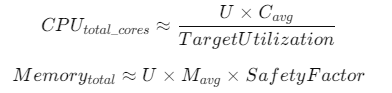
例如:
U = 3000 CCU,C_avg = 0.02 core/sec,目标 CPU 利用率 60%,得:
CPU_total_cores ≈ (3000 × 0.02) / 0.6 = 100 cores
这意味着至少需要 100 个逻辑核心用于负载平稳支撑。
不同类型游戏的资源需求有明显差异:
| 游戏类型 | CPU 特性 | 内存需求 | 典型优化重点 |
|---|---|---|---|
| FPS | 高频率、低延迟单线程负载 | 中等 | 高单核频率、低延迟内存 |
| MOBA | 多事件并发,分布式计算 | 高 | 高线程并发处理、足够内存缓存 |
| MMORPG | 大规模状态同步、高玩家密度 | 极高 | 海量内存、内存带宽、任务分片 |
FPS 游戏通常依赖高时钟频率和强单线程性能,用来快速响应玩家输入。MOBA 和 MMORPG 通常产生大量实体更新与状态同步,需要更高的并发线程和更大的内存容量。
选择 CPU 时需从 核心数、单核性能、缓存层次、线程技术 等维度权衡:
| 规格 | AMD EPYC 9654 | Intel Xeon Platinum 8490H |
|---|---|---|
| 核心/线程 | 96/192 | up to 144/288 |
| Memory Channels | 12 | 8 |
| PCIe Lanes | 128 | 112 |
| 适合场景 | 多线程密集 | 单线程优化场景 |
AMD EPYC 系列具有更多内存通道和 PCIe 通道,适合需要大量并行处理和 I/O 通道的场景;Intel Xeon 在传统的单线程任务和兼容性方面表现稳定。
内存配置不仅是容量,还包括 带宽、延迟、ECC 支持、通道数 等关键要素。
下面是不同游戏类型推荐内存容量范围参考:
| 游戏类型 | 推荐 RAM 容量* | 说明 |
|---|---|---|
| 小型独立游戏 | 64–128GB | 多实例部署 |
| 中型 MOBA | 128–256GB | 保证缓存和状态 |
| 大型 MMORPG | 256–512GB | 高频率状态存储 |
实际需根据峰值玩家数和游戏内状态复杂度调整。
DDR5 内存相比 DDR4 在数据速率上通常提高 30–50%,但延迟改进并不显著。在游戏服务器场景下:
合理配置内存通道数(例如 8–12 通道)可以显著提升并行访问带宽。
压测是验证硬件选型的关键步骤。典型压测流程:
微软官方建议先通过压力测试建立每台节点支持的最大 CCU 并保持目标 Tick Rate(TPS)阀值。
可使用开源工具如 Locust, JMeter, 或自定义模拟客户端脚本。
将模拟大量客户端访问并收集服务器响应延迟与错误率。
| CPU & RAM 配置 | 最大 CCU | P95 延迟 (ms) | 内存占用 (%) | CPU 负载 (%) |
|---|---|---|---|---|
| 64C / 256GB | 1200 | 85 | 70 | 65 |
| 96C / 384GB | 1800 | 62 | 75 | 55 |
| 128C / 512GB | 2400 | 48 | 68 | 50 |
通过对比不同硬件,得出最优配置。
在成本约束下,合理配置能够有效减少过度投入。
例如,AMD EPYC 系列在每核成本方面通常优于同级 Xeon,这在长期 TCO 中体现更高性价比。
容器化和虚拟化技术为游戏服务器带来微服务架构与弹性资源调度能力。
Vertical Pod Autoscaler 可以自动根据负载调整 Pod 的 CPU/内存请求。
此配置让 Kubernetes 根据实际监控动态调整资源请求,避免浪费。
从架构设计到运营监控是一个闭环。
建议结合 Prometheus、ELK、AIOps 等组合,实现从硬件到用户体验的 全链路监控体系。
症状:游戏在高峰期 TPS 下降,延迟突然飙升。
分析:监控显示某个逻辑线程 CPU 使用 98% 持续饱和。
解决:提升 CPU 主频,从 2.4GHz 升级到 3.2GHz,优化游戏逻辑以平衡线程分布。
症状:服务器运行一段时间后出现 OOM 强制重启。
分析:监控显示内存增长趋势持续攀升,超过了物理内存阈值。
解决:增加物理内存容量、启用内存污点检测、重构代码以修复内存泄漏。
确定最优 CPU 与内存配置不是简单选硬件,更是一个 基于数据、监控、压测、资源预测和动态调度的系统工程。通过实施完善的监控体系、合理预测资源需求、精细化压测验证以及结合容器化调度机制,可以确保在性能保证和成本控制之间获得最佳平衡。


