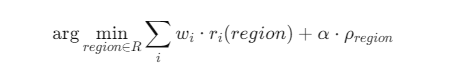香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


机柜与服务器清单(实配样例)
| 角色 | 型号/CPU | 内存 | 本地盘 | 网卡 | 用途 |
|---|---|---|---|---|---|
| Gateway/Edge 节点 x4 | AMD EPYC 7543P (32C) | 128GB | 2× 3.84TB U.2 NVMe | 2×25GbE SFP28 | Envoy/QUIC 入口、HTTP2/gRPC LB |
| Stateless 微服务节点 x8 | EPYC 7452 (32C) | 256GB | 2× 1.92TB NVMe | 2×25GbE | 匹配/队伍/会话/支付等 |
| Stateful 节点 x6 | Xeon Silver 4314 (16C) | 256GB | 4× 3.84TB NVMe | 2×25GbE | Redis Cluster、TiDB/PD/TiKV、NATS |
| 游戏实例节点 x12 | EPYC 7F52 (16C@高频) | 128GB | 1× 1.92TB NVMe | 2×25GbE | 地图/战斗服(CPU频率敏感) |
| 观测/日志 x2 | Xeon 4210 | 128GB | 2× 7.68TB NVMe | 2×10GbE | Prometheus、Loki、ClickHouse |
yum install -y https://www.elrepo.org/elrepo-release-7.el7.elrepo.noarch.rpm
yum --enablerepo=elrepo-kernel install -y kernel-ml kernel-ml-devel
grub2-set-default 0 && rebootcat >/etc/sysctl.d/99-game-lowlatency.conf <<'EOF'
net.core.default_qdisc=fq
net.ipv4.tcp_congestion_control=bbr
net.core.rmem_max=134217728
net.core.wmem_max=134217728
net.ipv4.udp_mem=134217728 134217728 268435456
net.ipv4.udp_rmem_min=131072
net.ipv4.udp_wmem_min=131072
net.ipv4.tcp_fastopen=3
net.ipv4.tcp_tw_reuse=1
net.ipv4.tcp_max_syn_backlog=4096
net.ipv4.ip_local_port_range=10000 65000
net.netfilter.nf_conntrack_max=2621440
net.netfilter.nf_conntrack_udp_timeout=60
net.netfilter.nf_conntrack_udp_timeout_stream=180
fs.file-max=10485760
EOF
sysctl --system# 环形缓冲 & Offload
ethtool -G eth0 rx 4096 tx 4096
ethtool -K eth0 tso on gso on gro on rx on tx on
# RPS/RFS 配置略,核心思路:将网卡队列与 CPU NUMA 对齐,关键网关节点关闭 irqbalance,手动绑核。yum install -y yum-utils device-mapper-persistent-data lvm2
yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo
yum install -y containerd.io
mkdir -p /etc/containerd && containerd config default >/etc/containerd/config.toml
sed -i 's/SystemdCgroup = false/SystemdCgroup = true/' /etc/containerd/config.toml
systemctl enable --now containerd# kubeadm-config.yaml
apiVersion: kubeadm.k8s.io/v1beta3
kind: ClusterConfiguration
kubernetesVersion: v1.28.7
networking:
podSubnet: "10.244.0.0/16"
serviceSubnet: "10.96.0.0/12"
controllerManager:
extraArgs:
bind-address: "0.0.0.0"
scheduler:
extraArgs:
bind-address: "0.0.0.0"
---
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
eventRecordQPS: 0
systemReserved:
cpu: "500m"
kubeReserved:
cpu: "1000m"
kubeadm init --config kubeadm-config.yaml
kubectl taint nodes --all node-role.kubernetes.io/control-plane-helm repo add cilium https://helm.cilium.io
helm install cilium cilium/cilium --version 1.15.5 \
--namespace kube-system \
--set tunnel=disabled \
--set ipv4NativeRoutingCIDR=10.244.0.0/16 \
--set bpf.masquerade=true \
--set mtu=1450# metallb ConfigMap 摘要
address-pools:
- name: prod-pool
protocol: bgp
addresses: ["203.0.113.100-203.0.113.120"]# envoy.yaml(片段)
static_resources:
listeners:
- name: quic_ingress
address: { socket_address: { address: 0.0.0.0, port_value: 443 } }
udp_listener_config: { quic_options: { quic_protocol_options: {} } }
filter_chains:
- filters:
- name: envoy.filters.network.quic_server
typed_config:
"@type": type.googleapis.com/envoy.extensions.quic.server.v3.QuicServerCodecConfig
upstream_protocols:
- HTTP2
- name: envoy.filters.network.http_connection_manager
typed_config:
"@type": type.googleapis.com/envoy.extensions.filters.network.http_connection_manager.v3.HttpConnectionManager
http2_protocol_options: { max_concurrent_streams: 100000 }
route_config:
virtual_hosts:
- name: game
domains: ["game.example.hk"]
routes:
- match: { prefix: "/party.v1.Party" }
route: { cluster: party-svc }
- match: { prefix: "/matchmaking.v1" }
route: { cluster: mm-svc }
clusters:
- name: party-svc
type: EDS
connect_timeout: 0.2s
http2_protocol_options: {}
lb_policy: LEAST_REQUEST
- name: mm-svc
type: EDS
connect_timeout: 0.2s
http2_protocol_options: {}
lb_policy: LEAST_REQUESTGo 版 party-svc 核心片段(gRPC)
// party.proto 省略
type PartyService struct {
redis *redis.ClusterClient
nats *nats.Conn
}
func (p *PartyService) CreateOrJoin(ctx context.Context, req *pb.JoinReq) (*pb.JoinResp, error) {
// 1. 汇总每个成员的 RTT 探针(由接入网关持续上报)
rtts := fetchRTTs(ctx, req.MemberIDs)
// 2. 计算最优 region
best, score := selectRegion(rtts, currentLoad())
// 3. 在 best region 的 Redis hash 写入队伍锚定
key := fmt.Sprintf("party:%s", req.PartyId)
err := p.redis.HSet(ctx, key, "region", best, "members", strings.Join(req.MemberIDs, ",")).Err()
if err != nil { return nil, status.Error(codes.Internal, err.Error()) }
p.redis.Expire(ctx, key, 30*time.Minute)
// 4. 通知 presence 进行就地迁移
notifyPresence(p.nats, req.PartyId, best)
return &pb.JoinResp{Region: best, Score: score}, nil
}apiVersion: apps/v1
kind: Deployment
metadata: { name: party-svc, labels: { app: party } }
spec:
replicas: 8
selector: { matchLabels: { app: party } }
template:
metadata:
labels: { app: party, tier: stateless }
annotations:
linkerd.io/inject: enabled
spec:
containers:
- name: party
image: registry.example.com/game/party:1.12.3
ports: [{containerPort: 8080, name: grpc}]
resources:
requests: { cpu: "500m", memory: "512Mi" }
limits: { cpu: "2", memory: "2Gi" }
env:
- { name: REDIS_ADDRS, value: "redis-0,redis-1,..." }
topologySpreadConstraints:
- maxSkew: 1
topologyKey: "topology.kubernetes.io/zone"
whenUnsatisfiable: DoNotSchedule
labelSelector: { matchLabels: { app: party } }
affinity:
podAntiAffinity:
requiredDuringSchedulingIgnoredDuringExecution:
- labelSelector: { matchExpressions: [{key: app, operator: In, values: [party]}]}
topologyKey: "kubernetes.io/hostname"- record: svc:grpc_latency_p99:rate5m
expr: histogram_quantile(0.99, sum(rate(grpc_server_handling_seconds_bucket[5m])) by (le, service))
- alert: CrossRegionPartyLatHigh
expr: svc:grpc_latency_p99:rate5m{service="party-svc"} > 1.5
for: 10m
labels: { severity: page }
annotations: { summary: "跨区组队P99 > 1.5s" }| 指标 | 改造前 | 改造后 | 备注 |
|---|---|---|---|
| 组队成功平均耗时 | 2.1s | 780ms | 入口 QUIC + 锚定 |
| 组队 P95 | 4.8s | 1.42s | 队伍状态局部化 |
| 匹配排队掉线率 | 2.3% | 0.6% | Presence 重试与幂等 |
| HK ↔ 广州 RTT(中位) | 38ms | 35ms | 路由与拥塞控制 |
| HK ↔ 新加坡 RTT(中位) | 43ms | 41ms | BBR + 拥塞规避 |
Redis P99 GET |
3.6ms | 1.8ms | Redis shard 热点打散 |
| Envoy 入站 P99 | 12ms | 5ms | HTTP/2 直连上游 |