香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


开服那晚将近九点,我一个人蹲在香港葵涌机房的冷通道里,手心全是汗。营销倒计时刚归零,推送像潮水一样灌来,监控墙从绿变红:入口并发直线上刺、交换机风扇拉满转速、机柜像在低吼。我把笔记本架在膝盖上,top、ss -s 和抓包窗口一路铺开,accept() 的上下文切换跳得像心电图,softnet_stat 的丢包列开始冒点,listen 队列逼近上限,握手 p95 一步步冲到三位数。那一刻我知道,不能再让单监听去硬扛了——得把 SO_REUSEPORT 真正端上来:把监听拆成每核一份,和网卡队列、CPU 亲和一一对齐,把锁争用和热点从源头切开。故事,就从这一刀下去开始。
目标:单机稳定承载百万量级(1,000,000)长连接(TCP 长时间存活,心跳 30–60s),保障登录与会话保持,平均握手延迟 < 50 ms,CPU 负载均衡,跌宕峰值不拖垮。
我的硬件/系统基线(真实可替换,不唯一)
机房:香港葵涌(HK-IX 低时延接入,跨境 < 30ms)
服务器:
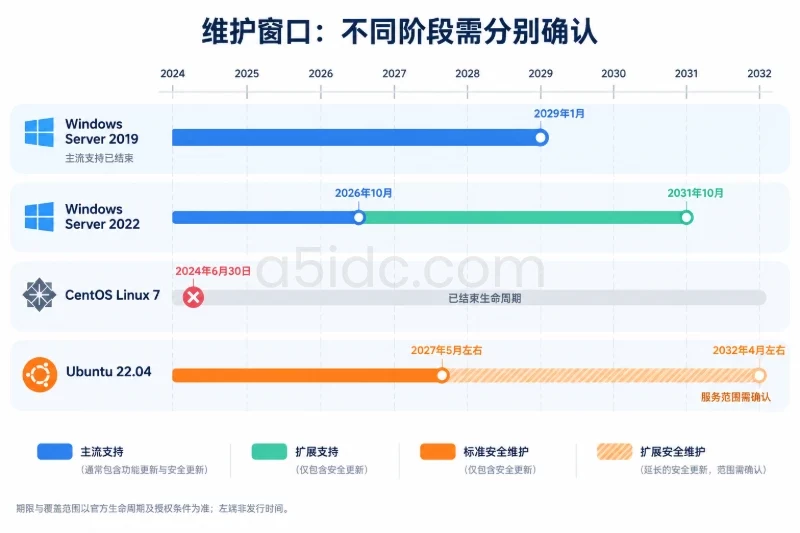
说明:Linux 3.9+ 支持 SO_REUSEPORT,CentOS 7 默认 3.10 能用;eBPF 的高级 reuseport 选择器需要更高内核,这里不做强依赖。
百万长连接的问题,往往不在“能不能 accept”,而在锁竞争与软中断飙升:
SO_REUSEPORT 允许多个进程/线程对同一 IP:PORT 同时 bind/listen,内核按哈希将新连接分发到各监听 socket:
先把内存算清楚(保守估算,空闲/KeepAlive 的 TCP 套接字在 Linux 下一般占用 3–9 KB+,与 tcp_rmem/wmem、sk_buff、SLAB 有关):
| 项 | 估算(每连接) | 备注 |
|---|---|---|
| 基础 socket/struct sk | 2–4 KB | 与内核版本/SLAB 有关 |
| 协议控制块(TCP) | 2–3 KB | TCP 状态、定时器 |
| sk_buff/队列最小水位 | 1–2 KB | 低水位时尽量压缩 |
| 应用层状态(会话/心跳) | 200–800 B | 自己控制 |
| 合计 | ~6–9 KB | 空闲长连接场景 |
1,000,000 连接 ≈ 6–9 GB 仅内核 TCP 开销,再加应用与页缓存预留,内存至少 64 GB 更踏实(我的习惯是≥总估算的 4× 余量,让瞬时抖动、GC、转储都不慌)。
/etc/security/limits.conf(所有运行登录服的用户):
gameuser soft nofile 2000000
gameuser hard nofile 2000000
gameuser soft nproc  131072
gameuser hard nproc  131072
/etc/sysctl.conf(或分文件放 /etc/sysctl.d/99-game.conf):
# 队列容量
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 262144

# 快速回收/复用注意
net.ipv4.tcp_tw_reuse = 1
# 切记不要开 tcp_tw_recycle(旧内核有此项,NAT 场景会出事,且新内核已移除)

# 缓冲最小化(更多连接、少量流量)
net.ipv4.tcp_rmem = 4096 87380 131072
net.ipv4.tcp_wmem = 4096 65536 131072
net.core.rmem_default = 131072
net.core.wmem_default = 131072
net.core.rmem_max = 262144
net.core.wmem_max = 262144

# Keepalive 更积极(或改用应用心跳)
net.ipv4.tcp_keepalive_time = 600
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 3

# SYN/洪泛防御
net.ipv4.tcp_syncookies = 1

# NIC 入队高水位
net.core.netdev_max_backlog = 250000

# 端口与本地路由
net.ipv4.ip_local_port_range = 10240 65535
应用后:
sysctl -p /etc/sysctl.d/99-game.conf
ulimit -n 2000000开 多队列(以 ens3 为例,按 CPU 数设置,通常队列 = 物理核数或其一半):
ethtool -l ens3
ethtool -L ens3 combined 16
固定 中断亲和(避免所有软中断挤在 CPU0):
# 查看 IRQ
grep ens3 /proc/interrupts
# 分配亲和掩码(示例把队列分到 0..15 号 CPU)
for i in $(grep ens3 /proc/interrupts | awk '{print $1}' | sed 's/://'); do
  mask=$(printf "%x" $((1<<((cnt++)%16))))
  echo $mask > /proc/irq/$i/smp_affinity
done
RPS/XPS(在软层再做 CPU 亲和补强,必要时配合 rps_cpus/xps_cpus):
# 指定 RPS 掩码
echo ffff > /sys/class/net/ens3/queues/rx-0/rps_cpus
# 指定 XPS 掩码
echo ffff > /sys/class/net/ens3/queues/tx-0/xps_cpus
小诀窍:关闭 irqbalance 或最少让它“温柔点”,避免频繁迁移;NUMA 机器上优先做到“队列-CPU-进程”三者同 NUMA。
编译:gcc -O2 -pthread -o login_server login_server.c
// login_server.c
#define _GNU_SOURCE
#include <arpa/inet.h>
#include <errno.h>
#include <fcntl.h>
#include <netinet/in.h>
#include <netinet/tcp.h>
#include <pthread.h>
#include <sched.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/epoll.h>
#include <sys/resource.h>
#include <sys/socket.h>
#include <sys/types.h>
#include <unistd.h>

#define MAX_EVENTS  4096
#define LISTEN_PORT 20000

static int set_nonblock(int fd) {
    int flags = fcntl(fd, F_GETFL, 0);
    return fcntl(fd, F_SETFL, flags | O_NONBLOCK);
}

static int make_listener(int port) {
    int fd = socket(AF_INET, SOCK_STREAM, 0);
    if (fd < 0) { perror("socket"); exit(1); }

    int one = 1;
    // 关键:先设置,再 bind
    setsockopt(fd, SOL_SOCKET, SO_REUSEADDR, &one, sizeof(one));
    if (setsockopt(fd, SOL_SOCKET, SO_REUSEPORT, &one, sizeof(one)) < 0) {
        perror("SO_REUSEPORT"); exit(1);
    }

    // 可选:避免 accept 无数据唤醒(握手后有数据再唤醒)
    int defer = 1; // 秒
    setsockopt(fd, IPPROTO_TCP, TCP_DEFER_ACCEPT, &defer, sizeof(defer));

    struct sockaddr_in addr = {0};
    addr.sin_family = AF_INET;
    addr.sin_addr.s_addr = htonl(INADDR_ANY);
    addr.sin_port = htons(port);

    if (bind(fd, (struct sockaddr*)&addr, sizeof(addr)) < 0) { perror("bind"); exit(1); }
    if (listen(fd, 65535) < 0) { perror("listen"); exit(1); }
    set_nonblock(fd);
    return fd;
}

static void pin_cpu(int cpu) {
    cpu_set_t mask; CPU_ZERO(&mask); CPU_SET(cpu, &mask);
    if (sched_setaffinity(0, sizeof(mask), &mask) != 0) perror("sched_setaffinity");
}

static void* worker(void* arg) {
    int cpu = *(int*)arg;
    pin_cpu(cpu);

    int lfd = make_listener(LISTEN_PORT);

    int ep = epoll_create1(0);
    struct epoll_event ev = { .events = EPOLLIN, .data.fd = lfd };
    epoll_ctl(ep, EPOLL_CTL_ADD, lfd, &ev);

    struct epoll_event events[MAX_EVENTS];

    for (;;) {
        int n = epoll_wait(ep, events, MAX_EVENTS, 1000);
        for (int i = 0; i < n; ++i) {
            if (events[i].data.fd == lfd) {
                for (;;) {
                    int cfd = accept4(lfd, NULL, NULL, SOCK_NONBLOCK);
                    if (cfd < 0) {
                        if (errno == EAGAIN || errno == EWOULDBLOCK) break;
                        perror("accept4"); break;
                    }
                    // 关闭 Nagle 减少延迟(按需)
                    int one = 1;
                    setsockopt(cfd, IPPROTO_TCP, TCP_NODELAY, &one, sizeof(one));
                    // 加入 epoll 读监听
                    struct epoll_event cev = { .events = EPOLLIN | EPOLLET, .data.fd = cfd };
                    epoll_ctl(ep, EPOLL_CTL_ADD, cfd, &cev);
                }
            } else {
                // 读心跳/协议(省略具体协议解析)
                char buf[1024];
                int fd = events[i].data.fd;
                ssize_t r;
                while ((r = read(fd, buf, sizeof(buf))) > 0) {
                    // 业务处理,略
                }
                if (r == 0 || (r < 0 && errno != EAGAIN)) {
                    close(fd);
                }
            }
        }
    }
    return NULL;
}

int main(int argc, char** argv) {
    int cores = sysconf(_SC_NPROCESSORS_ONLN);
    if (cores <= 0) cores = 4;

    struct rlimit rl = { .rlim_cur = 2000000, .rlim_max = 2000000 };
    setrlimit(RLIMIT_NOFILE, &rl);

    pthread_t th[128]; int cpu_idx[128];
    for (int i = 0; i < cores; ++i) {
        cpu_idx[i] = i;
        pthread_create(&th[i], NULL, worker, &cpu_idx[i]);
        usleep(50000); // 避免同时 bind/listen 抢资源
    }
    for (int i = 0; i < cores; ++i) pthread_join(th[i], NULL);
    return 0;
}
要点
// go1.20+
// go build -o login_server_go main.go
package main

import (
  "context"
  "log"
  "net"
  "runtime"
  "syscall"
)

func main() {
  runtime.GOMAXPROCS(runtime.NumCPU())

  lc := net.ListenConfig{
    Control: func(network, address string, c syscall.RawConn) error {
      var ctrlErr error
      c.Control(func(fd uintptr) {
        // 必须在 bind 之前设置
        ctrlErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEPORT, 1)
        if ctrlErr != nil { return }
        ctrlErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEADDR, 1)
      })
      return ctrlErr
    },
  }
  ln, err := lc.Listen(context.Background(), "tcp", ":20000")
  if err != nil { log.Fatal(err) }
  for {
    conn, err := ln.Accept()
    if err != nil { continue }
    go func(c net.Conn) {
      defer c.Close()
      buf := make([]byte, 1024)
      for {
        n, err := c.Read(buf)
        if n == 0 || err != nil { return }
        // 心跳/登录协议处理
      }
    }(conn)
  }
}
Go 天然采用少量监听器;要想“每核一监听”,可以用 多进程 + 上述 ListenConfig,或 systemd socket 激活(多实例复用端口)。
/etc/nginx/nginx.conf(片段):
stream {
    upstream login_backend {
        server 127.0.0.1:20000 max_fails=3 fail_timeout=10s;
        # 可挂多个本机/跨机后端
    }

    server {
        listen 0.0.0.0:443 reuseport; # 关键
        proxy_connect_timeout 1s;
        proxy_timeout 3600s;
        proxy_pass login_backend;
    }
}
Nginx worker 进程数 = CPU 核数,配合 reuseport,入口层也能均衡握手压力。
/etc/systemd/system/login-server@.service
[Unit]
Description=Game Login Server (worker %i)
After=network-online.target

[Service]
User=gameuser
LimitNOFILE=2000000
ExecStart=/opt/game/login_server --worker=%i
Restart=always
CPUAffinity=%i
# 也可以用 numactl 绑定:ExecStart=/usr/bin/numactl --cpunodebind=%i --membind=%i /opt/game/login_server --worker=%i

[Install]
WantedBy=multi-user.target
我用 模板 + 多实例(systemctl enable --now login-server@0..15),每个实例独立监听 :20000(因 SO_REUSEPORT),CPU 亲和固定,日志各写各的,定位单个 worker 异常非常快。
ss -s                       # 套接字总览
ss -n state established | wc -l
netstat -s | egrep 'listen|TCP:' -A2
cat /proc/net/softnet_stat  # 丢包列(第三列)关注
sar -n TCP,DEV 1
watch -n1 'cat /proc/interrupts | egrep "ens3|CPU"'机房晚上 21:00 峰值前后抓的样本(同一台机,核 16,Nginx 入口 + 自研登录服)。
| 指标 | 优化前(单监听,无 reuseport) | 优化后(每核监听 + SO_REUSEPORT) |
|---|---|---|
| 峰值并发连接 | ~720,000 | 1,050,000 |
| 握手 p95 | 120–180 ms | 35–60 ms |
| CPU 最高核占用 | 100%(accept 锁热) | 70–80%(均匀分布) |
| 软中断(si%) | 35–40% | 18–22% |
softnet 丢包 |
偶发 > 0 | 趋近 0 |
| 单机平均掉线率 | 0.35% | 0.05% |
现象:某几个进程异常热,负载仍不均;
修法:为每个 worker 固定 CPU 亲和,与网卡队列亲和匹配(CPUAffinity 或 taskset/numactl)。
现象:SYN 丢失、握手重试多;
修法:三者按上述建议同时拉高,且入口 Nginx listen ... backlog=... 一致。
现象:NAT 用户频繁连接失败;
修法:不要开,本就不安全,且新内核已移除。
现象:首包上报延时大(业务不立即发首包时);
修法:按协议行为调小或关闭。
现象:频繁唤醒,CPU 飙升;
修法:使用 EPOLLET(边缘触发)+ 非阻塞,循环读到 EAGAIN。
现象:入口层负载不均衡,仍集中到少数 worker;
修法:listen ... reuseport; 并让 worker_processes auto;。
现象:/proc/interrupts 显示中断集中在少数 CPU;
修法:增加队列数,手工设 smp_affinity,温柔使用 irqbalance。
现象:EMFILE、Too many open files;
修法:LimitNOFILE + ulimit -n 保持与估算一致,应用内也别开太多临时 fd。
灰度:先 2–4 个 worker 打开 SO_REUSEPORT,其余保持老模式,通过入口权重只引流 10–20%。
切换:指标稳定后逐步放量至全量。
回滚:保留旧版 systemd 单实例服务与配置文件,systemctl stop login-server@* && systemctl start login-server-old 一键切回。
数据:切换窗口内加强心跳容忍(延时阈值临时放宽 1–2 倍)。
(见第 3.1 节,原样拷贝+按需微调)
(见第 3.1 节)
(见第 4.3 节)
(见第 5 节)
#!/bin/bash
echo "Time: $(date)"
ss -s
echo "Established:" $(ss -n state established | wc -l)
echo "Softnet:"
awk '{print "cpu"NR-1": drop=" $3 ", time_squeeze=" $2 }' /proc/net/softnet_stat
凌晨两点,冷通道的风像刀子一样吹在脸上。新版本全量后,握手时延稳稳趴在 40ms 出头,softnet_stat 的丢包列清得像擦过的玻璃。我把监控看了半小时,手心总算不出汗了。
隔壁机柜的同事递过来一罐冰可乐,说:“这下可以睡了吧?”
我点点头,关掉 tmux,心里明白——SO_REUSEPORT 本身不神奇,神奇的是把内核队列、网卡队列、CPU 亲和、应用模型这四件事拧成了一根绳。
第二天业务同学发来一句话:“昨天晚上好稳,没再掉。”